50 agents pour une seule personne : derrière le post viral, la vraie méthode de Lauren Tan
50 agents pour une seule personne : derrière le post viral, la vraie méthode de Lauren Tan
Source: Andy L (@AndyL5cc) — post du 27 octobre 2026
« 太夸张了 ! » — « c’est exagéré ! » Le post ouvre sur un organigramme qui fait rêver tous ceux qui cherchent encore comment « scaler » leurs agents : 1 agent chef d’état-major, 3 agents chefs de projet, 40 et quelques agents employés qui exécutent toute la nuit. Une personne, le travail de vingt ingénieurs. Et, en prime, l’affirmation que 97 % des ingénieurs de SpaceXAI travailleraient déjà comme ça.
Le post a fait 793 000 vues en une journée, pour 9 300 likes et 1 500 partages. Il annonce aussi une « formation de 60 minutes » offerte, alors qu’« avant, certains la vendaient 5 000 dollars ».
La vidéo jointe existe vraiment : 57 minutes, en anglais, avec Lauren Tan, « Software engineer | SpaceXAI ». Elle y raconte quelque chose de moins spectaculaire et de beaucoup plus reproductible : comment elle est passée de « je vérifie chaque sortie de mes agents » à « je me réveille avec 20 pull requests déjà fusionnées ».
Ce que le post promet, ce que la vidéo dit
Il faut être clair sur un point : les chiffres du post ne sont pas dans la vidéo. On n’y trouve ni organigramme à 50 agents, ni « 97 % des ingénieurs », ni tutoriel d’installation. C’est une conversation, animée par Colin, avec une ingénieure qui vient de passer cinq mois à se construire un environnement de travail digne de ce nom.
Ce qu’elle dit, elle, est vérifiable dans l’enregistrement :
- 1 000 PR livrées le mois précédent, et déjà près de 800 le 12 du mois en cours ;
- 20 PR fusionnées par ses agents pendant la nuit, qu’elle n’a plus qu’à relire sur
main, une fois en production ; - plus de 600 PR pour refactorer GrokBot vers sa nouvelle architecture ;
- et l’aveu qui va avec : « je ne regarde plus vraiment le code ».
Ce dernier chiffre mérite d’être lu correctement. Une PR chez elle va de 50 lignes à un millier, parfois surtout des suppressions. 1 000 PR ne veulent pas dire 1 000 fonctionnalités, ni un « ×20 » de productivité : le volume dit seulement à quelle fréquence elle peut désormais accepter du code sans le lire ligne à ligne.
Le parcours, lui, est réel : passée par Meta (compilateur React) et par Netflix (tech lead puis engineering manager), Lauren Tan a rejoint Cursor il y a cinq mois. Cursor a été racheté par SpaceX en août 2026 et son équipe a rejoint SpaceXAI, où elle travaille sur GrokBot, l’application d’agents à laquelle ressemble de plus en plus le « futur du travail » vendu par les réseaux sociaux.
« Vous êtes le vérificateur »
Tout commence par un échec banal. À son arrivée, elle doit optimiser les performances de la fenêtre d’agent de Cursor, qui doit sortir une semaine plus tard. Le code React lui est familier, la base de code pas du tout. Alors elle fait ce que tout le monde fait : elle ouvre les DevTools, prend une trace CPU, colle la capture au modèle. Et l’agent lui répond, très sûr de lui, que le problème vient de là. Elle corrige. Le problème reste.
« Si vous n’avez pas de compétence de vérification, c’est vous le vérificateur. C’est vous le goulot d’étranglement. »
C’est le pivot de toute la démonstration. Écrire du code, un agent sait le faire. Conduire l’application et constater le résultat, non : c’est encore l’humain qui ouvre le build de dev, repère la régression, copie la capture d’écran et la remonte. Le débit de l’ensemble ne dépend donc pas du nombre d’agents lancés, mais du nombre de fois où un humain peut aller vérifier.
D’où sa première compétence maison, control-glass : elle apprend à l’agent à lancer l’application, à piloter l’interface via le protocole DevTools de Chrome, à prendre des traces CPU, des instantanés mémoire, à ouvrir un simulateur iOS. Le code de cette compétence n’a rien d’exceptionnel, dit-elle — un agent peut l’écrire. Ce qui compte, c’est ce qu’elle change dans la boucle : l’agent peut désormais constater lui-même qu’il a réparé, ou non, ce qu’il prétendait réparer.
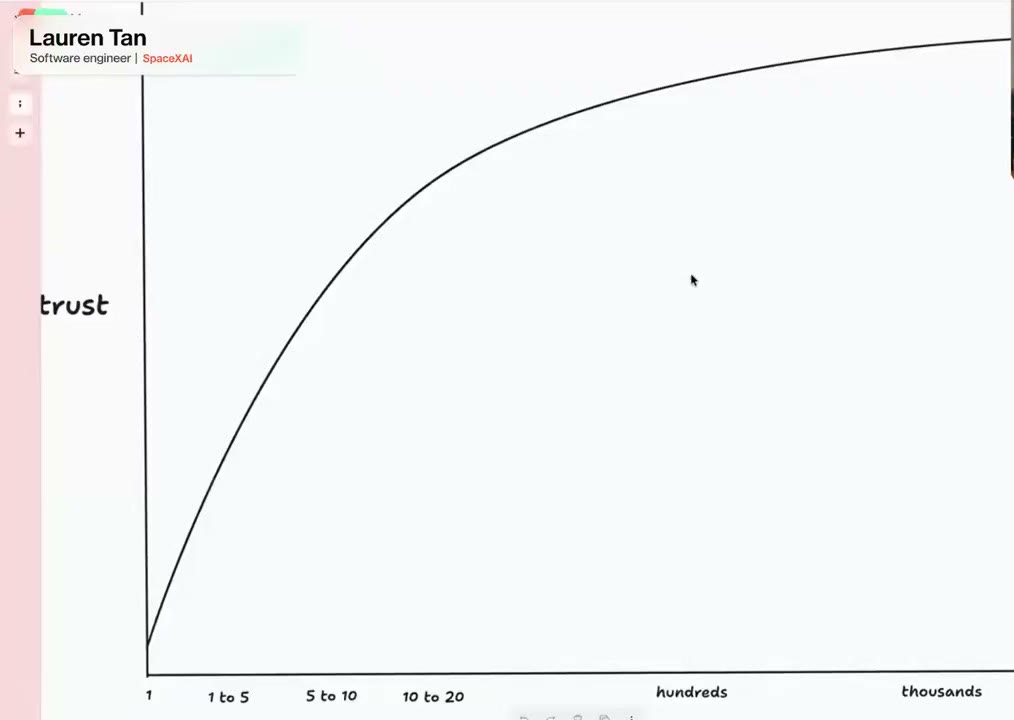
Elle en tire une courbe dessinée à main levée, qu’elle assume « pas très scientifique » : en abscisse le nombre d’agents qu’elle peut gérer, en ordonnée sa confiance. On n’y monte pas par un escalier magique. Et surtout, on ne saute pas d’étape :
« Vous ne pouvez pas spawner 100 agents quand vous ne faites pas confiance au résultat d’un seul. Vous allez juste brûler beaucoup de tokens. »
Une carte des fonctionnalités, pas un prompt magique
Deuxième mur, une fois l’agent capable de piloter l’application : il ne sait pas où sont les choses. Un rapport de bug arrive dans un canal Slack, souvent sous la forme d’une capture d’écran et de trois points d’interrogation. « La barre latérale rame. » « L’onglet des PR ne marche pas. » L’agent ouvre l’application, clique au hasard, cherche dans le code, et tourne en rond.
La réponse tient en un fichier : la feature map. Une carte, écrite du point de vue de l’utilisateur, qui décrit pour chaque fonctionnalité ce qu’elle fait, comment y entrer, quels raccourcis clavier existent, quels attributs DOM permettent de la piloter via CDP, et quelles préconditions sont nécessaires pour valider un correctif. Un rapport flou devient alors un chemin exécutable : « le panneau latéral » correspond à telle zone, on y arrive ainsi, on vérifie ceci.
Deux points valent d’être soulignés. D’abord, la carte se périme : un raccourci qui change et l’agent atterrit ailleurs. Son greffon pstack fournit donc une compétence pour la créer et une autre pour la maintenir. Ensuite, la carte décrit l’usage, pas l’implémentation : pour l’interne, il faut toujours lire le code, qui change plus vite que la documentation.
Des skills testées comme du code
Pour elle, une skill — un simple fichier Markdown d’instructions — c’est l’équivalent de l’onboarding d’un nouvel ingénieur : excellent codeur, zéro contexte métier, arrivé il y a cinq secondes. On ne le laisse pas deviner ; on lui écrit comment travailler.
Mais écrire une skill ne garantit pas que l’agent la suive. D’où les evals, qu’elle décrit comme des tests unitaires pour agents. La mécanique est étonnamment concrète :
- un agent coordinateur rédige une grille d’évaluation de la tâche ;
- il lance plusieurs sous-agents dans des répertoires séparés, dont les noms sont choisis pour ne pas trahir qu’il s’agit d’un test — car un agent qui repère l’évaluation change de comportement ;
- on rejoue la même chose sur plusieurs modèles, et un agent juge d’un autre modèle recoupe la notation pour éviter le favoritisme ;
- enfin, on peut « grimper » la note : lancer une boucle qui retouche la skill jusqu’à obtenir 10/10.
Le détail le plus utile n’est pourtant pas dans la procédure, mais dans la méthode d’observation : il faut ouvrir les appels d’outils et les blocs de raisonnement, pas seulement lire la réponse finale. C’est comme ça qu’elle a découvert qu’un agent qui « avait trouvé la cause » n’avait en réalité jamais lu le fichier concerné.
« Maintenir des skills, c’est difficile. Il faut du goût et de l’observation. Il faut savoir être un passager exigeant. »
Du local au cloud : Benny
Question logique : où faire tourner tout ça ? Réponse en deux temps. D’abord en local, parce qu’on peut regarder ce que fait l’agent, comment il clique, quelles API il appelle. Ensuite dans le cloud, quand la confiance est là.
C’est là qu’intervient Benny, un agent qui récupère les rapports de bug, ouvre Cursor dans son propre ordinateur, et utilise exactement les mêmes compétences de contrôle pour tenter de reproduire le problème.
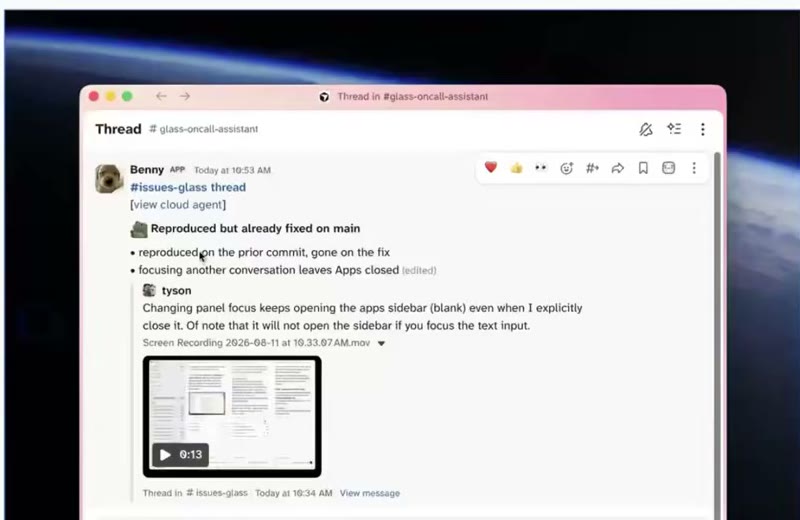
L’exemple montré à l’écran est parlant : le bug se reproduit bien sur l’ancien commit, mais il est déjà corrigé sur main. Il ne reste donc qu’à publier un nouveau build. Une heure d’enquête humaine économisée, et surtout une information que personne n’avait : ce n’est pas la peine de chercher.
C’est là que le cloud devient un levier d’équipe et pas une machine à bruit : la compétence de vérification, une fois écrite, profite aux collègues qui reçoivent les rapports, aux agents qui traitent les tickets, puis aux gens du produit.
Réécrire, mais avec des contraintes dures
Vient le sujet qui fâche : faut-il réécrire ? Sa réponse est nuancée, et à contre-courant.
Un projet ancien déjà bien outillé s’en sort bien : les garde-fous existent, les agents en héritent. Le vrai danger, c’est le prototype greenfield vibe-codé, comme GrokBot à son lancement : « les humains ne lisaient pas le code du tout ». Résultat, ce qu’elle appelle une architecture organique — chaque tâche résolue par la méthode la plus commode du moment, des dépendances qui s’enchevêtrent, une base que plus personne ne comprend vraiment.
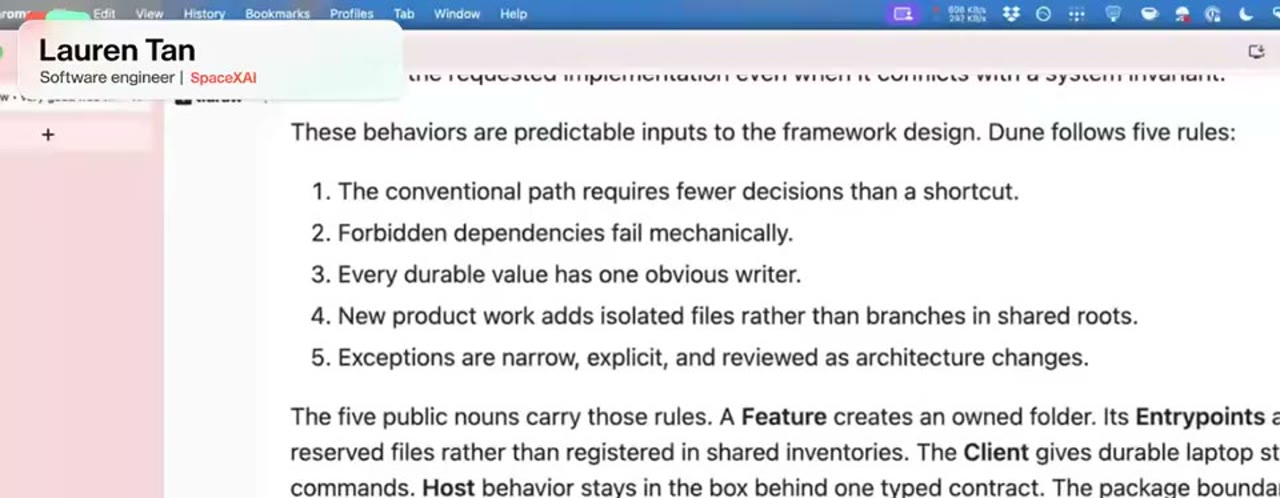
Sa réponse s’appelle Dune, qu’elle décrit comme « un Next.js pour applications Electron », conçu pour être écrit par des agents. Cinq règles, affichées à l’écran :
- le chemin conventionnel demande moins de décisions qu’un raccourci ;
- les dépendances interdites échouent mécaniquement ;
- chaque valeur durable a un seul écrivain évident ;
- une nouvelle fonctionnalité ajoute des fichiers isolés plutôt que des branches dans des racines partagées ;
- les exceptions sont étroites, explicites, et revues comme des changements d’architecture.
Et derrière les règles, une CI volontairement pénible : useEffect est banni (l’un des plus grands pièges de React), les commentaires de code aussi, et un contrôle du graphe d’imports empêche de faire glisser du code du processus principal vers le renderer. Sur les commentaires, son explication vaut le détour : « 99 % du temps, les agents écrivent des commentaires qui racontent un détail historique sans rapport avec le code » — typiquement une remarque de revue transformée en règle éternelle. « Moi je voulais dire que cette PR était mauvaise, pas édicter une loi. »
La hiérarchie des contraintes est le cœur du raisonnement :
- la base de code et le framework : le plus fort, parce que les agents copient les motifs existants ;
- l’analyse statique, le lint, le compilateur, la CI : ça échoue franchement, sans discussion ;
- règles, skills, style guide, revue automatique : mou. L’agent peut oublier, ou mal appliquer.
D’où la comparaison avec Rust : un compilateur strict rend une partie de la confiance mécanique, et l’humain n’a plus à relire chaque ligne. D’où, aussi, la règle qui résume tout : chaque fois que vous devez écrire en revue « il ne faut pas faire ça », considérez-le comme un défaut de votre outillage. Transformez-le en lint, en échec de CI, ou supprimez carrément la possibilité de se tromper.
Le reste découle d’un principe d’ergonomie inversée : « le chemin le plus court est le meilleur chemin ». Une fonctionnalité vit dans un seul dossier ; dans 80 % des cas, l’agent travaille dans un seul répertoire. Le framework est pensé pour « l’agent le plus bête » : moins de choix à faire, donc moins d’occasions de mal choisir.
Combien ça coûte
La question fuse dans le chat : et pour ceux qui n’ont pas de tokens illimités ? Sa réponse est honnête. Elle travaille dans un laboratoire d’IA, avec des tokens illimités, et ne prétend pas que tout le monde puisse refaire la même chose. Le refactor de GrokBot, à lui seul, a coûté plus de 600 PR.
Mais elle pose le calcul en termes de retour sur investissement : dépenser des tokens maintenant pour un environnement où même un modèle modeste produit du code correct, contre le coût d’une embauche supplémentaire pour tenir les mêmes contraintes. Ce qu’elle ne pouvait pas faire seule, dit-elle, c’est exactement ça : imposer un tel niveau de discipline à une base de code. « Ça m’aurait pris des années. »
Un détail au passage : elle n’impose pas de plafond de lignes par PR, mais demande à ses agents de découper le travail en PR atomiques. L’historique Git reste lisible, et une régression se repère et s’annule sans fouiller une PR de 40 000 lignes.
GrokBot, le « moment Cursor » des non-développeurs
Dernière idée, qui explique pourquoi tout ça dépasse les ingénieurs : GrokBot ressemble à iMessage. Un agent par compte, un nom, une conversation, une orchestration qui se fait naturellement. Un chef de produit peut demander un résumé de « ce que Lauren a fait cette nuit » et le lire au petit-déjeuner.
Conséquence concrète : des chefs de produit et des designers livrent maintenant des correctifs. « Ils me disent : voilà un bug, je l’ai corrigé, tu peux regarder ? Et je valide. » Ce n’est pas la magie du modèle qui rend ça possible, c’est l’architecture : les contraintes dures empêchent le correctif improvisé de casser le reste.
Par où commencer
Si on résume la conférence en une marche à suivre, ça donne ceci :
- Prendre un bug récurrent, observable en local, et le confier à un agent.
- Lui donner les moyens de constater : lancer l’application, prendre une trace, mesurer. Sans ça, vous serez toujours le vérificateur.
- Écrire la carte de la fonctionnalité concernée, du point de vue de l’utilisateur, et la maintenir.
- Écrire une eval et comparer avant/après : une skill qui n’est pas mesurée est une croyance.
- Transformer chaque remarque de revue récurrente en lint, en échec de CI, ou en suppression de la mauvaise option.
- Seulement ensuite : cloud, parallélisme, fusion automatique.
Le post vend un organigramme de 50 agents. La vidéo, elle, explique pourquoi cet organigramme ne tient pas debout sans tout le reste — la vérification, les cartes, les evals, les contraintes — et pourquoi le vrai saut de productivité n’est pas dans le nombre d’agents, mais dans le nombre de choses que l’on n’a plus besoin de vérifier soi-même.
Liens
- Post source sur X (27 octobre 2026) — 793 000 vues au moment de la rédaction
- Vidéo intégrale du post (57 min, version 1080p)
- Le greffon
pstackcité pendant la conférence se trouve en cherchant « pstack cursor »
Captures d’écran : extraits de la vidéo du post.
Vidéos de l'article
- ▶ Ouvrir la vidéo
/videos/50-agents-lauren-tan.mp4