Construire un agent IA en production : 10 setups réels de Stripe, Uber, Shopify, Meta
Construire un agent IA en production : 10 setups réels de Stripe, Uber, Shopify, Meta
Source: Yaroslav (Yarchi) Rudenko (@undefinedKi) — article du 10 octobre 2026 · 121 200 vues, 193 likes, 428 favoris
Les agents de code de Stripe fusionnent plus de 1 000 pull requests par semaine. Chez Uber, plus de 70 % des pull requests viennent désormais d’agents. Spotify a fusionné plus de 2,5 millions de PR de maintenance automatisée.
Aucune de ces entreprises n’utilise un seul agent. Chacune utilise un ensemble d’agents, et chaque agent est conçu différemment selon la tâche : il faut un modèle pour relire du code, un autre pour enquêter sur une panne système, un troisième pour répondre à une question sur les données.
La bonne nouvelle, c’est qu’ils en parlent. Les équipes d’ingénierie de Stripe, Uber, DoorDash, Shopify, Meta, Microsoft, Cloudflare et d’autres ont publié le fonctionnement de leurs agents, architecture et métriques réelles comprises.
J’ai passé en revue 70+ de ces publications et je les ai regroupées en 10 setups. Pour chacun :
- Ce que fait l’agent
- Comment il est construit
- Des exemples d’entreprises
- Par où commencer si vous voulez le vôtre
Et à la fin, une liste de repos avec des setups d’agents prêts à installer.
Comment tout agent est construit
Si on met de côté les fonctionnalités propres à chaque marque, tous les agents de cet article ont essentiellement le même cœur.
Le guide d’OpenAI le décompose en trois parties :
- Modèle : le LLM qui raisonne et décide
- Outils : les fonctions et API qu’il peut appeler
- Instructions : les règles qui dictent son comportement
La définition d’Anthropic est encore plus courte : les agents « sont généralement des LLM qui utilisent des outils sur la base du feedback de l’environnement, dans une boucle ».
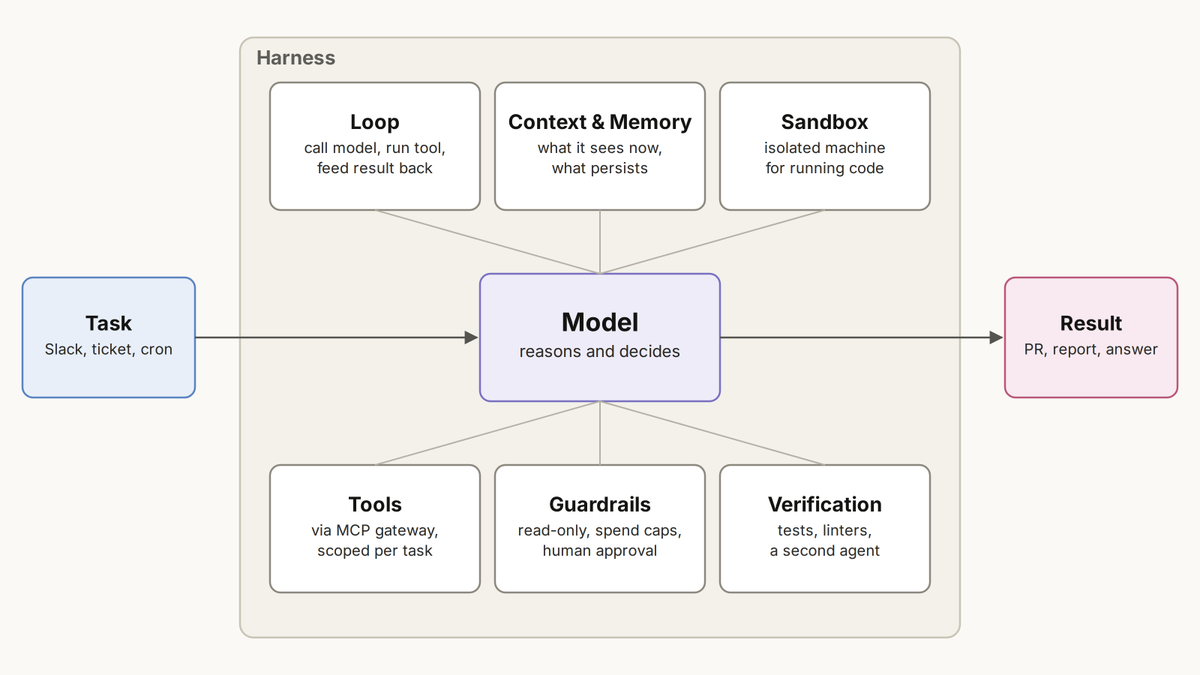
Le modèle est la plus petite partie. Ce sur quoi les entreprises passent vraiment des mois, c’est tout ce qui l’entoure, le harness :
- La boucle : appeler le modèle, exécuter l’outil demandé, renvoyer le résultat, recommencer
- Contexte et mémoire : ce que l’agent voit dans ce tour, et ce qui sera conservé jusqu’à la prochaine session
- Sandbox : une machine isolée où il peut exécuter du code sans toucher à rien de réel
- Accès aux outils : typiquement via la passerelle MCP, qui détermine quels outils seront utilisés pour chaque tâche
- Garde-fous : lecture seule par défaut, plafonds de dépense, approbation humaine pour les actions risquées
- Vérification : tests, linters ou un second agent qui contrôle le travail avant livraison
Workflow ou agent
Ces systèmes se divisent en deux catégories :
- Workflows : modèles et outils exécutés le long de chemins de code prédéfinis
- Agents : le modèle détermine lui-même ses étapes et ses appels d’outils
En pratique, la plupart des setups en production mélangent les deux. Stripe appelle les siens des « blueprints » : des étapes fixes comme le lint et le push, avec des boucles d’agent entre les deux pour les parties qui demandent du jugement.
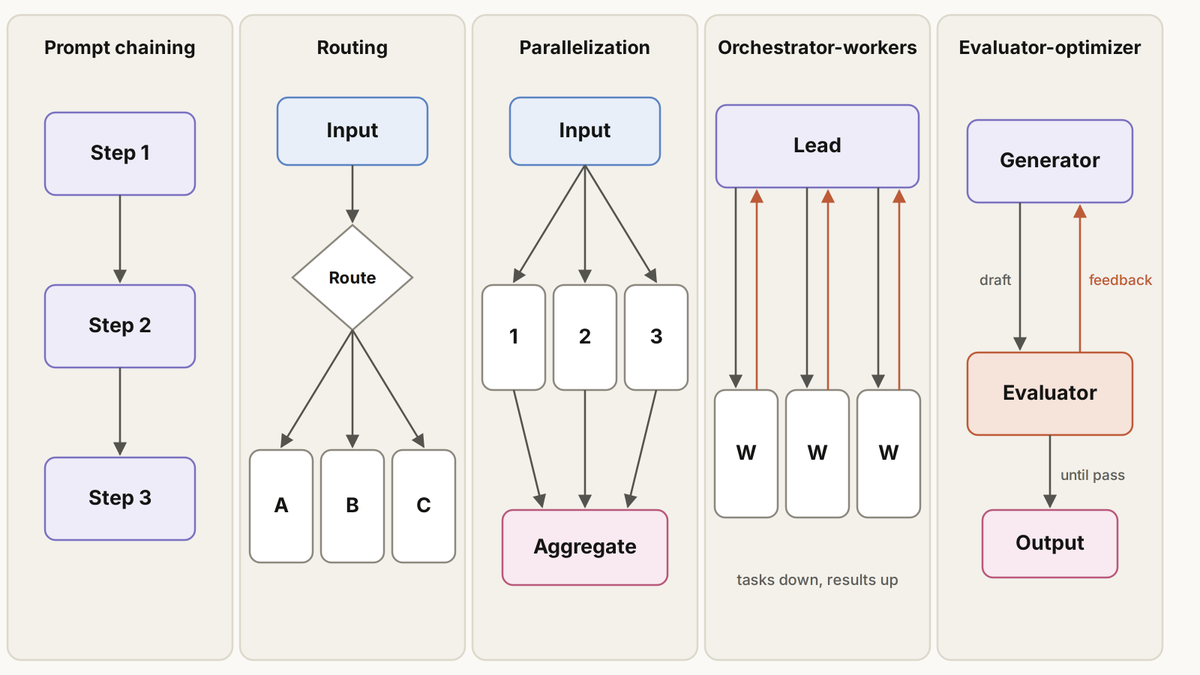
Les cinq patterns
Presque tous les setups ci-dessous sont construits à partir de ceux-là :
- Prompt chaining : chaque étape traite le résultat de la précédente
- Routage : classifier les données d’entrée et les envoyer vers un gestionnaire spécialisé
- Parallélisation : découper le travail en parties, ou exécuter la même tâche plusieurs fois et comparer les résultats
- Orchestrateur/travailleurs : un agent principal découpe la tâche, confie des parties à des travailleurs, fusionne les résultats
- Évaluateur/optimiseur : un agent crée, un autre critique, et ainsi de suite jusqu’à validation du résultat
Un agent ou plusieurs
Commencez par chercher à tirer le maximum d’un seul agent. Ne les séparez que si les instructions deviennent trop enchevêtrées ou si les outils commencent à se recouvrir.
Microsoft l’a appris à ses dépens. La première version de leur Azure SRE Agent avait plus de 100 outils étroits et plus de 50 sous-agents spécialisés. Le système a connu des échecs lors des transferts de données. Selon eux, les chaînes de plus de quatre transferts se terminaient presque toujours en échec. Résultat de la réorganisation : plusieurs agents universels et cinq outils cœur.
La règle empirique : ajoutez un second agent quand il fait un travail réellement différent, par exemple vérifier le travail du premier.
Setup 1 : agent de code en arrière-plan
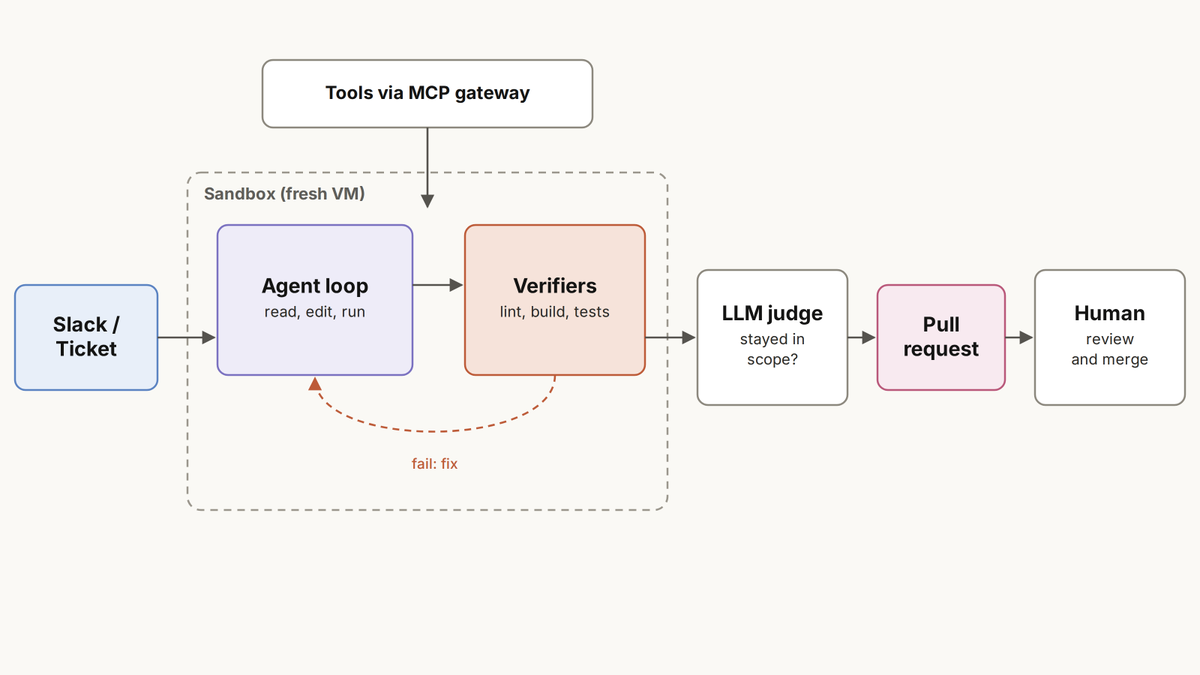
Ce qu’il fait : un ingénieur poste une tâche sur Slack ou crée un ticket, s’éloigne, et à son retour la pull request est prête.
Comment c’est construit :
- Déclencheur : message Slack, ticket ou tâche cron
- Sandbox : une machine de dev neuve et isolée par tâche, préchauffée pour démarrer en quelques secondes
- Workflow : étapes fixes (lint, push, ouverture de PR) mêlées à des boucles d’agent pour le code lui-même
- Vérificateurs : formatage, build et tests lancés automatiquement avant même qu’une PR n’existe
- Humain : relit et fusionne, l’agent ne le fait jamais
Qui l’utilise
Stripe, Minions. Plus de 1 000 PR fusionnées par semaine, écrites de bout en bout par des agents. Chaque exécution suit un « blueprint », un workflow défini dans le code, et récupère les outils nécessaires depuis Toolshed, un serveur MCP interne accessible à des centaines d’agents. Source : stripe.dev/blog/minions-stripes-one-shot-end-to-end-coding-agents
Spotify, Honk. Un agent ne peut voir que le code et appeler les vérificateurs. Le stop hook déclenche chaque vérification avant l’ouverture d’une PR. Puis un juge LLM compare le diff à la tâche d’origine et rejette environ un quart des sessions pour être sorti du périmètre. Source : engineering.atspotify.com/2025/12/feedback-loops-background-coding-agents-part-3
Shopify, River. Vous mentionnez @river dans un canal Slack public. Un PR fusionné sur huit chez Shopify est maintenant co-auteuré par lui : 3 536 PR en 30 jours. Source : shopify.engineering/under-the-river
Par où commencer : anthropics/claude-code-action. Mentionnez @claude sur une issue ou une PR GitHub et il fonctionne dans GitHub Actions, ouvrant la PR pour vous.
Setup 2 : agent de revue de code
Ce qu’il fait : il relit chaque pull request avant un humain, et ne garde que les commentaires qui valent la lecture.
Comment c’est construit :
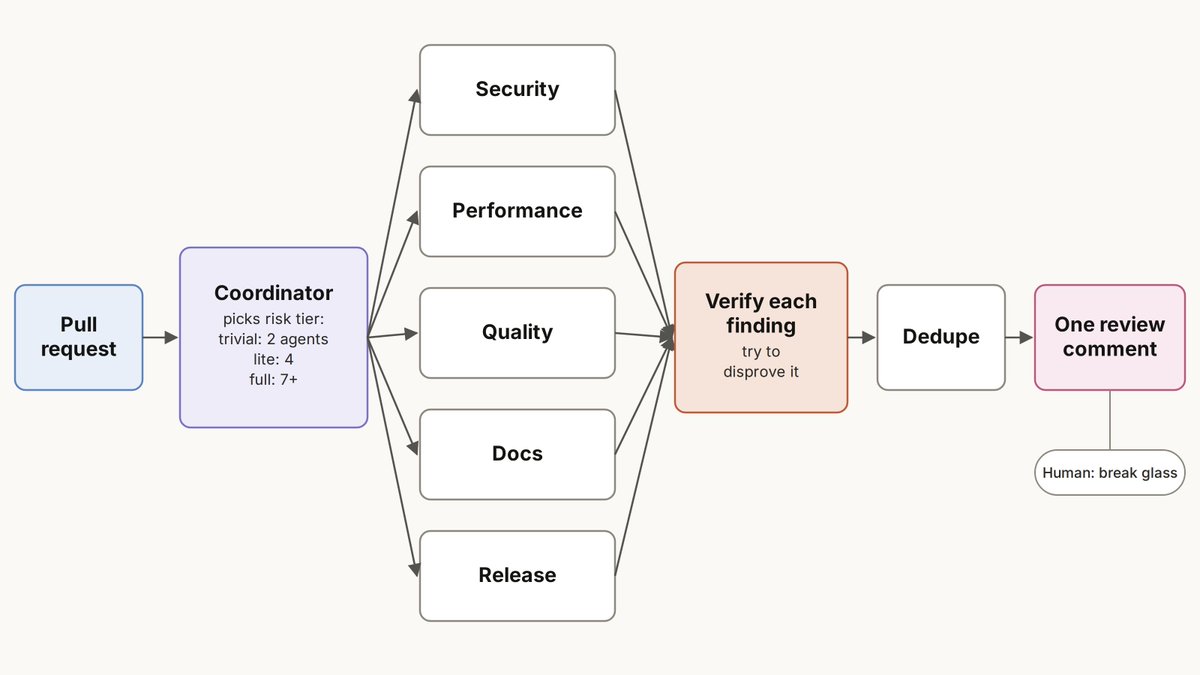
- Coordinateur : lit le diff et décide du niveau de risque
- Spécialistes : des relecteurs séparés pour la sécurité, la performance, la qualité du code et la documentation, chacun avec son propre prompt
- Vérification : chaque constat doit survivre à une seconde vérification avant d’être publié
- Dédoublonnage : les commentaires dupliqués sont fusionnés en une seule revue
- Dérogation : un humain peut toujours forcer la fusion
Plus le risque est élevé, plus on appelle de relecteurs. Une correction de typo n’a pas besoin d’un audit de sécurité.
Qui l’utilise
Cloudflare. Le coordinateur désigne jusqu’à 7 relecteurs spécialisés, selon le niveau de risque. En un mois : 131 246 exécutions de revue sur 48 095 merge requests, médiane de 3 minutes 39, coût médian de 0,98 $. Les ingénieurs ont outrepassé le bot sur seulement 0,6 % des MR. Source : blog.cloudflare.com/ai-code-review
DoorDash. Le lead scout signale les zones suspectes, deux réviseurs experts les vérifient, et chaque commentaire doit passer une phase de réfutation avant publication. Plus de 10 000 PR par semaine. 60,2 % des constats de sévérité élevée ont entraîné une modification de code, contre 46 % avec leur outil tiers précédent. Environ 3 $ par revue. Source : careersatdoordash.com/?p=15891
Uber, uReview. Trois générateurs produisent des commentaires, un expert évalue chacun, et les catégories de faible valeur sont filtrées. 75 % des commentaires jugés utiles, plus de 65 % réellement pris en compte. Source : uber.com/blog/ureview
Par où commencer : la commande /review de garrytan/gstack, ou les skills de code review de obra/superpowers.
Setup 3 : agent de migration
Ce qu’il fait : prend une seule modification ennuyeuse qui doit être faite dans des milliers d’endroits (une nouvelle bibliothèque de tests, une nouvelle API, la suppression d’anciens feature flags) et applique toutes ces modifications.
Comment c’est construit :
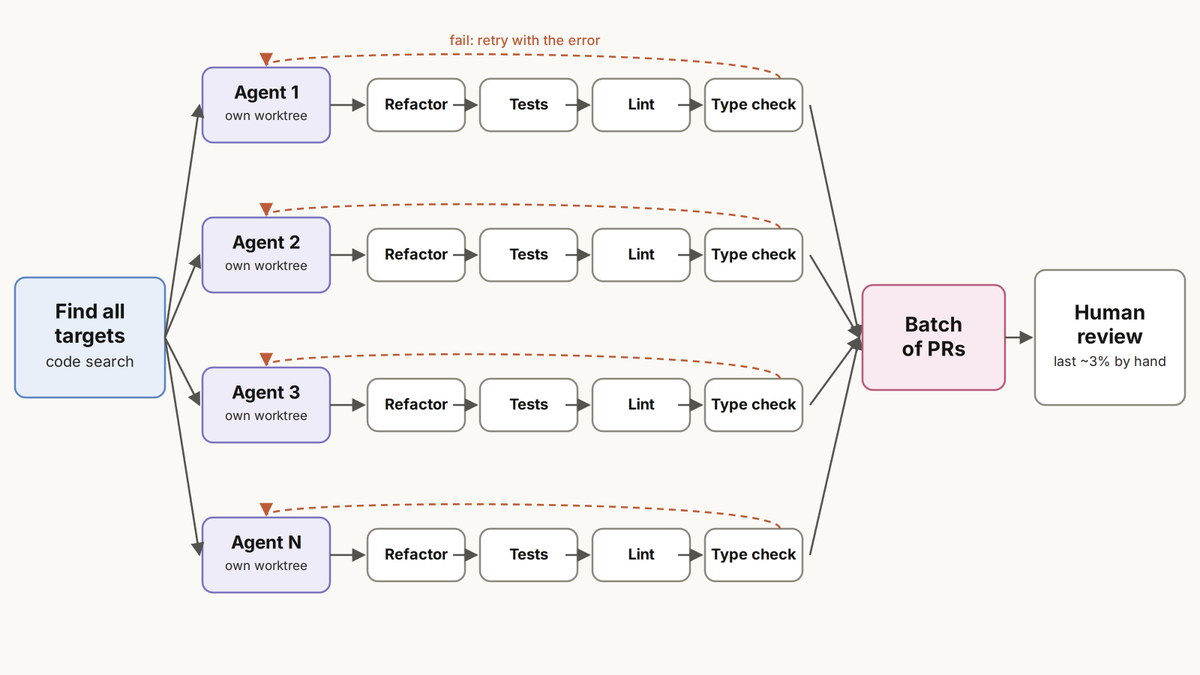
- Trouver : un script ou une recherche de code liste chaque fichier ou flag à changer
- Fan out : un agent par fichier ou par élément, beaucoup tournant en parallèle, chacun dans son propre worktree Git
- Gates : chaque fichier passe des vérifications fixes (tests, lint, typage) et n’avance que si elles passent
- Retry : si la vérification échoue, un message d’erreur est renvoyé à l’agent avec des informations sur la tentative suivante
- Humain : relit des lots de PR et corrige à la main les derniers pour cent
La clé, c’est la machine à états. L’agent ne décide jamais qu’il a terminé, ce sont les tests qui le décident.
Qui l’utilise
Airbnb. Migration d’environ 3 500 fichiers de test vers une nouvelle bibliothèque de test. Chaque fichier est passé par refactorisation → tests → lint → typage, avec les erreurs renvoyées en cas d’échec. 97 % fait automatiquement. Estimé à la main : 1,5 an. Réel : 6 semaines. Source : medium.com/airbnb-engineering/accelerating-large-scale-test-migration-with-llms-9565c208023b
Google. Trouve chaque emplacement par recherche de code interne, génère des diffs avec un Gemini fine-tuné, valide par builds et tests. Sur une migration d’ID, 80 % des changements de code étaient entièrement écrits par l’IA. JUnit 3 vers 4 : 5 359 fichiers en 3 mois. Source : arxiv.org/abs/2501.06972
DoorDash. Un orchestrateur choisit les feature flags périmés et écrit un rapport à valider par un humain. Puis jusqu’à 4 agents de suppression par dépôt travaillent en parallèle dans des worktrees. Aucune PR tant que les tests ne passent pas et que 95 % des lignes modifiées ne sont pas couvertes. 45 flags sur 50 sont arrivés prêts à merger, 4,79 $ et 13,8 minutes par flag. Source : careersatdoordash.com/blog/automating-feature-flag-cleanup-at-scale-with-a-multi-agent-llm-system
Par où commencer : les skills dispatching-parallel-agents et using-git-worktrees dans obra/superpowers.
Setup 4 : agent d’astreinte / SRE
Ce qu’il fait : rejoint l’incident dès qu’une alerte se déclenche, enquête pendant que les humains sont encore en train d’ouvrir leurs ordinateurs portables, et poste ce qu’il a trouvé.
Comment c’est construit :
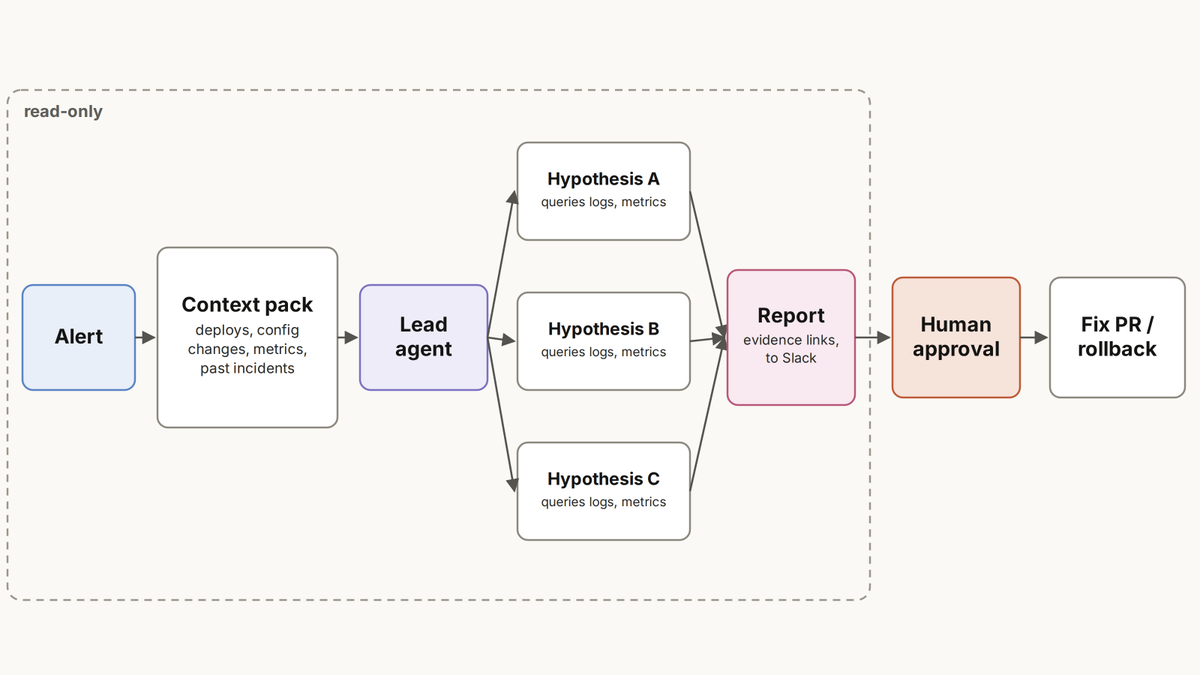
- Déclencheur : alerte PagerDuty, Datadog ou canal Slack d’incident
- Contexte d’abord : des vérifications déterministes récupèrent les derniers déploiements, changements de config, dashboards et incidents similaires avant que le modèle ne démarre
- Hypothèses : plusieurs causes possibles explorées en parallèle, chacune par son propre sous-agent
- Règle de preuve : toute conclusion doit renvoyer à une requête, une ligne de log ou un graphique précis
- Lecture seule : l’agent peut tout regarder, mais ne rien modifier
- Approbation : redémarrages, rollbacks et corrections passent par un bouton qu’un humain presse
Qui l’utilise
Microsoft, Azure SRE Agent. Parti de plus de 100 outils étroits et plus de 50 sous-agents, reconstruit autour de quelques généralistes avec un large accès CLI et de l’exécution de code pour les métriques. Sur 9 mois, il a géré seul plus de 35 000 incidents. Pour un service, le temps de mitigation est passé d’une moyenne humaine de 40,5 heures à 3 minutes. Source : techcommunity.microsoft.com/blog/appsonazureblog/context-engineering-lessons-from-building-azure-sre-agent/4481200
Ramp, OCA. Rejoint le canal d’incident, poste une première mise à jour en 5 minutes environ et un rapport complet en 13. Lecture seule partout, actions destructrices uniquement via des boutons d’approbation Slack. En quatre semaines il a assisté 575 PR de correction d’incident sur 1 220, avec 37 % d’ingénieurs en moins mobilisés. Source : builders.ramp.com/post/how-we-built-oca-our-ai-on-call-assistant
Meta. Chaque conclusion doit citer une requête d’outillage précise, imposé par l’architecture, pour que le modèle ne puisse pas inventer des données. Le temps médian entre détection et mitigation est passé de 9,5 heures à 3,8. Source : atscaleconference.com/?p=1037753
Par où commencer : le cookbook d’OpenAI « Build an SRE agent for incident response ». Rollbacks verrouillés par approbation, état d’enquête conservé dans un thread Slack.
Setup 5 : agent de sécurité
Ce qu’il fait : trie les alertes de sécurité, cherche des vulnérabilités dans le code et rédige des correctifs, pour que l’équipe sécurité ne regarde que ce qui est réel.
Comment c’est construit :
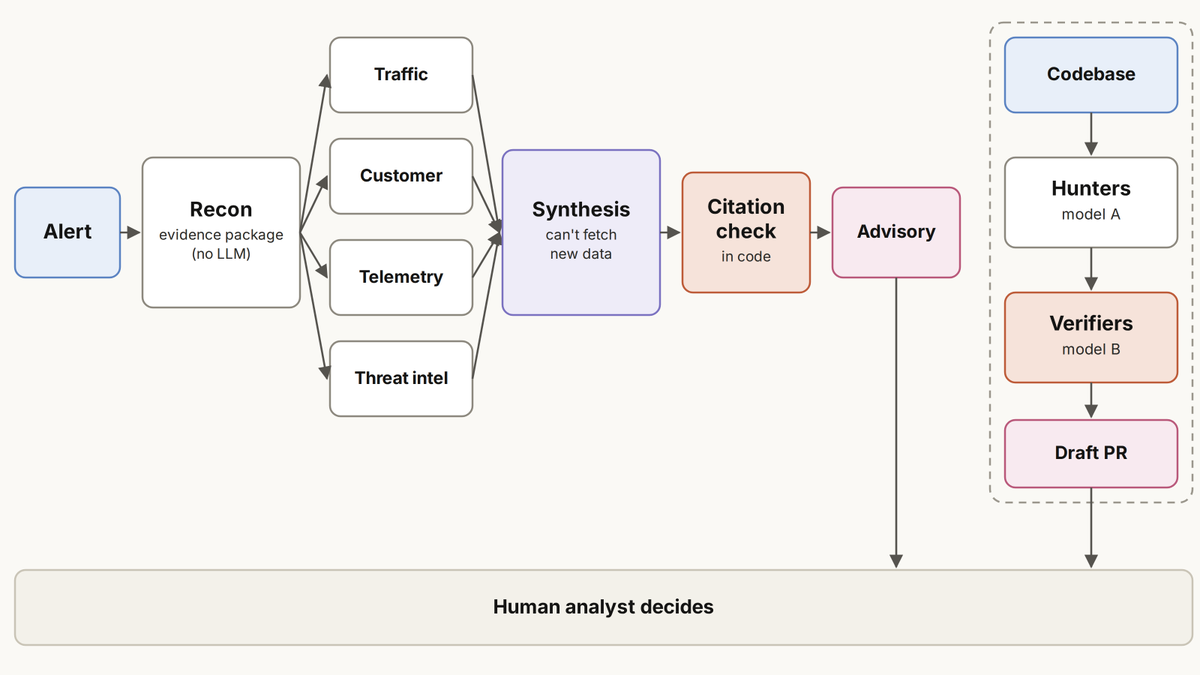
- Preuve d’abord : du code ordinaire collecte logs, trafic et contexte dans un paquet avant tout appel de modèle
- Spécialistes : des agents séparés regardent différents angles en parallèle (trafic, contexte utilisateur, threat intel)
- Chasseurs et vérificateurs : les agents qui trouvent des problèmes et ceux qui les vérifient tournent sur des modèles différents
- Citations vérifiées en code : un constat sans preuve réelle derrière est supprimé
- Les humains décident : les agents recommandent, les PR s’ouvrent en brouillon, les gens approuvent les mitigations
Qui l’utilise
Cloudflare. Publié cette semaine. Le code construit un paquet de preuves versionné avant tout lancement de modèle. Quatre agents spécialisés travaillent en parallèle, puis un agent de synthèse rédige l’avis. Il ne peut rien aller chercher de nouveau et doit choisir dans un vocabulaire approuvé. Chaque citation est vérifiée par du code applicatif. Pas de preuve, pas de verdict. Source : blog.cloudflare.com/agentic-security-operations
Figma. Un modèle bon marché route chaque alerte, un modèle plus fort la trie en utilisant Okta, Wiz et Panther. Quand un analyste le corrige, l’agent met à jour son propre fichier de pilotage. Les PR d’agents sont forcées en brouillon. Résultat : temps de résolution 71 % plus rapide, 20 % d’alertes d’astreinte en moins. Source : figma.com/blog/how-we-secure-figmas-internal-systems-with-agents
Shopify, Dispatch. Découpe chaque application en parties, lance des chasseurs de bugs sur chaque partie en parallèle, puis vérifie les constats avec des modèles délibérément différents. Six semaines : plus de 300 constats sur plus de 80 applications, environ 400 000 $ de valeur équivalente de bug bounty. Un scan complet coûte 50 à 300 $. Source : shopify.engineering/building-an-agentic-harness-that-outlasts-the-model
Par où commencer : trailofbits/skills, 42 plugins de sécurité de Trail of Bits pour l’audit de code, les smart contracts et le reverse engineering.
Setup 6 : agent analyste de données
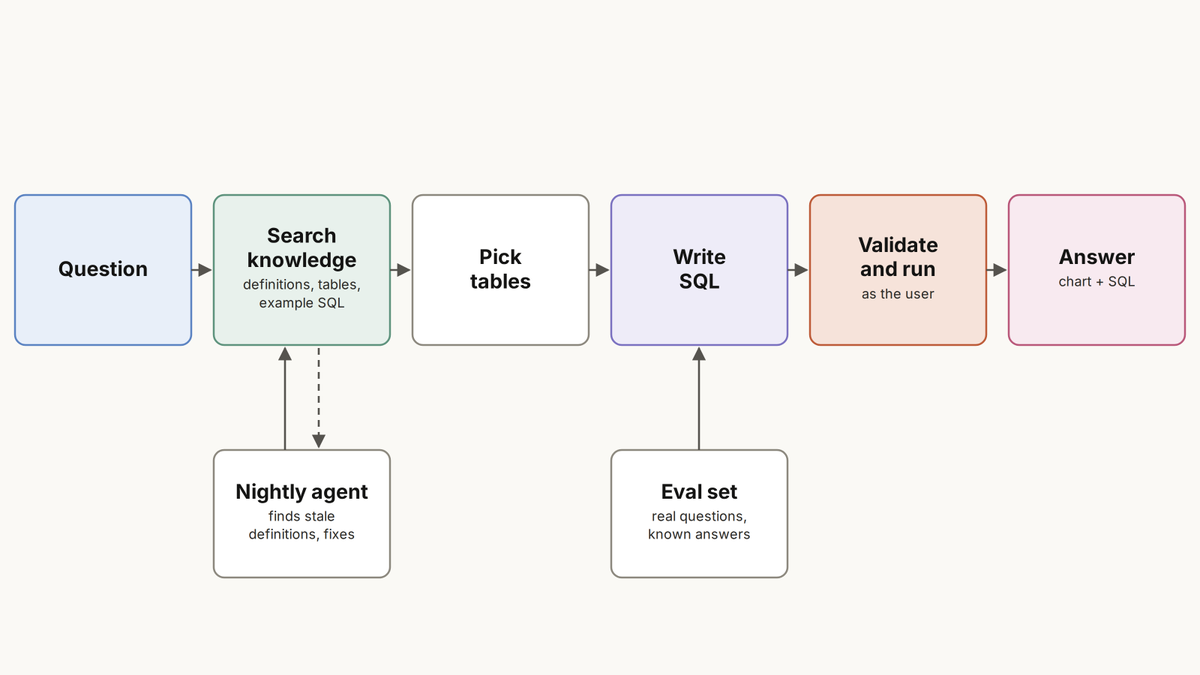
Ce qu’il fait : n’importe qui dans l’entreprise pose une question en langage naturel (« pourquoi les commandes ont-elles chuté dans l’Ohio la semaine dernière ? ») et obtient une réponse avec le SQL derrière.
Comment c’est construit :
- Couche de connaissance : descriptions de tables, définitions de métriques, requêtes d’exemple et règles métier que l’agent cherche en premier
- Récupération : trouve les bonnes tables avant d’écrire quoi que ce soit
- SQL : le modèle écrit la requête, le harness la valide et l’exécute
- Permissions : les requêtes tournent avec les accès de l’utilisateur, donc personne ne voit ce qu’il ne devrait pas
- Évals : un jeu de questions réelles aux réponses connues, rejoué après chaque changement
- Approbation : pour les analyses lourdes, l’agent montre un plan et attend un oui
Le modèle compte moins qu’on ne le croit. L’essentiel du travail est dans la couche de connaissance.
Qui l’utilise
DoorDash, Vera. Couvre plus de 200 000 datasets. Les nouvelles sources de données restent désactivées tant qu’elles ne passent pas un seuil d’eval. Le taux de passage est passé de 43 % à 90 % sur plus de 1 900 evals. Sur le même modèle, Vera a obtenu 2,60 sur 3 et Claude Code en configuration simple 2,16 : c’est le harness qui a fait la différence. Source : careersatdoordash.com/blog/inside-vera-doordashs-data-agent
Notion, Data Scout. Publié le 8 octobre. Les requêtes tournent sous les identifiants Snowflake de chaque employé. Les définitions vivent dans une base Notion partagée, et des agents nocturnes repèrent celles qui sont périmées ou contradictoires. Les demandes à l’équipe data ont chuté d’environ 80 % en deux mois. Source : notion.com/blog/how-we-built-a-personal-data-scientist-for-every-notion-employee
OpenAI. Leur agent data interne empile six couches de contexte, de l’usage des tables aux connaissances organisationnelles, et sauvegarde de la mémoire chaque fois qu’un utilisateur le corrige. Plus de 3 500 utilisateurs internes sur 600 PB de données. Source : openai.com/index/inside-our-in-house-data-agent
Par où commencer : le plugin data de anthropics/knowledge-work-plugins.
Setup 7 : agent de support client
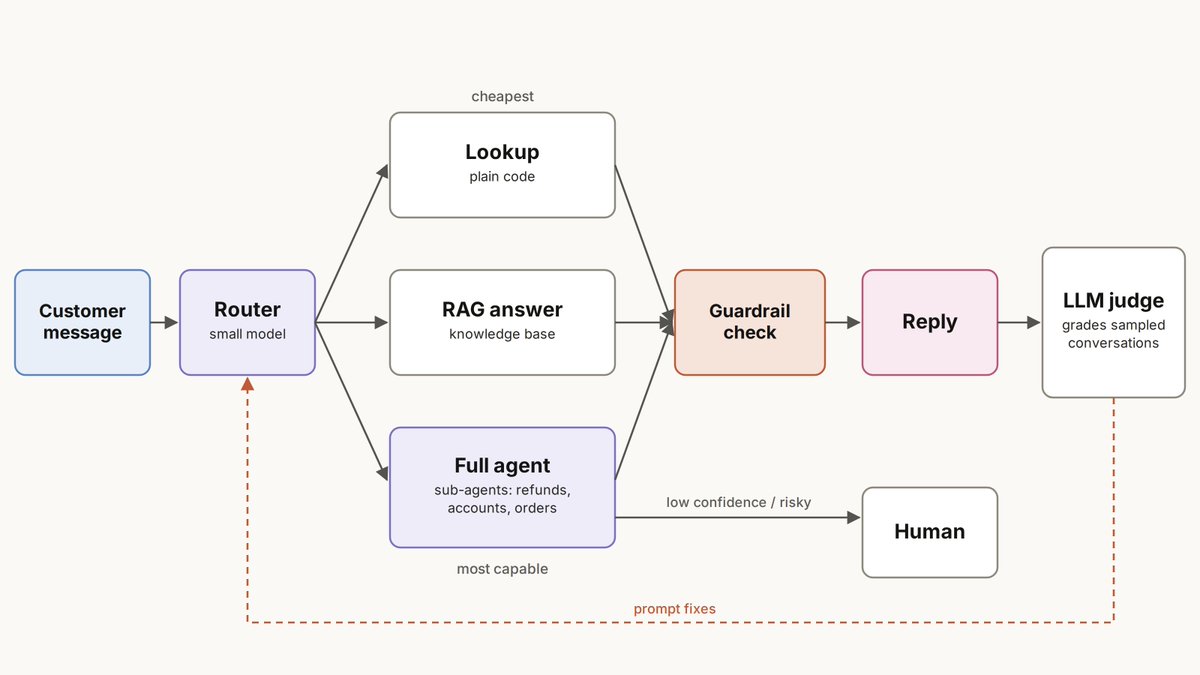
Ce qu’il fait : répond aux clients et au personnel support, résout ce qu’il peut, et passe le reste à un humain avec le contexte déjà rassemblé.
Comment c’est construit :
- Routeur : un petit modèle bon marché lit la demande et décide où elle va
- Échelle de coûts : les recherches simples vont au code ordinaire, les questions courantes au RAG, seuls les cas complexes atteignent l’agent complet
- Spécialistes : des sous-agents séparés pour les remboursements, les comptes, les livraisons, chacun avec ses outils
- Garde-fous : chaque réponse est vérifiée sur la politique, les hallucinations et les fuites avant de partir
- Juges : un LLM note un échantillon de vraies conversations chaque jour
- Passage de relais : escalade vers un humain quand la confiance est faible ou l’action risquée
Qui l’utilise
Lyft. Un méta-agent route les demandes vers des sous-agents, certains faits main, certains générés depuis une config JSON. Les contrôles de sécurité tournent à chaque tour, des juges LLM relisent des traces de production échantillonnées. Créer un nouveau agent de support est passé d’environ 6 mois à environ 2 semaines. Taux de résolution par l’IA en hausse de 16 %. Source : langchain.com/blog/lyft-built-a-self-serve-ai-agent-platform-for-customer-support-with-langgraph-and-langsmith
DoorDash. Le support des livreurs tourne sur du RAG sur les cas résolus, puis un garde-fou à deux niveaux et un juge LLM qui note chaque réponse. Hallucinations en baisse de 90 %, problèmes graves de conformité en baisse de 99 %. Source : careersatdoordash.com/blog/large-language-modules-based-dasher-support-automation
Coinbase, CEEcil. Un petit modèle choisit la route, des gestionnaires déterministes répondent en une ou deux secondes, et seules les questions ouvertes atteignent l’agent complet. Il peut ouvrir des PR pour corriger des choses, mais ne les fusionne jamais. Source : coinbase.com/blog/ceecil-engineering-a-support-teammate-with-human-memory
Par où commencer : le quickstart customer-support-agent dans anthropics/claude-quickstarts.
Setup 8 : agent de recherche
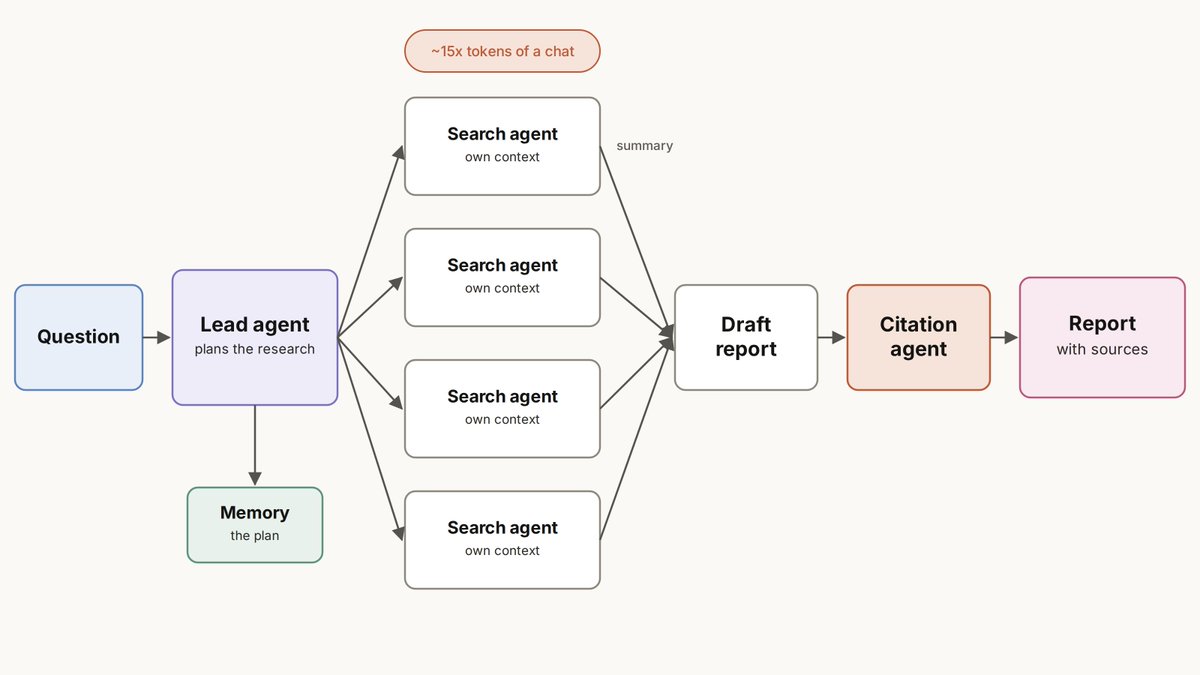
Ce qu’il fait : prend une question large, cherche sur des dizaines de sources en même temps, et revient avec un rapport où chaque affirmation a une citation.
Comment c’est construit :
- Agent principal : planifie la recherche et sauvegarde le plan en mémoire, pour qu’il survive aux longues exécutions
- Travailleurs parallèles : des sous-agents, chacun cherchant un angle dans son propre contexte propre
- Compression : chaque travailleur renvoie un résumé court, pas tout ce qu’il a lu
- Passe de citations : un agent séparé rattache chaque affirmation à sa source à la fin
- Coût : le setup le plus gourmand en tokens de cette liste, à réserver aux questions qui le méritent
Qui l’utilise
Anthropic. La fonctionnalité de recherche dans Claude : un Opus principal lance des sous-agents Sonnet qui cherchent en parallèle, puis un agent de citations termine le rapport. Il a battu un agent Opus unique de 90,2 % sur leur eval interne. Le hic : il consomme environ 15 fois les tokens d’un chat normal, et la seule consommation de tokens expliquait 80 % de la différence de performance. Source : anthropic.com/engineering/multi-agent-research-system
Harvey. Revue de contrats juridiques face au playbook d’un cabinet. Un sous-agent par règle, des dizaines en parallèle, chacun éditant sa propre branche du document. Une étape de réconciliation fusionne les édition comme git et escalade les conflits. La qualité du redline est passée de 53 % à 87 %, au prix de 47 % de latence en plus. Source : harvey.ai/blog/rebuilding-playbook-review-as-a-multi-agent-system
Perplexity. Deep Research exécute désormais des milliers d’étapes de récupération en parallèle, le modèle écrivant du code pour assembler ses propres recherches. Le score BrowseComp est passé de 40,7 % à 83,8 %. Source : perplexity.ai/hub/deep-research
Par où commencer : assafelovic/gpt-researcher, un planificateur, des agents d’exécution et un publisher qui rédige le rapport final.
Setup 9 : agent de connaissance (second cerveau)
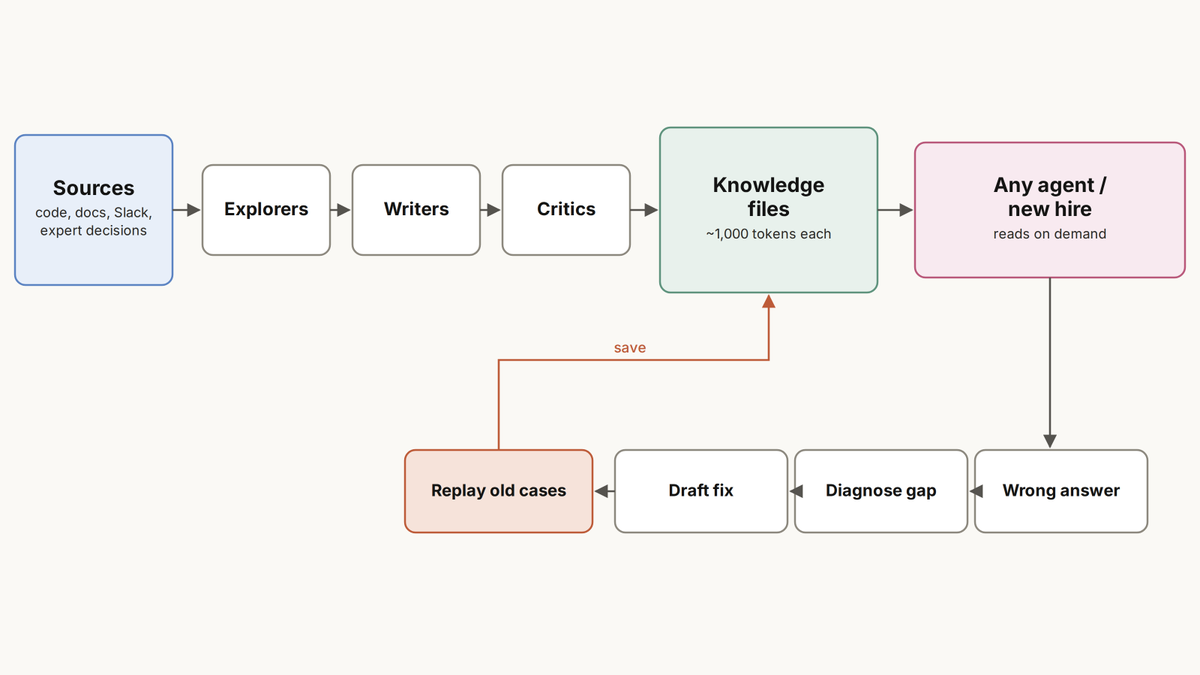
Ce qu’il fait : capture ce que les experts savent — la chose qui n’a jamais été écrite — et le donne à tous les agents et à chaque nouvelle recrue.
Comment c’est construit :
- Fichiers de connaissance : des notes courtes et structurées (fichiers clés, règles, patterns non évidents), pas des docs géants
- Builders : des agents lisent le code, la doc et les décisions passées et écrivent ces notes
- Critics : d’autres agents relisent les notes avant qu’elles soient sauvegardées
- Règles de mémoire : les faits expirent sauf si quelque chose les confirme à nouveau, les conflits sont signalés
- Auto-amélioration : quand une réponse est fausse, le système trouve la pièce manquante, rédige un correctif et le teste sur d’anciens cas avant de le sauvegarder
L’objectif est une boussole, pas une encyclopédie. Meta garde chaque fichier aux alentours de 1 000 tokens.
Qui l’utilise
Meta, tribal knowledge. Plus de 50 agents (explorateurs, analystes, rédacteurs, critiques) ont cartographié plus de 4 100 fichiers de pipelines de données dans 59 fichiers de contexte. La couverture de contexte IA est passée d’environ 5 % à 100 %, et les agents ont utilisé 40 % d’appels d’outils en moins par tâche. Source : engineering.fb.com/2026/04/06/developer-tools/how-meta-used-ai-to-map-tribal-knowledge-in-large-scale-data-pipelines
Meta, organizational second brain. Plus de 200 fichiers de connaissance plus des « recettes » qui contiennent la méthode mais aucun fait. Quand il se trompe, des sous-agents rédigent un correctif, un agent adversarial le relit, et d’anciens cas sont rejoués avant livraison. Environ 80 % de tokens en moins par question, plusieurs jours de travail expert réduits à des minutes. Source : engineering.fb.com/2026/09/02/ml-applications/organizational-second-brain-ai-learns-from-experts
Notion, Lore. Mémoire partagée pour agents construite comme cinq bases Notion reliées. Les faits expirent sauf s’ils sont renforcés. Les agents avec mémoire ont réussi 102 scénarios de test sur 149, sans mémoire 82. Source : notion.com/blog/building-shared-memory-for-ai-agents-in-notion
Par où commencer : le post renvoie vers un second-brain-os en Go, mais le lien est cassé dans l’article d’origine — les exemples directement citables restent les trois implémentations ci-dessus.
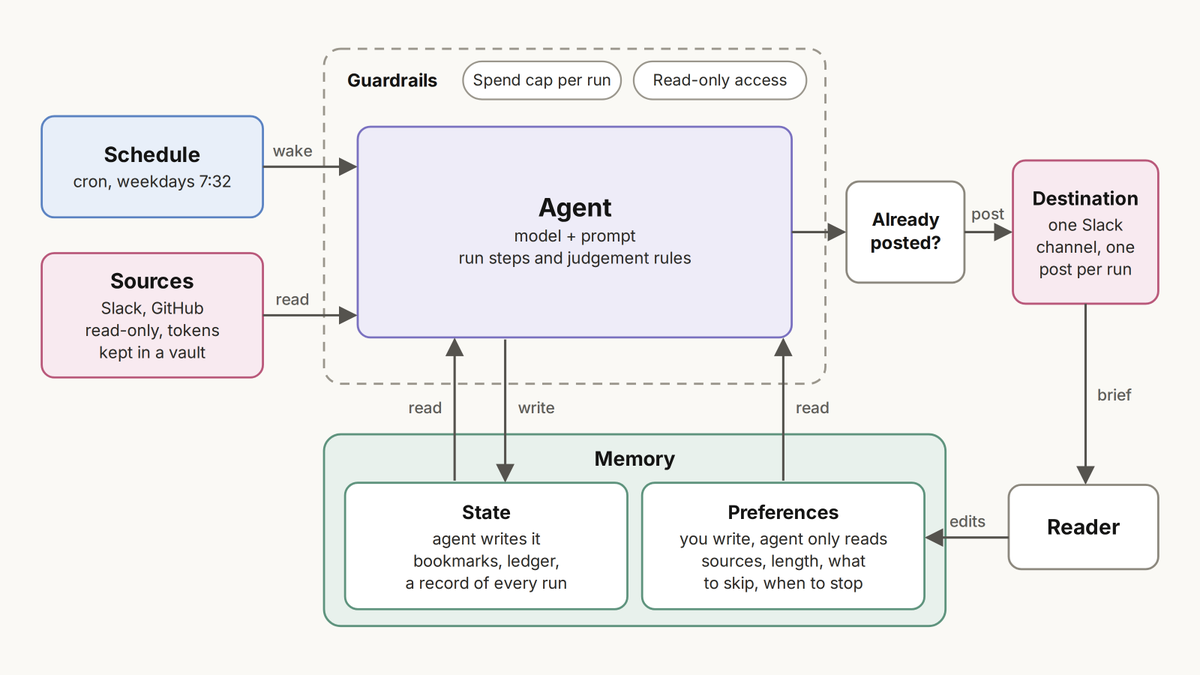
Setup 10 : agent d’automatisation planifiée
Ce qu’il fait : se réveille sur un planning, vérifie vos sources, et ne vous dit que ce qui a changé et ce qui vous attend. Aucun prompt nécessaire.
Comment c’est construit :
- Planning : une tâche cron démarre une session neuve à chaque exécution
- Sources : accès en lecture seule, identifiants gardés dans un coffre hors de l’agent
- Signets : l’agent se souvient où il s’est arrêté dans chaque source, au lieu de relire « les dernières 24 heures »
- Mémoire scindée en deux : les préférences que vous écrivez, l’état que l’agent garde pour lui
- Publication sûre : vérifier que le rapport du jour existe déjà, ne le compter comme envoyé que quand la destination confirme
- Budget : un plafond de dépense par exécution, pour qu’une boucle bloquée ne puisse pas brûler d’argent
Qui l’utilise
Anthropic. « Chez Anthropic, les automatisations d’agents simples sont fréquemment utilisées. » Leur brief quotidien de référence tourne sur Managed Agents chaque matin de semaine, lit Slack et GitHub depuis des signets par source, signale une source en échec comme illisible plutôt que comme une journée sans rien, et est plafonné à 5 $ par exécution. Source : claude.dev/blog/building-effective-agent-automations
GitHub. Les Agentic Workflows s’écrivent en markdown et sont compilés en GitHub Actions sur un planning quotidien. Lecture seule par défaut, écriture uniquement via des « safe outputs » approuvés, les PR ne sont jamais auto-mergées. GitHub Next dit trouver « de nouveaux usages pour les agentic workflows presque tous les jours ». Source : github.blog/ai-and-ml/automate-repository-tasks-with-github-agentic-workflows
Microsoft. L’Azure SRE Agent peut aussi tourner sur des tâches planifiées. Le même agent a obtenu 4,5/5 sur du travail planifié contre 1,7/5 sur des incidents à travers un plan de réponse large. Les tâches étroites et récurrentes sont là où les agents brillent. Source : techcommunity.microsoft.com/t5/apps-on-azure-blog/getting-the-best-out-of-azure-sre-agent/ba-p/4559745
Par où commencer : managed-agents/daily-brief dans anthropics/claude-quickstarts. Il y a aussi un exemple de triage Sentry planifié dans le même dossier.
Ce que tous les setups ont en commun
Dix métiers différents, dix entreprises différentes, et les mêmes règles qui reviennent :
- Un vérificateur séparé. L’agent qui fait le travail ne le note jamais. Spotify utilise un juge LLM, DoorDash une passe « disprove it », Shopify un modèle entièrement différent.
- Du code avant le modèle. Récupérer les données, lancer les vérifications et rassembler les preuves avec du code ordinaire d’abord. Le modèle ne fait que les parties qui demandent du jugement.
- Lecture seule par défaut. Tout ce qui change le monde réel passe par un humain : PR en brouillon, boutons d’approbation, validation du plan.
- Une preuve pour chaque affirmation. Une conclusion sans ligne de log, requête ou source derrière est supprimée.
- Des permissions étroites par tâche. Chaque métier ne reçoit que les outils dont il a besoin, rien de plus.
- De vrais cas de test. Anciens incidents, anciennes questions, anciennes PR, rejoués après chaque changement.
Copiez ces six règles et n’importe lequel des setups ci-dessus tiendra la route.
Par où commencer
Ne construisez pas les dix. Choisissez celui qui correspond à la partie la plus pénible de votre semaine :
- Submergé de petits tickets : agent de code en arrière-plan
- Des PR qui attendent des jours avant relecture : agent de revue de code
- Un changement à faire dans 500 endroits : agent de migration
- Réveillé par les alertes : agent d’astreinte
- Les mêmes questions de données tous les jours : agent analyste de données
- Les mêmes questions clients tous les jours : agent de support
- Cinq outils à vérifier chaque matin : automatisation planifiée
Commencez étroit, en lecture seule, avec un seul vérificateur par-dessus. Toutes les entreprises de cet article ont commencé pareil : une tâche ennuyeuse, mesurée, puis la suivante.
Le modèle est la partie facile. C’est le montage autour qui fait que ça marche.