Transformer Claude Code en équipe de recherche quant (cours complet)
Transformer Claude Code en équipe de recherche quant (cours complet)
Source: Hanako (@hanakoxbt) — article X du 19 octobre 2026 · 1 313 225 vues, 564 likes, 58 reposts, 38 citations
Article original : How to Build an AI Quant Research Team with Claude Code (Full Course) — lien
Demandez à Claude si une règle de trading fonctionne. Il répond en quatre secondes, avec une confiance totale.
Il n’a jamais vu le graphique. Il n’a jamais lancé le test. Il répond de mémoire.
Un modèle plus intelligent sans données, c’est juste une supposition plus convaincante. Et les modèles continuent de progresser — Opus 5.5, GPT-6 Sol, Fable 5.1, Jev pour les décisions à la milliseconde : chacun est un meilleur analyste que le précédent. Aucun ne vient avec un bureau.
C’est tout le problème, et ce n’est pas un problème de modèle. Un hedge fund n’est pas un génie dans une fenêtre de chat. C’est une équipe posée sur une machine :
- un entrepôt avec des décennies d’historique propre ;
- un cluster de recherche qui teste des idées en continu ;
- des gens dont le seul métier est de casser les résultats des autres ;
- un registre de toutes les idées déjà mortes.
Claude Code peut jouer chaque rôle de cette équipe. Il lui manque le bureau.
Réserve de lecture — l’article est aussi une démonstration produit pour QuantGPT, la plateforme dont dépend toute la seconde moitié du texte. Les chiffres de performance cités (6,8 % de croissance annuelle, Sharpe 0,61, 61 526 $ pour 10 000 $ investis) sont ceux de la « run publiée » par l’éditeur, bruts de frais. Ils ne sont pas reproduits ici.
Pourquoi une seule fenêtre de chat ne peut pas faire de la recherche quant
Un chat unique fait tout à la fois : il choisit l’idée, lance le test, note son propre travail et oublie l’ensemble quand vous fermez l’onglet. C’est exactement comme ça que naît la mauvaise recherche. Il manque quatre choses.
1. Les données
Votre IA n’a jamais vu un prix. Et même quand vous en collez un, la plupart des données grand public sont cassées de deux façons discrètes :
- Biais de survie — le jeu de données ne contient que les entreprises encore vivantes. Chaque faillite manque, donc chaque stratégie paraît meilleure qu’elle ne l’était.
- Biais d’anticipation — résultats trimestriels datés à la fin du trimestre plutôt qu’au jour de publication. Votre backtest connaît la nouvelle des semaines avant le marché.
2. Le calcul
Une question honnête n’est jamais un seul backtest. C’est cinq fenêtres de lookback, quatre règles de sortie et un contrôle hors échantillon pour chacune. À la main : une semaine. Sur un cloud : un prompt.
3. La séparation des rôles
L’agent qui a trouvé l’idée ne devrait jamais être celui qui la note. Dans un chat unique, c’est pourtant toujours le cas.
4. La mémoire
Un fonds se souvient de ce qu’il a déjà testé et de pourquoi l’idée est morte. Un chat oublie — vous retestez la même idée morte trois fois par an.
L’écart, mis côte à côte :
ROLE          A FUND HAS                      ONE CHAT WINDOW HAS
data          point-in-time warehouse         whatever you paste in
compute       research cluster                one answer at a time
review        a risk team that says no        the same model, agreeing
memory        a research archive              a closed tab
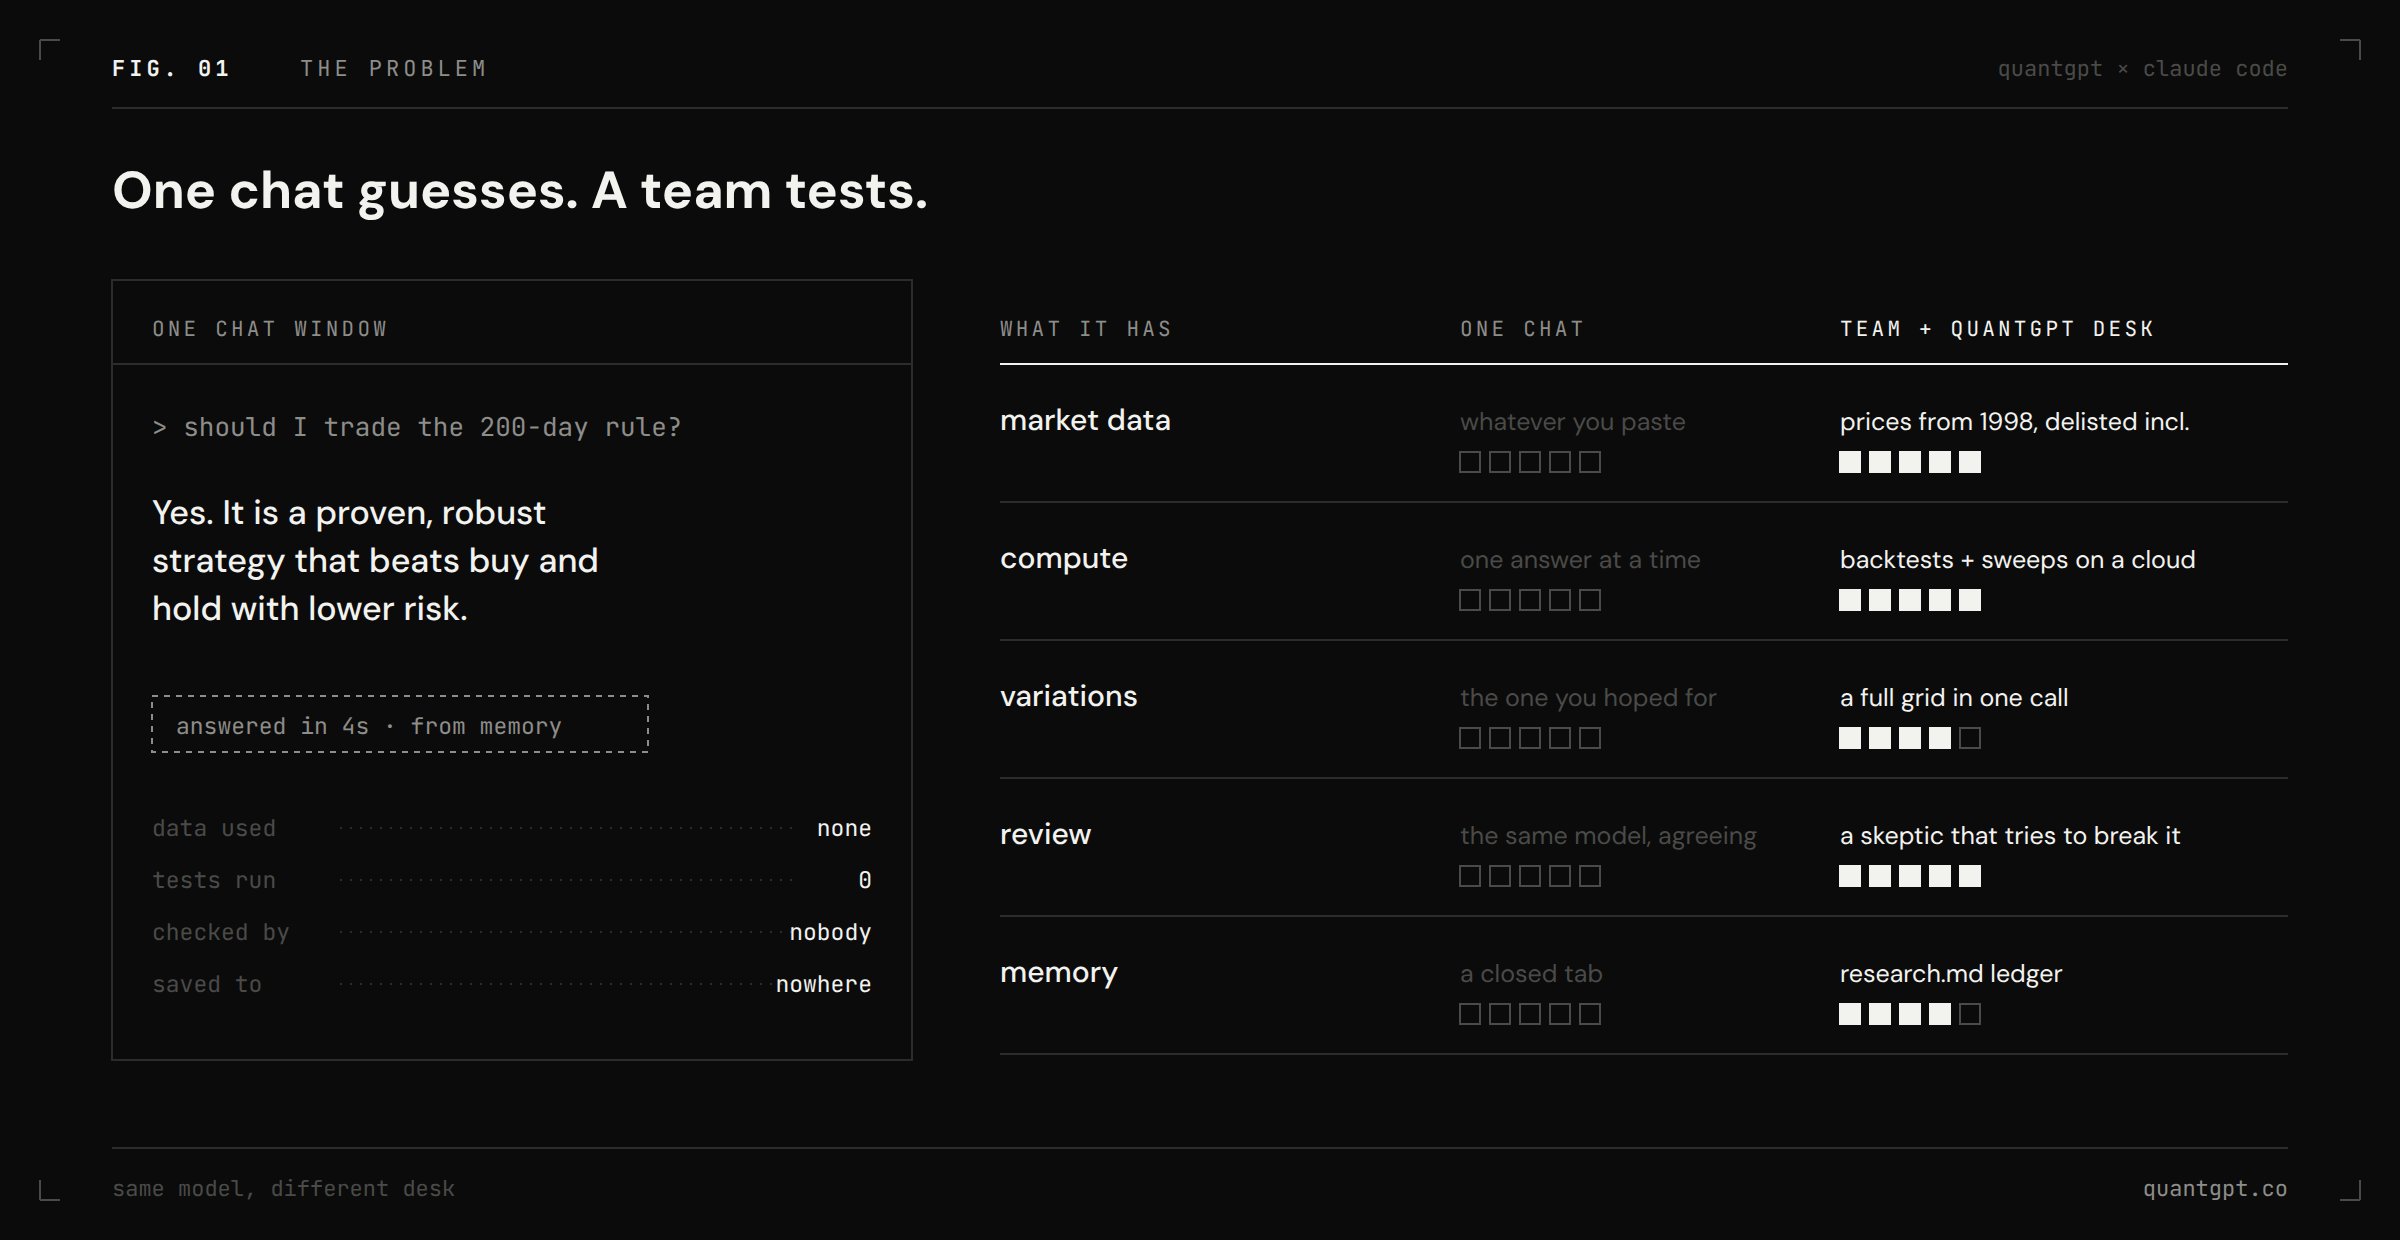
Pendant des années, seule la dernière colonne existait. Puis deux choses sont arrivées en même temps : les équipes d’agents dans Claude Code, et MCP.
Le bureau qui manquait à vos agents
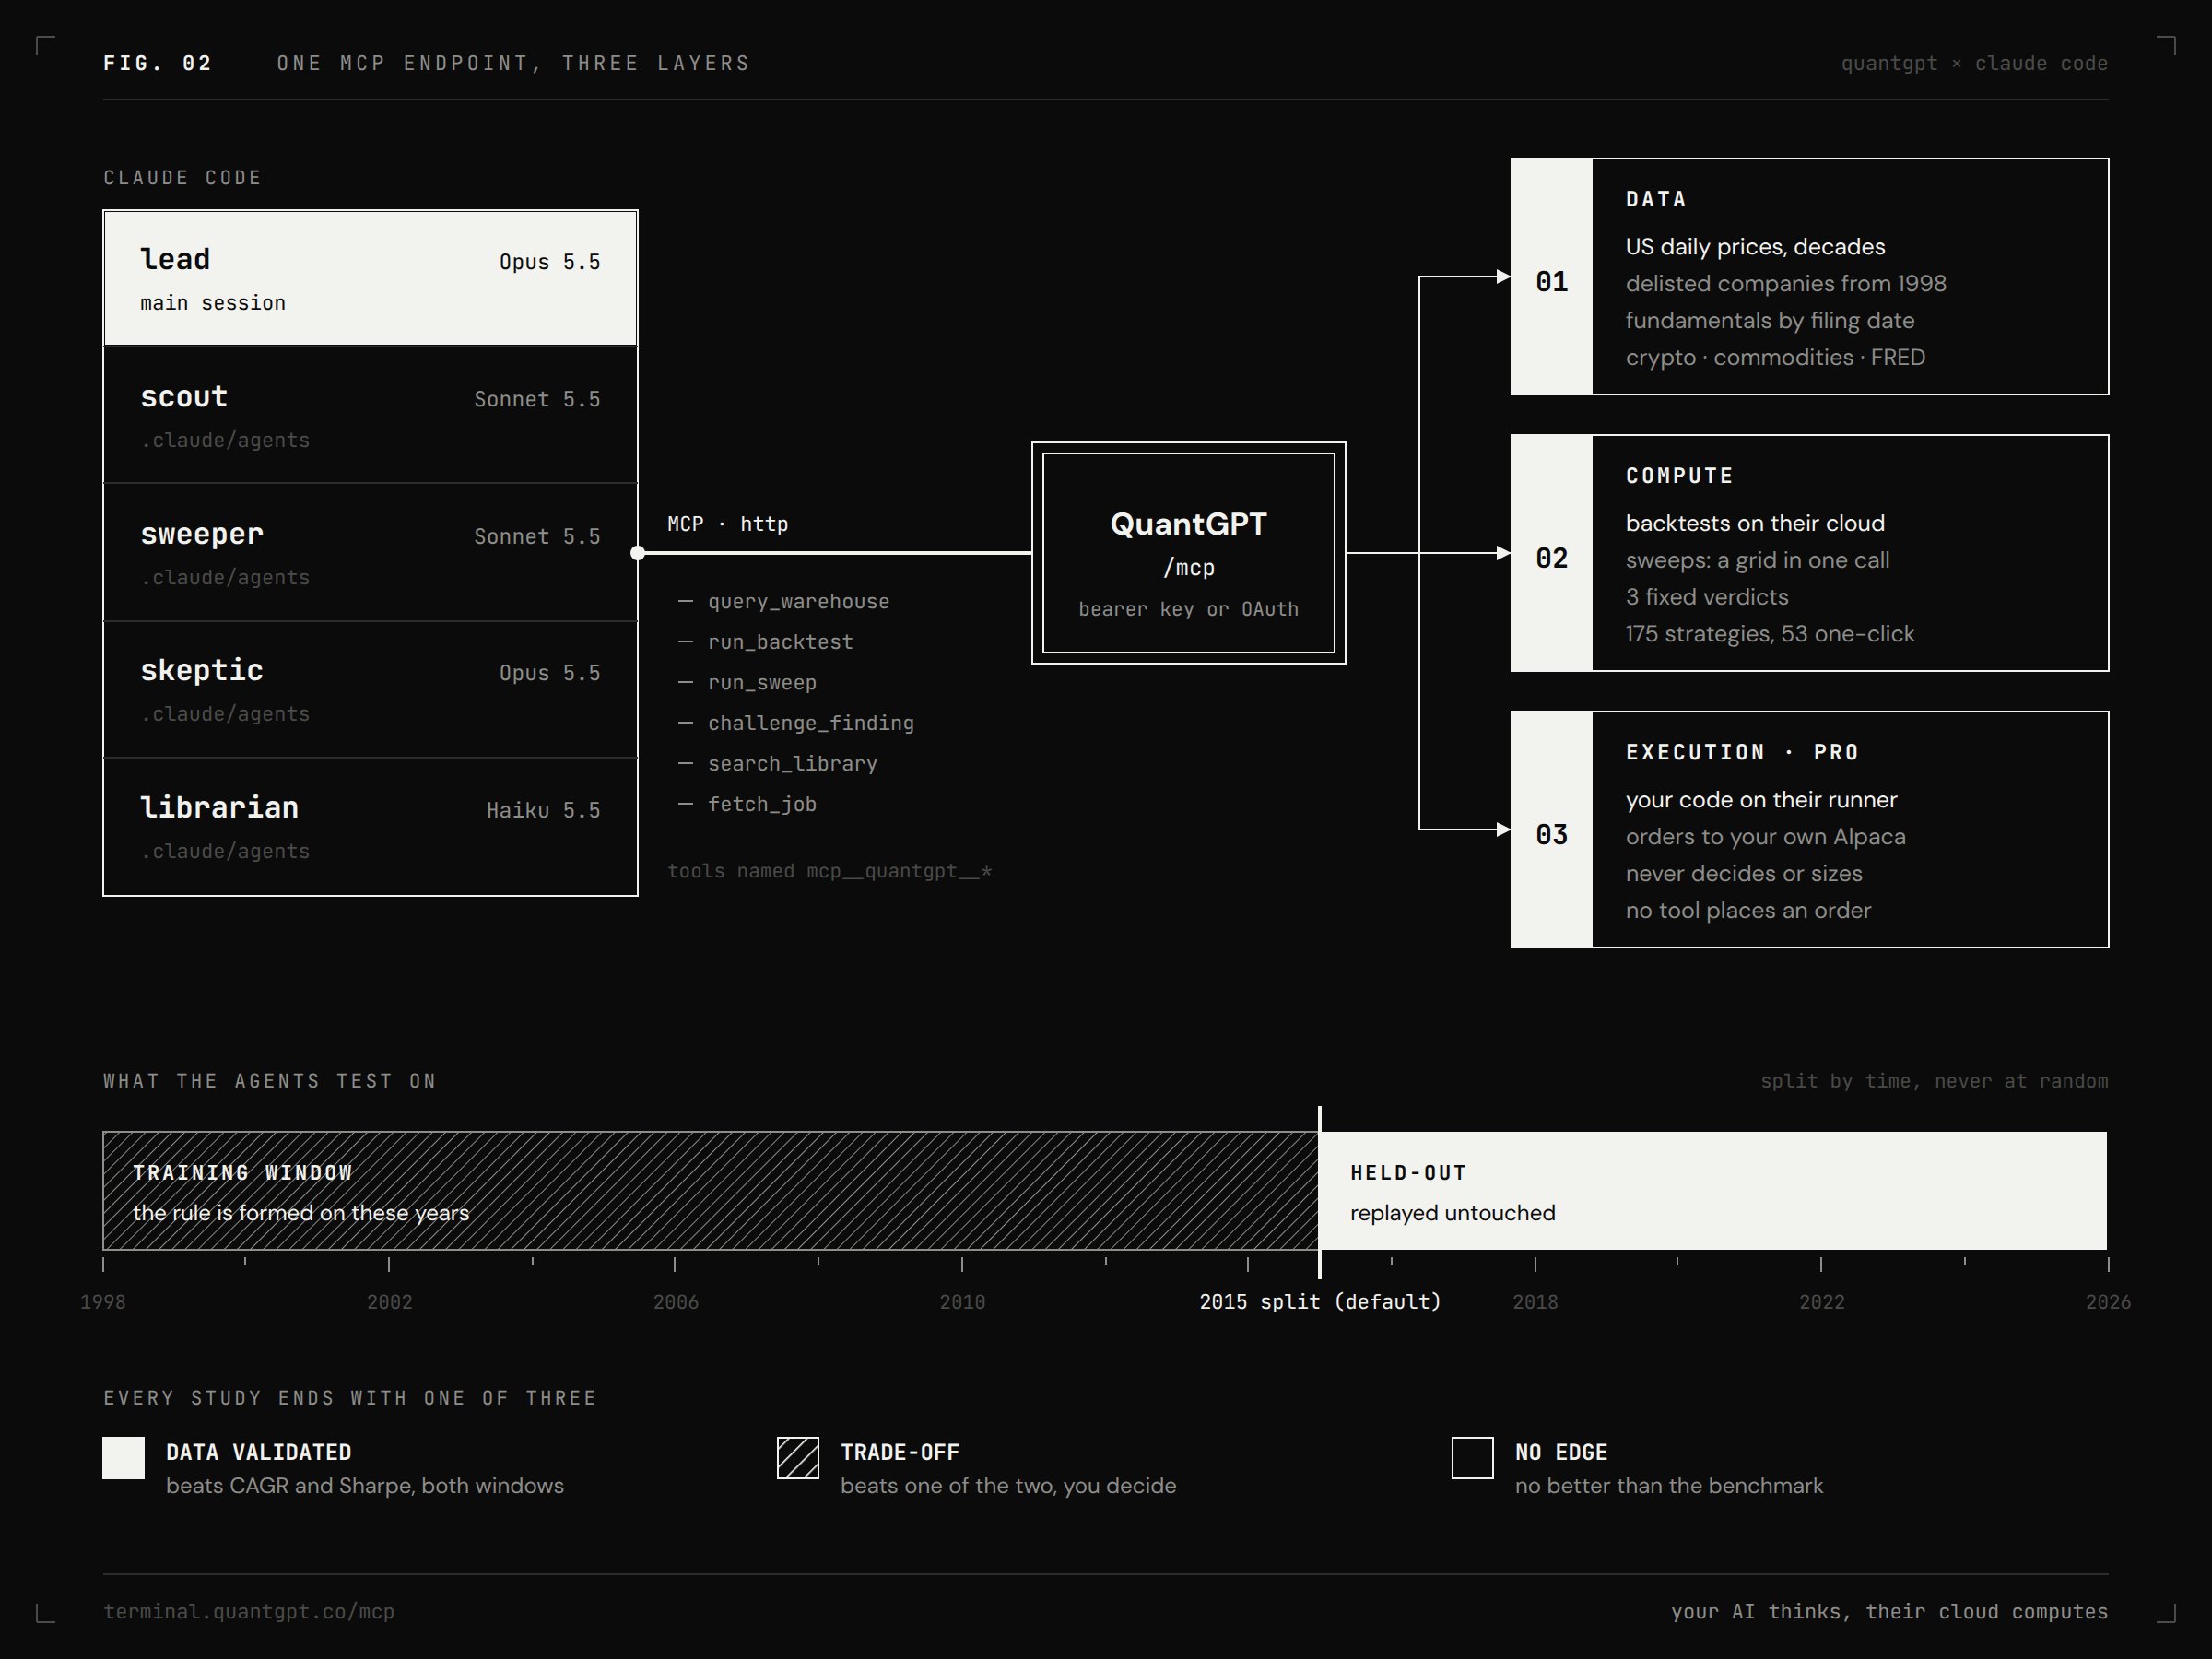
MCP (Model Context Protocol) est le standard ouvert qui permet à Claude d’appeler de vrais outils au lieu de les décrire. Pas « voici comment tu lancerais un backtest », mais : le lancer réellement.
Mais MCP n’est qu’un câble. Ce qui compte, c’est ce qu’il y a au bout. Ici, l’outil s’appelle QuantGPT, présenté comme issu du travail d’investissement systématique de ses fondateurs : le même entrepôt de données et la même infrastructure de trading cloud construits pour leur hedge fund, rebranchés sur votre IA.
Leur résumé : « Votre IA fait la réflexion, notre cloud fait le calcul, votre broker garde l’argent. »
Couche 1 : les données
L’entrepôt est rafraîchi chaque nuit. Et il n’y a pas besoin de le croire aveuglément : une page de vérification publique permet de comparer leurs prix à n’importe quelle source indépendante.
DATASET                          WHAT IT FIXES
US daily prices, decades         your AI finally sees real prices
delisted companies from 1998     survivorship bias in market-wide tests
fundamentals by filing date      look-ahead bias on earnings
crypto and commodities           more than one asset class in one place
FRED macro                       rates, inflation, the economy
Couche 2 : le calcul
Les backtests tournent sur leur cloud. Rien à installer.
Le choix de conception qui compte le plus : votre IA ne calcule jamais les nombres elle-même. Elle envoie les règles, le serveur les exécute sur l’historique stocké, et les résultats reviennent dans le chat. Aucun agent de l’équipe ne peut donc inventer un ratio de Sharpe qu’il n’a jamais calculé.
Chaque étude se termine par l’un de trois verdicts fixes :
DATA VALIDATED   beat the benchmark on BOTH growth (CAGR) and
                 risk-adjusted return (Sharpe), in the training
                 window AND the held-out window it never saw
TRADE-OFF        beat it on one of the two, you decide
NO EDGE          did no better than the benchmark
Chaque étude est découpée dans le temps à une année hors échantillon, 2015 par défaut. Les règles sont formées sur la fenêtre antérieure, puis rejouées telles quelles sur la suivante. Les découpages aléatoires sont refusés par conception, parce que mélanger le temps fait fuir le futur dans le passé.
C’est le point le plus important pour une équipe d’agents : le verdict est le contrat entre les agents. Personne ne discute avec lui.
Il existe aussi une bibliothèque de stratégies : 175 stratégies documentées issues de publications de recherche, d’investisseurs célèbres et de leurs lettres, dont 53 exécutables en un clic.
Couche 3 : l’exécution (Pro)
QuantGPT Cloud héberge votre propre code de stratégie, l’exécute selon votre calendrier et envoie les ordres à votre propre compte Alpaca, sous vos propres clés. Trois règles rendent cela sain :
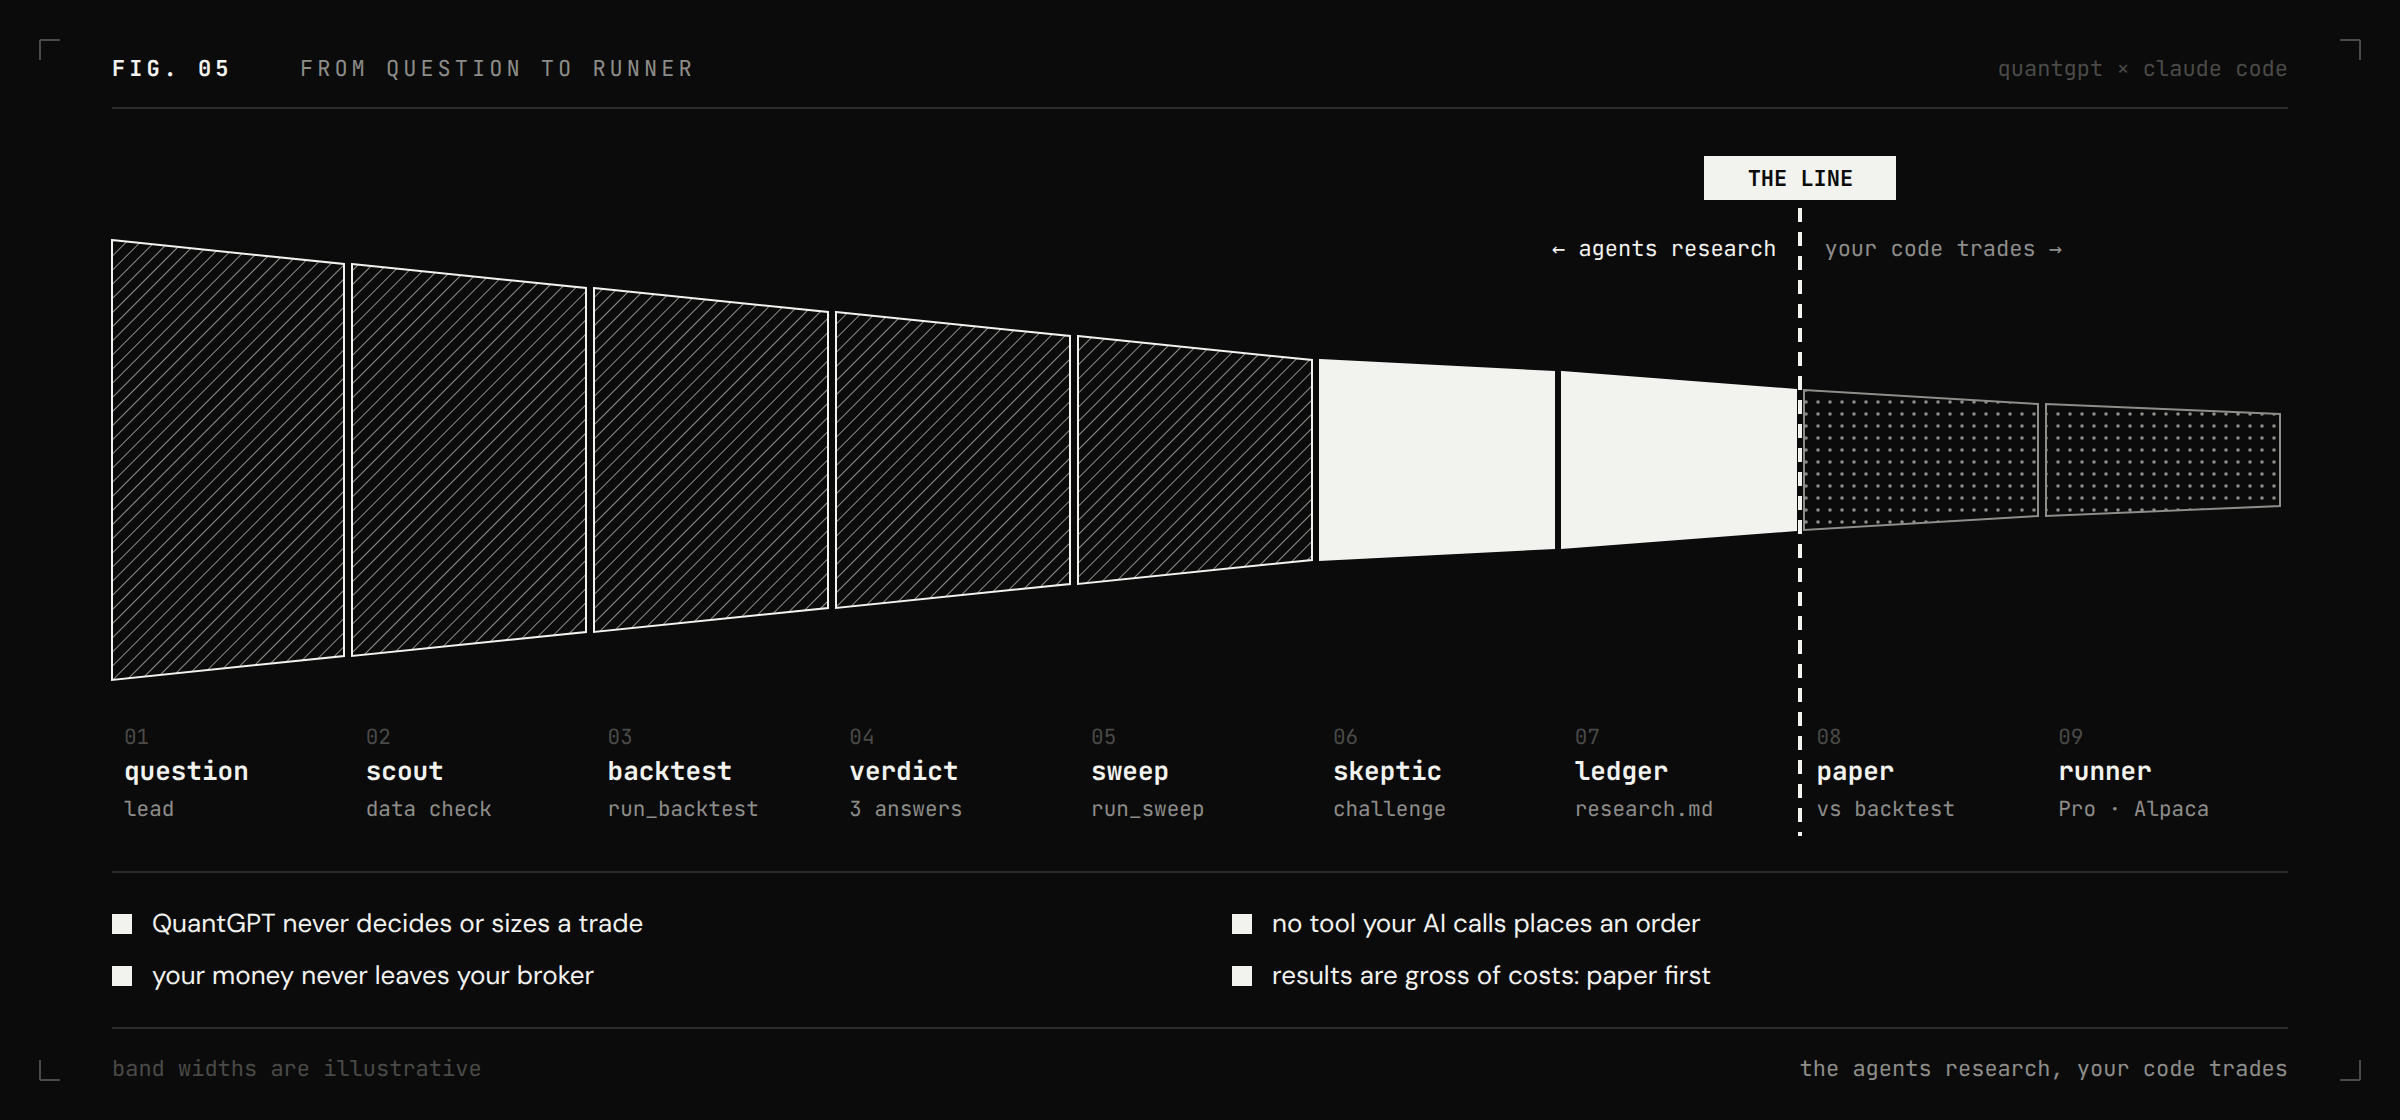
- QuantGPT ne décide, ne dimensionne et ne gère jamais un trade. C’est votre code qui le fait.
- Votre argent ne quitte jamais votre broker.
- Aucun outil appelable par votre IA ne passe, modifie ou annule un ordre.
Les agents font la recherche. Votre code trade.
Et l’on peut brancher n’importe quel client MCP — Claude Code, Claude Desktop, claude.ai — sur un seul point d’entrée : https://terminal.quantgpt.co/mcp. Quand le prochain modèle sort, on ne reconstruit rien : on échange l’analyste, le bureau reste.
Connecter Claude Code en 10 minutes
À faire une fois. Tous les agents de l’équipe héritent ensuite de la connexion.
Étape 1 — Créer un compte. Sur quantgpt.co. Démarrage gratuit sans carte (5 backtests, 5 appels IA) ou essai de 3 jours sur QuantGPT / QuantGPT Pro. L’essai demande une carte à l’avance ; rien n’est facturé si vous annulez avant la fin des 3 jours.
Étape 2 — Lancer un premier backtest à la main. Connectez-vous sur terminal.quantgpt.co, ouvrez la bibliothèque, choisissez Magic Formula, cliquez sur Run it. Lisez les critères, puis le finding en haut du résultat. À faire une fois soi-même : cela apprend à quoi ressemble un vrai résultat avant que les agents en produisent cinquante.
Étape 3 — Émettre une clé pour Claude Code. Ouvrez ACCOUNT, puis « Keys for your AI ». Copiez la valeur qg_sk_ immédiatement : elle n’est affichée qu’une fois.
Étape 4 — Ajouter le bureau à Claude Code :
claude mcp add --transport http quantgpt https://terminal.quantgpt.co/mcp \
  --header "Authorization: Bearer qg_sk_YOUR_KEY"
Étape 5 — Le laisser s’expliquer. Dans une nouvelle session Claude Code :
Call describe_capabilities from QuantGPT. List every tool you can use,
what each one is for, and which categories are switched off.
Then call available_categories and switch on equity and macro.
Après le premier appel, le voyant « AI » dans la navigation du terminal passe au vert. Les outils dans lesquels l’équipe va vivre :
query_warehouse      read prices, fundamentals, macro
run_backtest         test one rule on stored history
run_sweep            test a grid of settings in one call
challenge_finding    attack a finding and look for weak spots
search_library       search the documented strategies
fetch_job            collect long-running results
Deux notes avant de construire :
- Les appels IA sont plafonnés par jour et par compte, tous comptes et connexions confondus, et seuls les appels d’outils comptent. Une équipe d’agents les consomme vite : un seul métier par agent.
- Sur Claude Desktop ou claude.ai, aucune clé n’est nécessaire : ajoutez un connecteur personnalisé avec la même URL et connectez-vous. Si votre offre n’a pas d’option connecteur, QuantGPT fournit un « paste-pack » qui donne le contexte à l’IA sans MCP.
Recruter l’équipe
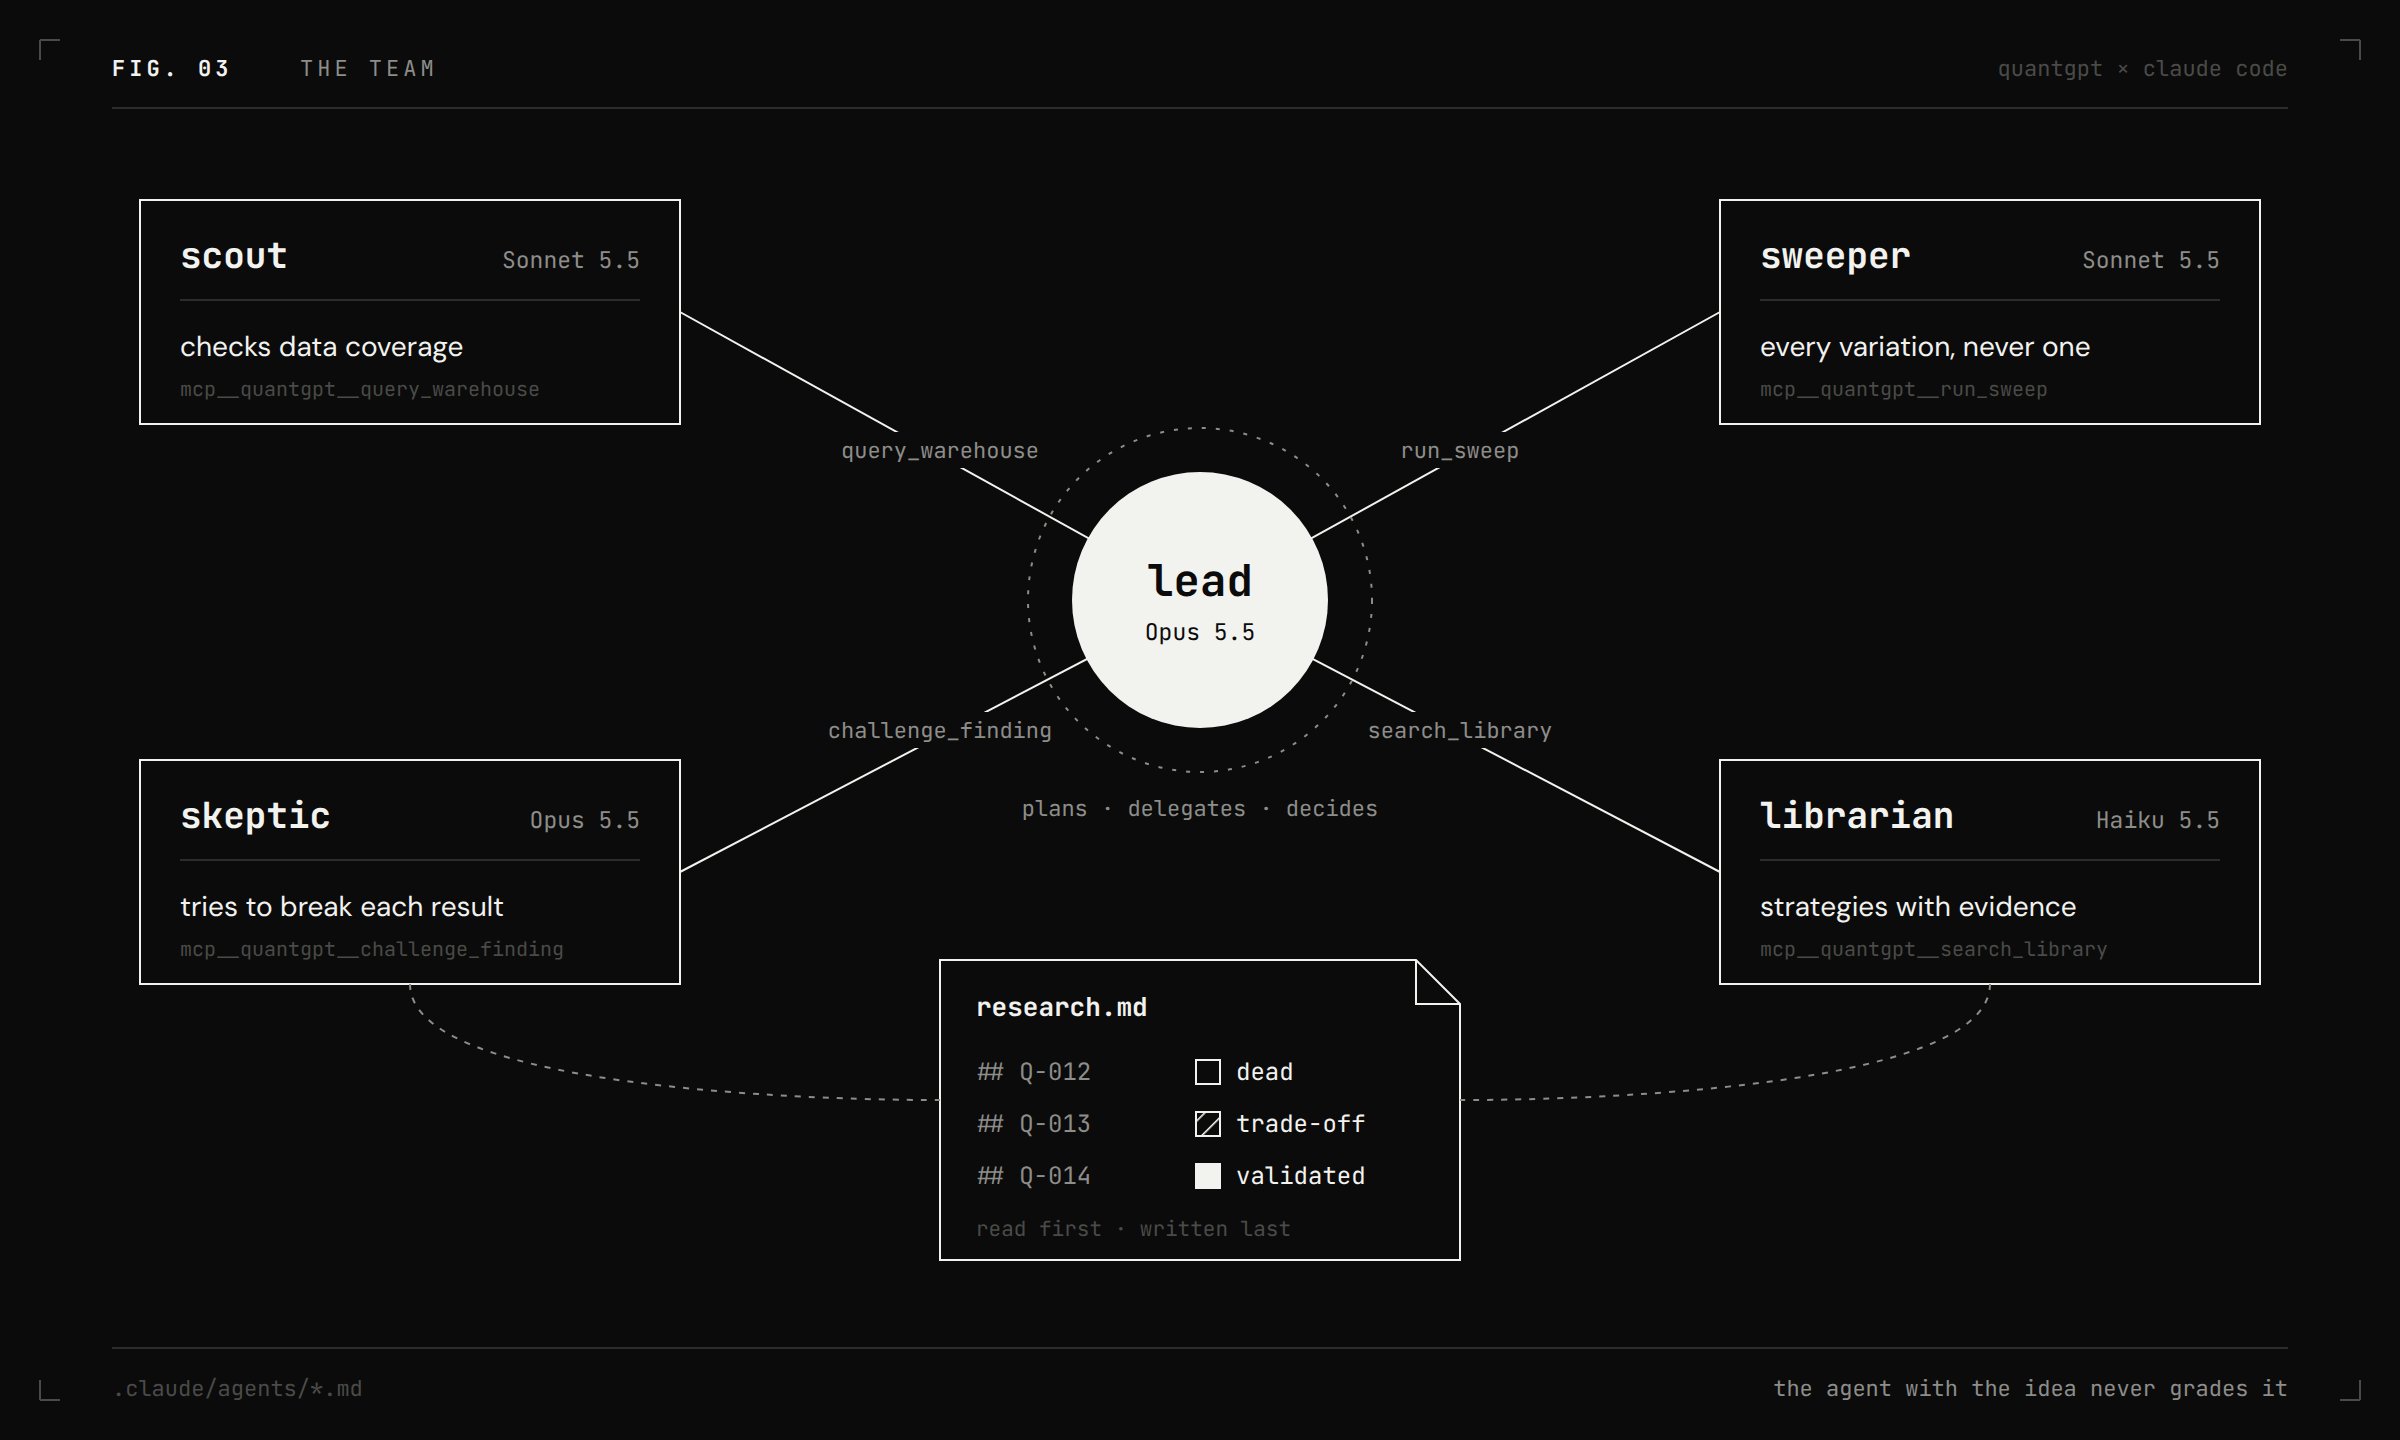
Dans Claude Code, chaque rôle est un sous-agent : un fichier markdown dans .claude/agents/, avec ses propres instructions, outils et modèle.
AGENT       MODEL        JOB
lead        Opus 5.5     turns a question into a plan, decides what runs next
scout       Sonnet 5.5   checks the data before anything is tested
sweeper     Sonnet 5.5   runs every variation of a rule, never just one
skeptic     Opus 5.5     tries to break every result before you see it
librarian   Haiku 5.5    finds strategies with evidence behind them
Le lead, c’est votre session principale. Les quatre autres sont des fichiers.
Le scout — vérifie la couverture des données avant toute étude :
---
name: scout
description: Checks data coverage before any study runs.
tools: mcp__quantgpt__query_warehouse
model: sonnet
---
Before any test, confirm the universe, the date range and the fields
the study needs. Flag gaps, delisted coverage before 1998, and any
fundamental that might not be point-in-time. Never run a backtest.
Le sweeper — balaie les paramètres, une règle à la fois :
---
name: sweeper
description: Runs parameter sweeps for one rule at a time.
tools: mcp__quantgpt__run_sweep, mcp__quantgpt__run_backtest, mcp__quantgpt__fetch_job
model: sonnet
---
Test one rule across a full grid of settings, never a single setting.
Return the grid, the verdict for every cell, and whether the
DATA VALIDATED cells form a plateau or a single isolated peak.
Never round, smooth or hide a failed cell.
Le skeptic — attaque chaque résultat avant qu’il soit accepté :
---
name: skeptic
description: Attacks every finding before it is accepted.
tools: mcp__quantgpt__challenge_finding, mcp__quantgpt__run_backtest
model: opus
---
Your only job is to make results fail. For every finding check the
held-out years, nearby settings, other universes and the worst
drawdown. Report the weakest point you found. If you could not break
it, list everything you tried.
Le librarian — trouve les stratégies déjà documentées :
---
name: librarian
description: Finds documented strategies that fit a research question.
tools: mcp__quantgpt__search_library
model: haiku
---
Search the library for strategies related to the question. Return
name, source, criteria and whether it runs in one click. Never test.
Le skeptic tourne volontairement sur le modèle le plus fort. Générer des idées ne coûte rien. Tuer les mauvaises, c’est là que l’argent est économisé.
Donner une mémoire à l’équipe
Un fichier que chaque agent lit en premier et écrit en dernier : research.md.
## Q-014  <the question, in one line>
status:   open | accepted | dead
verdict:  DATA VALIDATED | TRADE-OFF | NO EDGE
sweep:    <grid size>, plateau or single peak
skeptic:  <weakest point found, or everything tried>
next:     <next step, or "do not retest without a new reason">
Et quatre règles dans CLAUDE.md, obéies par toute l’équipe :
- Chaque test est consigné dans
research.mdavec son verdict, avant tout résumé. - Seuls les résultats
DATA VALIDATEDpassent à l’étape suivante. NO EDGEest un résultat, pas un échec. On le consigne et on ne reteste jamais sans raison nouvelle.- Un résultat n’est réel que si le skeptic n’a pas pu le casser.
L’équipe a maintenant une mémoire. Le mois prochain, elle ne perdra pas une journée sur l’idée tuée aujourd’hui.
D’une question à une règle qui survit
Le pipeline complet, de la question à l’exécution :
QUESTION → SCOUT → BACKTEST → VERDICT → SWEEP → SKEPTIC → LEDGER → PAPER → RUNNER (PRO)
Étape 1 — Partir d’une question, pas d’une stratégie
Donnez au lead la question que QuantGPT utilise sur sa propre page d’accueil :
Using QuantGPT, backtest the 200-day moving average rule on the
S&P 500 since 1999 against buy and hold. Plan the research first,
send the scout to check the data, then delegate.
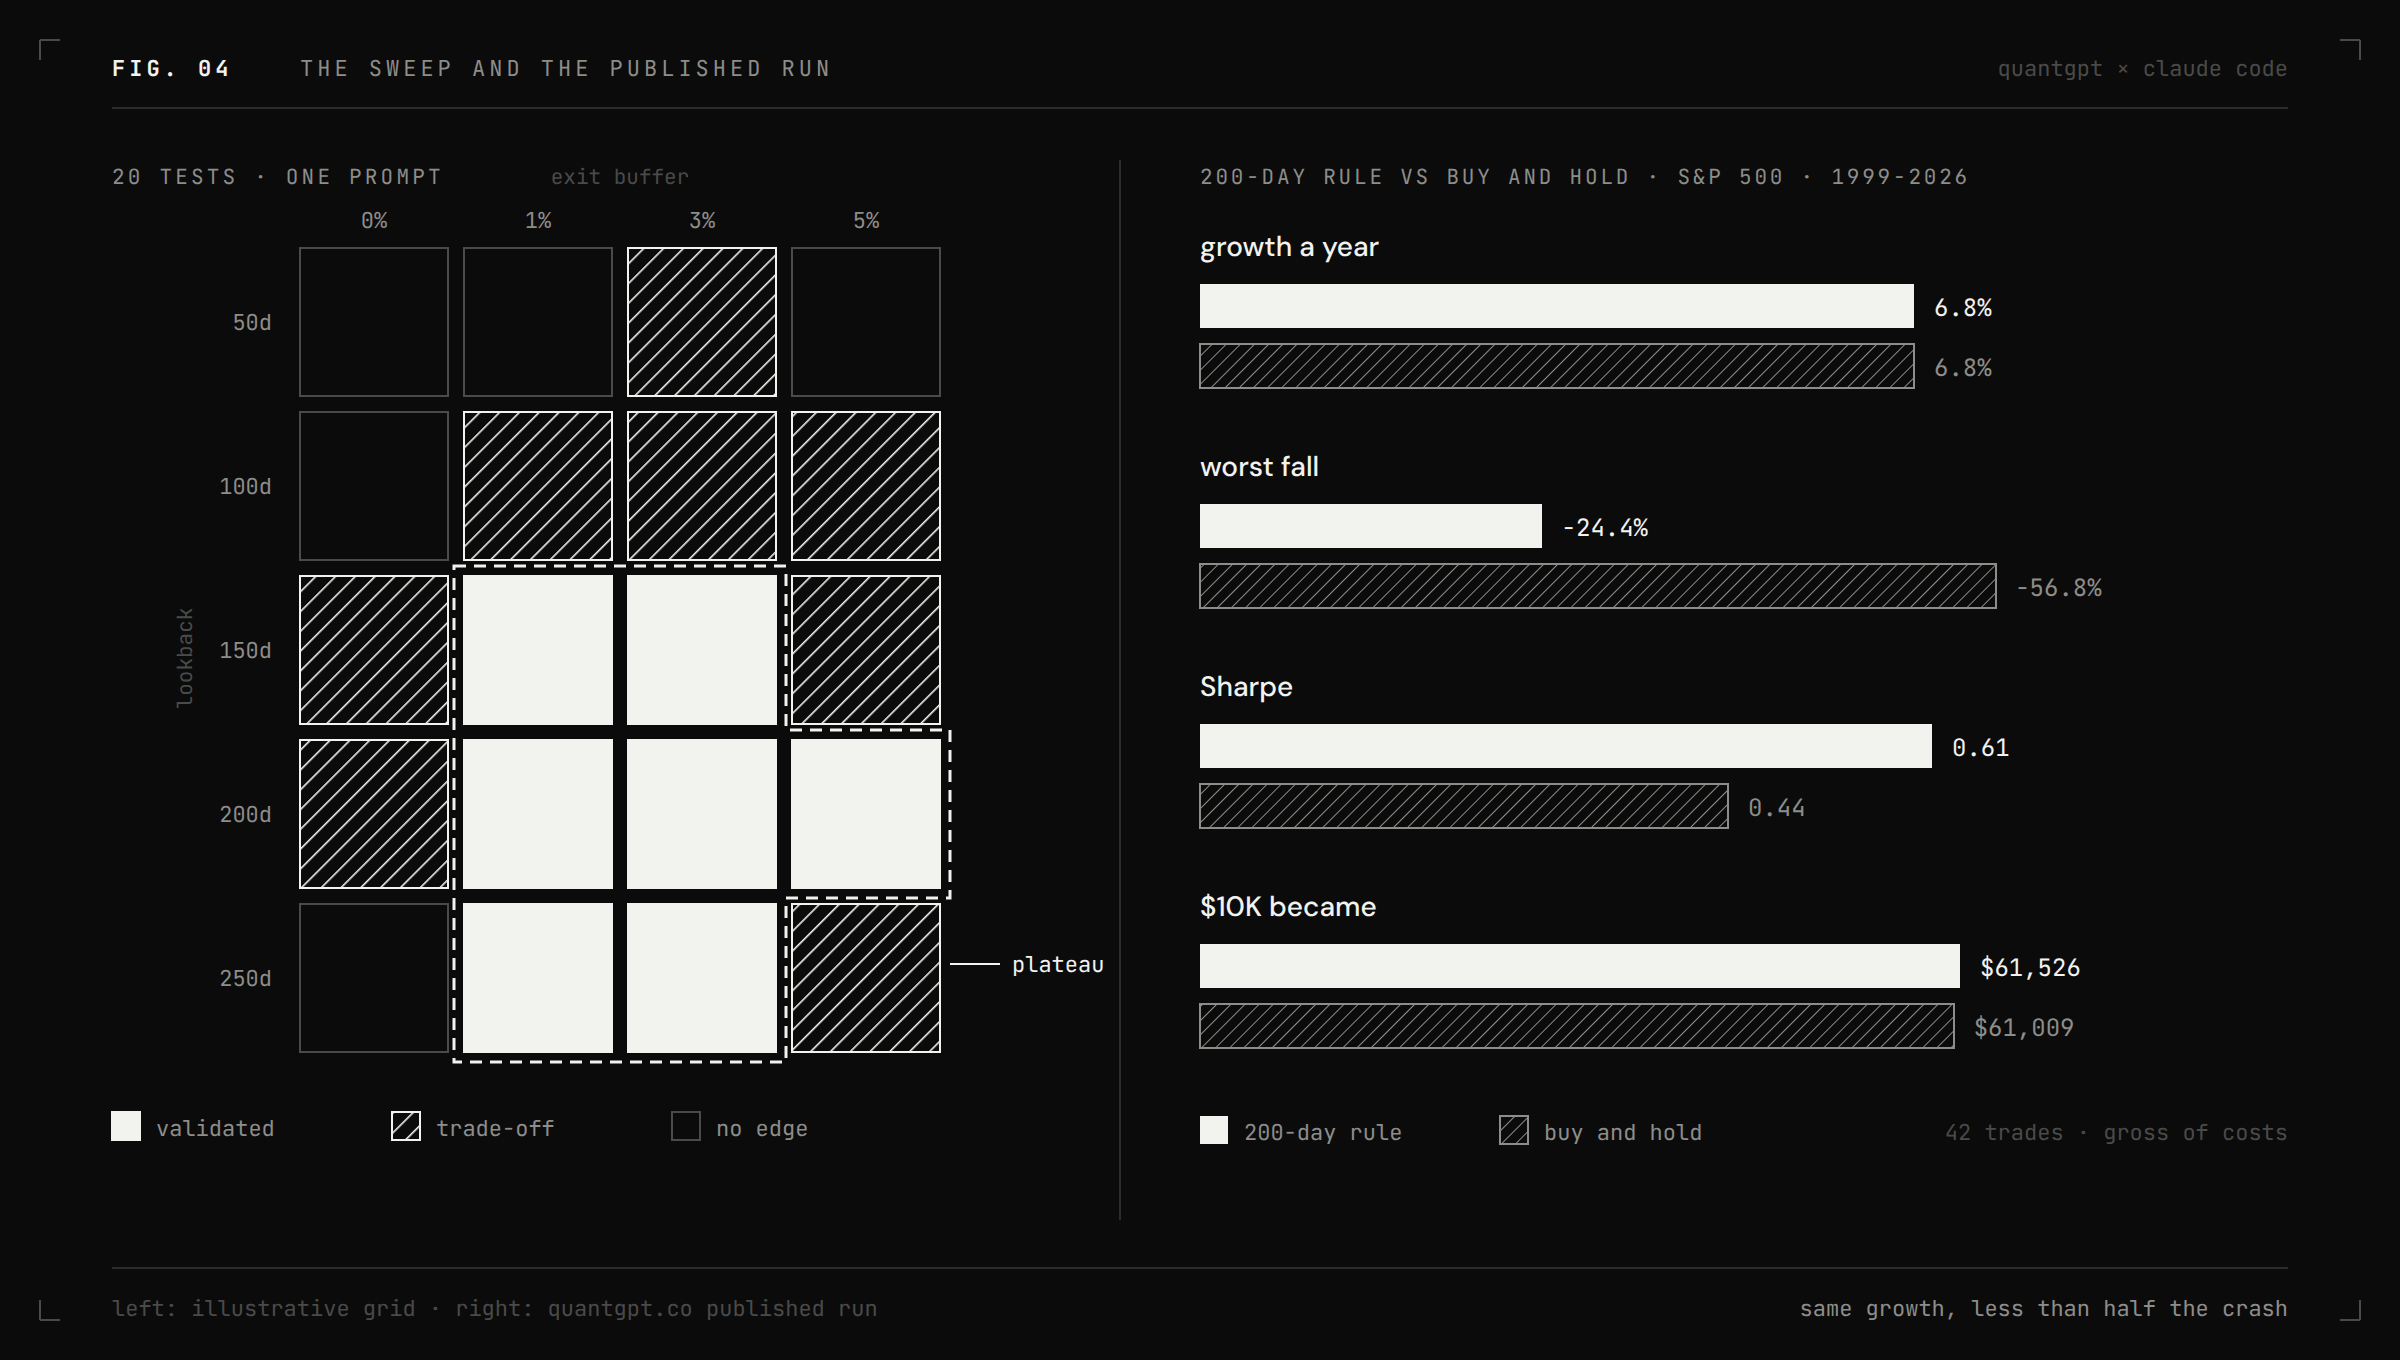
La réponse, issue de leur run publié, 1999 à 2026 :
                  200-DAY RULE    BUY AND HOLD
growth a year     6.8%            6.8%
worst fall        -24.4%          -56.8%
Sharpe            0.61            0.44
$10K became       $61,526         $61,009
Même croissance. Moins de la moitié du krach.
La règle : investi quand la clôture est à 1 % ou plus au-dessus de la moyenne 200 jours, sorti quand elle est à 3 % ou plus en dessous, en touchant le taux des T-bills pendant l’absence du marché. 42 trades, brut de frais de transaction.
C’est un résultat calculé sur de vraies données. Pas un paragraphe dont un modèle s’est souvenu.
Étape 2 — Lire le verdict avant la courbe
DATA VALIDATED, TRADE-OFF ou NO EDGE. Une courbe d’équité magnifique avec NO EDGE reste NO EDGE.
Un constat d’absence d’avantage économise plus d’argent que n’importe quel backtest gagnant ne vous en fera gagner.
Étape 3 — Balayer, jamais deviner
C’est là que le calcul change tout :
Sweeper: rerun the study with the moving average at 50, 100, 150,
200 and 250 days, and the exit buffer at 0%, 1%, 3% and 5%.
Return the verdict for every cell and tell me if the DATA VALIDATED
cells form a plateau or a single lucky number.
Vingt configurations depuis un seul prompt. Un vrai avantage tient sur les réglages voisins. Un avantage chanceux meurt à un pas.
Étape 4 — Laisser le skeptic attaquer les survivants
Skeptic: take every DATA VALIDATED cell from the sweep and try to
break it. Held-out years only, other universes, and the single
worst drawdown year. Log what you tried in research.md.
Étape 5 — Emprunter, ne pas inventer
La prochaine idée doit venir de preuves, pas d’une intuition :
Librarian: find momentum and value strategies in the library.

Lead: run Piotroski F-Score and 52-Week High Momentum from 2000,
compare them on the years after 2015 only, and log both verdicts.
Étape 6 — Répéter jusqu’à ce que le registre pense à votre place
Chaque branche terminée laisse un meilleur point de départ à la suivante. C’est la différence entre un chat et une équipe : l’équipe capitalise.
Étape 7 — Le papier d’abord
Faites tourner la règle survivante en paper trading et comparez avec le backtest. Les backtests sont bruts de coûts : un avantage mince peut disparaître après frais et slippage.
Étape 8 — Déployer sur le runner (Pro)
Chargez le lead de transformer la règle validée en code. QuantGPT Cloud héberge ce code, l’exécute selon votre calendrier et envoie les ordres à votre compte Alpaca. Votre code décide. Vos clés signent. Votre argent reste chez votre broker.
Le contrat honnête
Ce dispositif peut :
- donner à chaque agent des décennies de données de marché réelles, entreprises radiées incluses depuis 1998 ;
- lancer backtests et balayages sur un cloud plutôt que sur votre laptop ;
- noter chaque résultat sur des années qu’il n’a jamais vues ;
- séparer l’agent qui a l’idée de l’agent qui la juge ;
- se souvenir de chaque idée morte pour ne jamais la tester deux fois ;
- héberger votre propre code chez votre propre broker (Pro).
Ce dispositif ne peut pas :
- garantir un profit ;
- modéliser frais, taxes ou slippage — chaque résultat est brut ;
- trader à votre place, décider ou dimensionner une position ;
- transformer une idée faible en avantage.
Conclusion
Tout le monde continue d’améliorer l’analyste. Un nouveau modèle chaque mois, chacun plus intelligent que le précédent.
Mais un analyste sans bureau devine toujours. Et un analyste sans équipe continue de noter son propre devoir.
Donnez un bureau à votre IA. Donnez une équipe au bureau. Donnez une mémoire à l’équipe. Puis laissez les verdicts décider.
Ce qui reste à vérifier
Trois réserves, dans l’ordre d’importance :
- C’est un article de promotion. QuantGPT est le produit autour duquel tout l’article est construit, et le lien d’entrée est mis en avant dès l’introduction. L’architecture des agents (rôles séparés, balayage systématique, skeptic, registre) reste transposable à n’importe quel autre entrepôt de données ; le reste est un argumentaire commercial.
- Les performances ne sont pas sourcées indépendamment. Les 6,8 % / −24,4 % / Sharpe 0,61 proviennent de la « run publiée » par l’éditeur, sur la période 1999–2026, bruts de frais. La mention « même croissance, moins de la moitié du krach » porte sur le drawdown maximal, pas sur le rendement total (61 526 $ contre 61 009 $, soit 0,8 % d’écart sur 27 ans).
- Les modèles cités ne sont pas vérifiables depuis le post. Opus 5.5, Sonnet 5.5, Haiku 5.5, GPT-6 Sol, Fable 5.1 et « Jev » sont mentionnés comme disponibles ; l’article ne fournit aucune source, et les noms de modèles évoluent vite. Les fichiers d’agents utilisent les alias
sonnet,opus,haiku, qui restent valides quel que soit le numéro de version.