Vos agents de code ont fait de vous un manager
Vos agents de code ont fait de vous un manager
Source: Addy Osmani (@addyosmani) — post du 8 novembre 2026 · 393 820 vues, 3 548 likes, 392 reposts
Article long-form original : « Your coding agents made you a manager » — x.com/i/article/2118901185377964033 · version web : addyosmani.com/blog/coding-agents-manager
« The skills for managing agents are pretty much the skills for managing a team, and you don’t need to be a manager to learn them. »
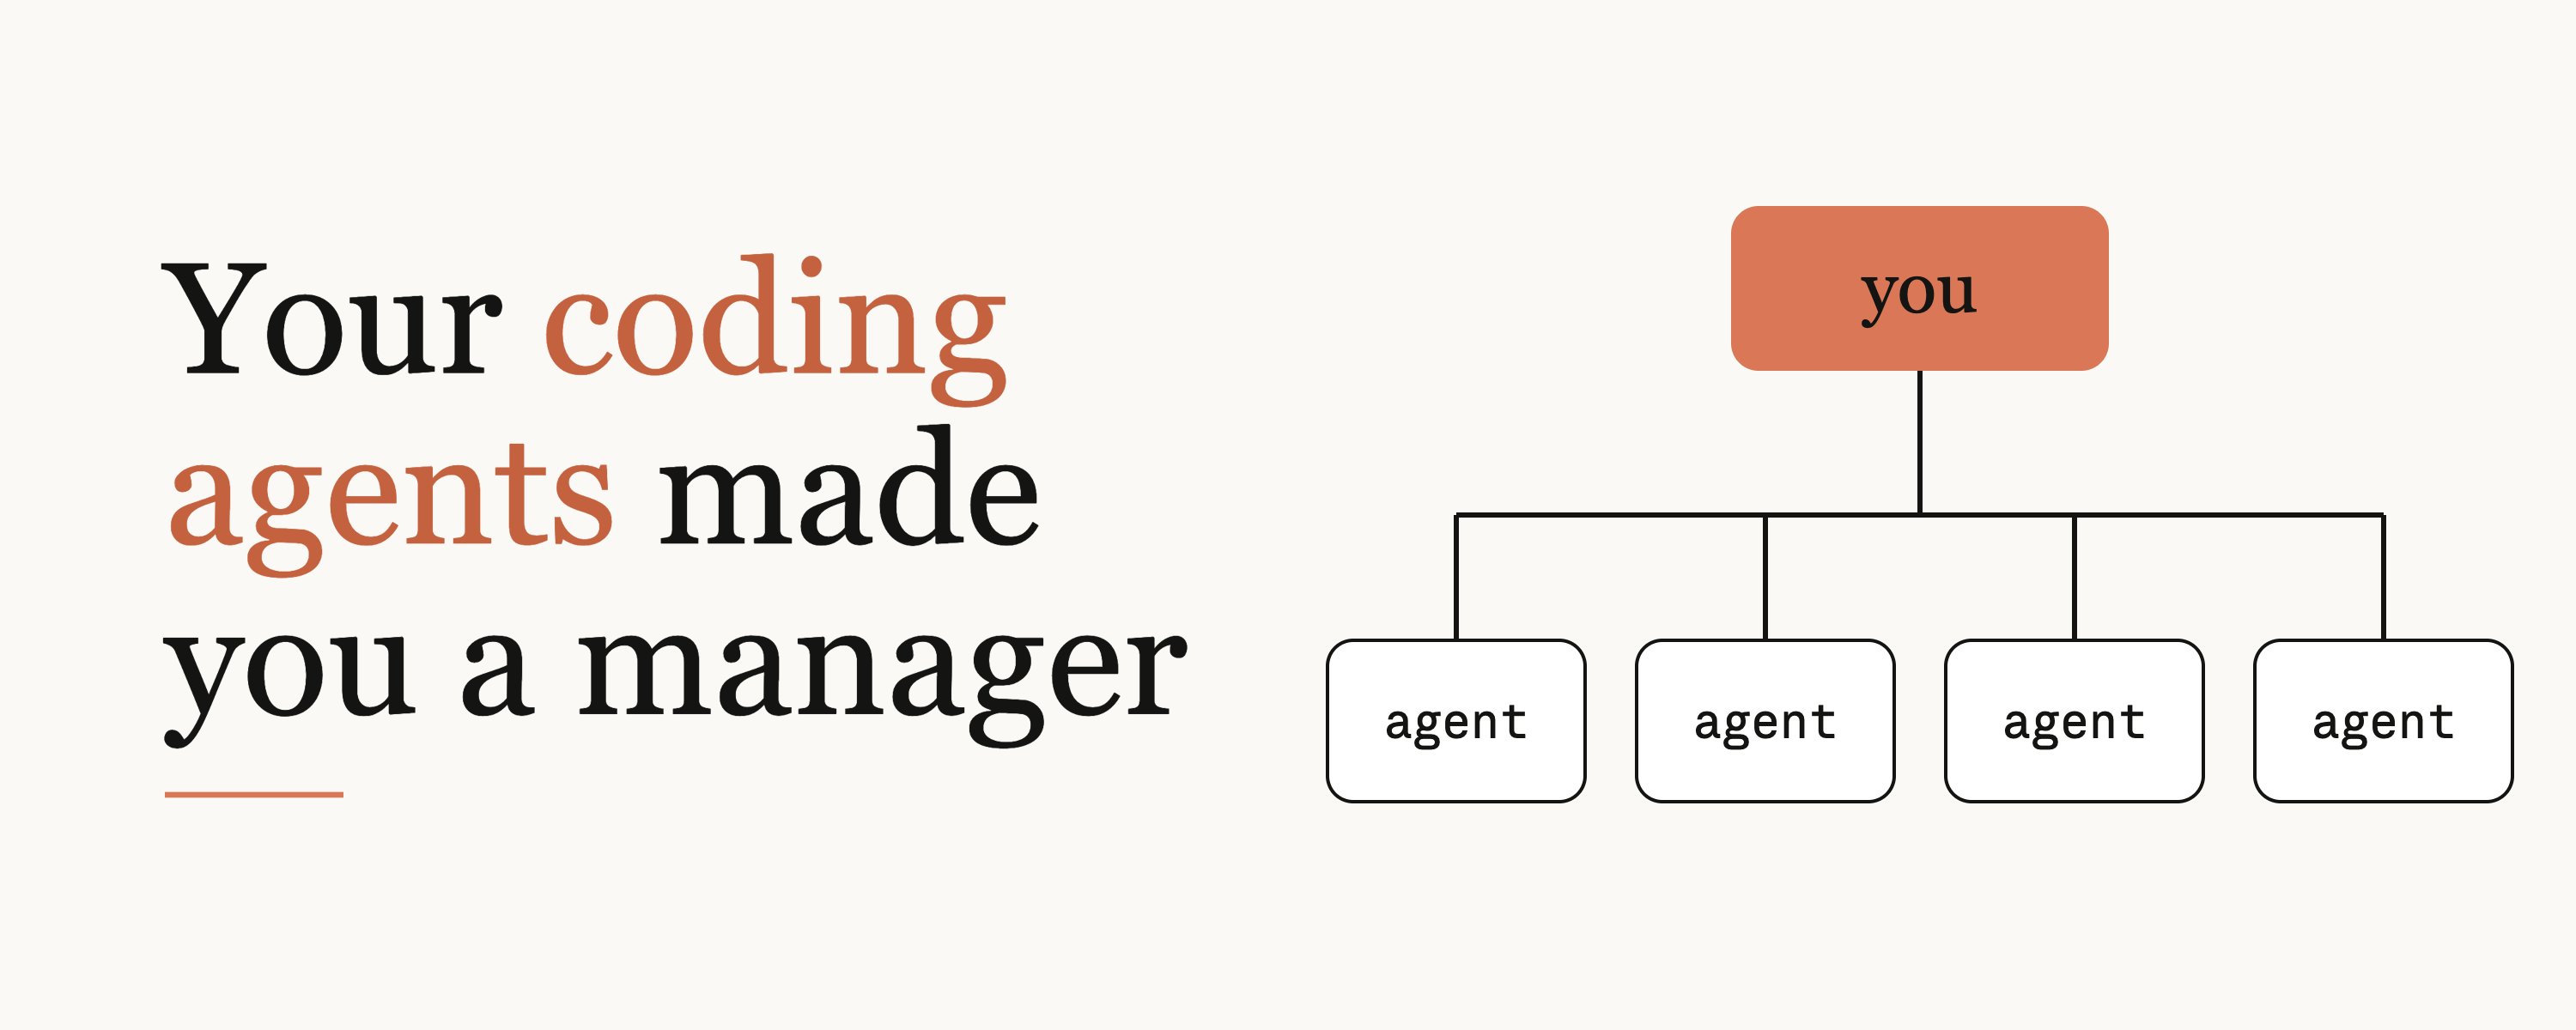
Si vous passez toute la journée avec un agent de code, vous managez. Vous sélectionnez sans cesse des tâches, écrivez des instructions, déléguez, relancez, évaluez les résultats et décidez de ce qui part en production. Les ingénieurs qui tirent le meilleur des agents ne sont pas forcément les meilleurs en prompt engineering — ce sont ceux qui ont appris à manager, volontairement ou non.
L’idée peut déplaire. Beaucoup d’ingénieurs admirés ont choisi la piste IC (individual contributor) justement pour rester près du travail. Ils ont vu des amis devenir managers et disparaître dans leurs agendas. Mais il ne s’agit pas de ça : « management » est pris ici au sens précis de produire de bons résultats en rendant possible le travail des autres. Et les agents ne remplacent ni les managers ni les collègues.
Chaque reproche que vous faites aux mauvais managers est un rapport de bug pour interagir avec les agents. Prenez le handoff : un brief vague, sans contexte, avec des attentes qui glissent. La bonne nouvelle pour les IC, c’est qu’ils en reçoivent depuis des années — ils savent donc à quoi ressemble un bon.
Le billet croise les pratiques des bons managers d’ingénierie avec ce qu’Anthropic a appris en utilisant et en créant Claude Code. Les sections sont à peu près ordonnées par impact, l’habitude la plus rentable d’abord.
Donnez-lui un moyen de vérifier son travail
Bonne pratique : donner à l’agent un mécanisme pour valider son travail — suite de tests, build ou capture d’écran — et lui faire montrer les résultats comme preuve.
Anti-pattern : prendre « ça a l’air fini » comme confirmation. Vous faites alors toute la validation vous-même et devenez la suite de tests de l’agent.
Demandez à un manager expérimenté comment il garantit la qualité tout en lisant tout, il vous parlera de garde-fous : CI, code review, dashboards, astreinte. Les managers inexpérimentés qui ne construisent pas de garde-fous finissent par tout valider eux-mêmes — et deviennent le goulot d’étranglement en un trimestre. Même chose avec les agents : comme l’explique le guide des bonnes pratiques Claude Code, un agent s’arrête quand le travail semble fini. Sans validation, « semble fini » est sa seule validation. Avec un mécanisme de validation, l’agent fait le travail, lance le vérificateur, voit l’échec et se corrige seul. Pour un changement d’UI, ça peut vouloir dire ouvrir la page dans un navigateur et itérer jusqu’à ce que ça marche et que ce soit beau.
Le mécanisme peut être presque n’importe quoi, du moment qu’il donne un verdict binaire : tests, codes de sortie de build, linters, scripts de diff, captures d’écran. Le guide note que la commande qui lance ces validations est la ligne la plus utile qu’on puisse mettre dans son CLAUDE.md. Ensuite, plusieurs façons de l’intégrer au flux :
- Demander. « Lance les tests auth ensuite, et continue jusqu’à ce qu’ils passent. »
- Fixer un objectif. Avec
/goal, un modèle séparé vérifie la condition après chaque tour — surtout utile pour du long travail en arrière-plan. - Imposer. Un hook Stop peut empêcher le tour de se terminer tant que le typecheck ne passe pas.
- Faire relire.
/code-reviewenvoie le diff à un nouveau subagent (qui n’a pas vu votre conversation), comme un auteur n’approuve pas ses propres PR.
On peut même cadrer le périmètre de la review : si vous demandez de trouver des problèmes, elle en trouvera toujours. Demandez plutôt les problèmes de correction en ignorant le style. C’est aussi comme ça que les bons managers demandent du feedback. Skills, hooks, subagents, MCP : presque tout l’outillage sert à resserrer cette boucle entre faire et vérifier, pour que votre attention ne porte plus que sur ce que l’agent n’a pas pu valider.
Donnez un contexte clair
Bonne pratique : fournir un résumé clair de ce que l’agent ne peut pas savoir en lisant le dépôt — l’objectif et pourquoi c’est important, les contraintes, le hors-périmètre, les critères de réussite.
Anti-pattern : passer une tâche en une ligne dont les vraies attentes restent dans votre tête — ou noyer le brief dans ce que l’agent découvrirait tout seul en lisant le code.
Les managers efficaces décrivent le résultat attendu, les contraintes et les objectifs — puis laissent la personne libre de trouver le comment. Dans l’armée on appelle ça la commander’s intent ; chez Netflix, « context, not control ».
La difficulté, c’est de savoir ce que l’agent ignore. La première chose qu’il fait sur chaque tâche : lire votre code. Les modèles actuels repèrent votre arborescence, vos conventions et votre setup de tests bien plus vite que vous ne pourriez les décrire. Avant d’écrire quoi que ce soit, demandez-vous ce que l’agent peut trouver seul : s’il peut le lire dans le code — et qu’il le lira de toute façon — ne dites rien. Dépensez vos mots sur ce qui n’est pas dans le dépôt : une décision prise en réunion, le process interne de déploiement de quelqu’un, pourquoi cette tâche compte, ce que « terminé » veut dire cette fois-ci.
Exemple : transformer la tâche vague « rendez le dashboard plus rapide » en prompt (les chiffres ne sont qu’un exemple).
Get p95 load time for the /team dashboard under 2s for orgs with 10k+ members.

Why: enterprise admins open it daily, and slow loads are their top support ticket.

Constraints: no schema changes; keep the API response shape.

Out of scope: UI changes; caching the whole page.
Check: run scripts/perf/team.sh and show before and after numbers.
Inutile de le faire pour chaque tâche. En exploration, un prompt générique est très bien — vous affinerez en avançant. Si vous n’êtes pas prêt à écrire le prompt, faites interviewer l’agent jusqu’à ce qu’il puisse écrire le spec, enregistrez ce spec dans un fichier, puis ouvrez une nouvelle session pour construire à partir de là — et servez-vous-en ensuite comme base de review.
Il faut parfois aussi donner à l’agent accès à d’autres outils : tracker d’issues, dashboard d’erreurs, chat d’équipe. Traitez-le comme une nouvelle recrue. Pour un outil CLI qu’il connaît déjà, comme gh, vous n’aurez souvent rien à dire.
Chaque correction doit se cumuler
Bonne pratique : dès que vous corrigez la même chose plus d’une fois, l’écrire dans le CLAUDE.md de l’équipe ou en faire une skill partagée. Au fil du temps, vérifier si les nouveaux modèles rendent ces corrections inutiles.
Anti-pattern : corriger manuellement la même chose à chaque session, ou s’appuyer sur un savoir tacite qui n’existe que sur votre machine.
Les équipes qui maximisent la valeur de CLAUDE.md le mettent à jour régulièrement avec les leçons des erreurs valant la peine d’être évitées. Certaines mentionnent même @claude dans les code reviews, transformant le feedback en politique permanente. Gardez-le concis. Ce qui a sa place dedans :
- comment vérifier quelque chose (commandes exactes) ;
- les zones trompeuses du code ;
- les décisions qui n’existent pas dans le dépôt ;
- tout ce que vous avez corrigé deux fois.
C’est la nature cumulative de l’information écrite : elle survit aux changements d’équipe et aux remplacements de modèles.
Laissez-le décider, et n’imposez que l’intangible
Bonne pratique : laisser l’agent décider par défaut, et réserver l’enforcement dur (hooks, règles deny) aux rares choses qui doivent toujours — ou jamais — se produire.
Anti-pattern : écrire des règles en MAJUSCULES, définir des hooks pour des préférences optionnelles, ou conserver des habitudes datant d’anciens modèles bien après que les nouveaux les ont dépassées.
Andy Grove, dans High Output Management, parle de task-relevant maturity : le niveau de supervision doit dépendre de l’historique de la personne sur cette tâche précise, pas de sa compétence globale. Le vieux conseil aux nouveaux managers dit la même chose : donnez un peu plus de latitude qu’il ne vous est confortable, tout en soutenant et en responsabilisant.
Claude Code rend cela explicite : les prompts, CLAUDE.md et skills sont des requêtes que le modèle peut considérer et choisir de suivre ; les hooks, règles deny et managed settings sont des exigences toujours appliquées. Dans la plupart des cas, vous voulez que l’agent tranche — face à du vrai code, le modèle juge souvent mieux qu’une règle écrite à l’avance si une consigne s’applique. Réservez l’enforcement aux exigences dures du type « ne jamais éditer le client généré » ou « toujours lancer le script d’en-tête de licence ». Les nouvelles sessions terminal et VS Code démarrent d’ailleurs en mode auto, avec un classifieur qui filtre les comportements dangereux (déployer en prod, force-push par-dessus le travail de quelqu’un).
Le conseil a deux faces. Si vous insistez sur une ligne du CLAUDE.md et que l’agent continue de la rater, elle doit devenir un hook. Si un hook exprime une préférence au lieu d’une exigence, supprimez-le et laissez l’agent décider. Comme une équipe qui abandonne un process devenu inutile. Ça vaut aussi à chaque changement de modèle : le guide tient une liste des habitudes à arrêter — instructions en MAJUSCULES, « think harder » (l’effort est désormais un réglage), « don’t be lazy ». Avec les modèles actuels, elles mènent à du sur-enforcement et du surtravail. Avec les agents, le sur-process est le nouveau micro-management.
Planifiez avant qu’il ne construise
Bonne pratique : fixer un plan approuvé avant que l’agent ne code, chercher les hypothèses sous-jacentes, et découper en tâches parallèles sans recouvrement.
Anti-pattern : laisser plusieurs agents attaquer des tâches qui se chevauchent en même temps — puis passer l’après-midi à résoudre des conflits de merge et des décisions dupliquées.
Le bon flux : entrer en plan mode, itérer sur le plan jusqu’à ce qu’il soit bon, puis déléguer le code. Avec un bon plan, le modèle construit souvent d’une seule passe. Pour les grosses tâches, une deuxième session relit le plan comme un staff engineer — c’est la design review, l’endroit le moins cher pour détecter un mauvais tournant. En relisant le plan, cherchez les hypothèses implicites (en 1:1, ce serait : « Sur quoi es-tu incertain ? »).
La décomposition aussi est en train de passer aux agents. /batch dans Claude Code prend un gros changement mécanique, crée de 5 à 30 tâches, affiche le plan, les exécute dans des worktrees séparés (des checkouts distincts du dépôt) et ouvre une PR pour chacune. Vous n’avez plus besoin de découper le travail — juste de vérifier que les tranches ne se recouvrent pas et que les interfaces partagées partent en premier. Sans ça, vous obtenez un faux parallélisme : cinq agents sur des tâches qui se chevauchent ne produisent pas cinq fois plus d’output, ils produisent un conflit de merge à cinq auteurs.
Corrigez tôt, repartez vite à zéro
Bonne pratique : surveiller la première minute et piloter l’agent. Dès qu’il patine, corriger. Si vous avez déjà essayé de le corriger deux fois sans succès, repartir d’une session neuve avec un meilleur prompt.
Anti-pattern : ajouter une troisième ou quatrième tentative de correction au lieu de corriger la demande.
Un manager expérimenté sait que si une personne capable échoue plusieurs fois de suite, le problème est probablement en amont — instructions, contexte, périmètre. Version agent, c’est explicite : dès que l’agent dérape, appuyez sur Échap. Après deux tentatives de correction ratées — effacez la session et réécrivez un meilleur prompt en intégrant ce que vous avez appris. Une troisième tentative de correction n’est pour l’essentiel qu’information supplémentaire que le modèle doit relire et re-traiter, échecs compris.
Le rollback à bas coût change aussi la donne. /rewind ramène le code et la conversation à un point antérieur — ce qui rend sans risque d’essayer d’abord une approche ambitieuse. Les bons managers font pareil : si revenir sur une erreur est peu coûteux, laissez essayer l’approche ambitieuse. Faites ensuite le rétro, et si c’est pertinent, généralisez le correctif dans CLAUDE.md.
Déléguez la tâche, jamais le jugement
Bonne pratique : l’agent fait le travail, vous décidez de l’important — appels produit, frontières de sécurité, ce qui est livré. Lisez chaque diff comme si vous deviez être pager pour lui.
Anti-pattern : approuver de gros diffs parce que les tests sont verts et que les noms sont raisonnables. Ce n’est pas de la code review, c’est de la code ratification.
Aucun manager ne peut dire « c’est mon report qui a livré ça, pas moi. » Même chose pour chaque agent que vous lancez. Osmani lui-même est tombé dans le piège : il a demandé à un agent d’étudier les lacunes face aux concurrents et d’ouvrir des PR locales pour les combler. Il a lu la recherche, survolé le code, et a failli pousser des changements qui ajoutaient de la complexité pour les utilisateurs contre un gain minuscule. Il avait délégué le travail — et a failli déléguer la décision.
Le partage de tâches coule de là : le style, le linting, les relances de review, les bugs typiques et les tests unitaires peuvent aller à l’agent ; les frontières de sécurité, la conformité et les décisions produit restent humains. La coordination aussi : un agent peut suivre les handoffs, mais arbitrer entre des demandes concurrentes et obtenir l’engagement réel des gens reste un métier d’humain.
Il n’est pas nécessaire d’être dans la boucle interne de chaque changement. Ce que vous devez posséder, ce sont les boucles externes : quelles sont les contraintes, quelle part de l’output vous lisez réellement, quelles preuves vous conservez, ce qu’un humain doit signer. Et gardez les changements petits : l’unité de review est l’unité de compréhension.
Concevez des exécutions qui n’ont pas besoin de vous
Bonne pratique : avant de déployer une tâche autonome, définir le done, l’auto-vérification, les frontières, les garde-fous et l’approbation humaine.
Anti-pattern : lancer un long process au coucher, sans définition du terminé ni point d’arrêt — et se réveiller au matin pour découvrir que le modèle a travaillé toute la nuit sur une prémisse fausse.
Les managers n+1 ne gèrent pas le travail des ingénieurs individuels : ils gèrent les objectifs, les garde-fous, les checkpoints et les leads. Les agents suivent la même trajectoire. Ils délèguent déjà à des sub-agents, peuvent tourner de façon autonome sur des horaires, après des échecs CI ou à l’ouverture de nouvelles PR. La frontière, ce sont les systèmes auto-gouvernés qui démarrent seuls, se vérifient eux-mêmes et ne réclament un humain que pour les décisions.
Le rôle glisse du contrôle de la session vers le design de vos boucles. Les cinq questions à se poser avant une exécution non supervisée sont les mêmes que celles d’un bon manager donnant un projet à un senior avant de partir en vacances :
- Sait-il à quoi ressemble le terminé ? (Condition d’objectif, fichier spec, ou un test en échec qu’il doit faire passer au vert.)
- A-t-il un mécanisme d’auto-vérification ? (Suite de tests, hook Stop, ou étape de review.)
- Quelles sont ses frontières ? (Permissions, sandbox, worktree, ou l’unique branche vers laquelle il peut pousser.)
- Quels sont ses garde-fous ? (Limite de tours ou de dépense.)
- Où produit-il son output, et qui l’approuve ? (Une PR ou un summary, plus une approbation humaine de toute action irréversible.)
Le guide ajoute deux habitudes que les managers reconnaîtront : le pilot, faire tourner le batch sur trois fichiers, itérer le prompt, puis lancer le reste ; et observer les premières exécutions de tout ce qui est nouveau avant de le laisser tourner seul — une période d’essai, en somme.
Faites évoluer la vérification, pas l’attention
Bonne pratique : n’augmenter le nombre d’agents qu’aussi vite que les checks, objectifs et reviewers à frais nouveaux peuvent prendre en charge la surveillance — et mesurer la qualité en plus du débit.
Anti-pattern : ouvrir plus de sessions que vous ne pouvez en relire correctement, et mesurer le succès au volume de code écrit par l’IA.
Un manager apprend vite son périmètre de contrôle. Passé un certain nombre de reports directs, chacun reçoit moins du manager, et la qualité baisse. Même chose pour les agents. C’est ce qu’Addy Osmani appelle la taxe d’orchestration : après les premiers agents, chaque agent supplémentaire réclame plus d’attention que le précédent. La plupart des jours il fait tourner quatre ou cinq agents en arrière-plan et quelques sessions locales — et certains jours, c’est trop.
Gérer beaucoup de sessions, ce n’est pas être hyper-focalisé : c’est déléguer l’essentiel de la surveillance à l’auto-évaluation, aux objectifs et aux reviewers en contexte neuf, pour réserver l’attention aux décisions. Des notifications plutôt que du polling, une vue centralisée des jobs de fond. On ne met pas à l’échelle en surveillant plus, mais en ayant moins besoin de surveiller. Et mesurer le système, pas l’activité : cycle time des PR, temps de ramp-up des nouveaux, fréquence des reverts et du rework. Mesurer le pourcentage de code écrit par l’IA n’est pas un bon objectif, puisque la cible, c’est la qualité et la fiabilité. Règle de Grove appliquée aux métriques avec contremesure : si vous mesurez le nombre de PR mergées, mesurez aussi les reverts et le rework.
Décidez de ne pas construire
Bonne pratique : demander a priori qui en a besoin, comment on saura que ça a marché, et ce qui ferait qu’on s’arrête. Limiter le WIP.
Anti-pattern : jeter chaque idée plausible dans une PR — après tout, c’est peu coûteux. Vous vous retrouvez avec un tiroir à bricolages que l’équipe doit relire, sécuriser et maintenir.
Le mot le plus important d’un manager est souvent « non ». Avec les agents, c’est plus dur de le dire : démarrer est presque gratuit, et n’importe quelle idée plausible peut devenir une PR avant le déjeuner. Mais vous aurez alors une pile de PRs que l’équipe devra relire, sécuriser, supporter et maintenir. La review et la validation sont les ressources rares, désormais.
Les vieilles questions de management comptent donc plus qu’avant. Qui l’a demandé ? Comment mesure-t-on le succès ? Comment sait-on quand s’arrêter ? Quand construire n’a presque aucun coût, la question n’est plus « peut-on ? » mais « devrions-nous ? ».
Là où l’analogie casse
Bonne pratique : suivre les bonnes pratiques du management, mais intégrer les différences du modèle agent — rework quasi gratuit, tendance à acquiescer, forces qui changent à chaque modèle.
Anti-pattern : croire qu’un agent est juste un développeur junior, ou que vous savez manager cinq personnes parce que vous faites tourner cinq agents.
L’analogie est utile mais imparfaite, et les meilleurs praticiens savent précisément où :
- Manager des humains est plus dur, et les compétences ne se transfèrent pas en sens inverse. Vous n’êtes pas prêt à manager cinq personnes parce que vous avez lancé cinq agents. Rien n’équivaut à la motivation, au conflit, au développement de carrière, ou à des mois de construction de confiance.
- Le rework est presque gratuit. Vous pouvez demander à un agent ce que vous ne demanderiez jamais à une personne. Un débat technique qui se ferait au whiteboard : l’agent peut construire deux ou trois options, et vous les comparez.
- Les agents n’ont pas d’expérience, seulement un carnet. La mémoire auto ne note que sur une machine ; ça ne se transfère pas aux sessions de vos collègues. Ce n’est pas la sagesse accumulée sur une carrière — les leçons, il faut les écrire pour toute l’équipe.
- Les agents sont enthousiastes et sûrs d’eux. Demandez à un bon ingénieur de faire une erreur, il pousse en retour. Un agent, lui, obéit volontiers — et vous risquez de lui faire trop confiance. Dans une recherche de Wharton sur la reddition cognitive, les participants ont accepté des réponses IA fausses la plupart du temps, en gagnant en confiance. Un contrepied : demander à l’agent d’argumenter contre sa propre réponse.
- Vous n’avez qu’un archétype d’agent, et il change tous les deux ou trois mois. Une équipe humaine a des compétences diverses. Tous vos agents ont les mêmes forces et faiblesses — et elles changent à chaque sortie de modèle.
- Il faut toujours former vos juniors. Quand les agents pompent le travail d’initiation, les juniors ont besoin d’apprendre les fondamentaux du métier — ces répétitions, il faut les créer intentionnellement, en manager.
- L’équipe humaine compte toujours. On peut passer une journée à manager des agents sans réaliser qu’on a évincé le temps nécessaire à une équipe soudée. Ne le faites pas.
Vous n’avez pas besoin du titre
Bonne pratique : concentrer l’effort sur faire advenir du bon logiciel — poser le contexte, définir le terminé, bien relire.
Anti-pattern : s’auto-évaluer en lignes de code tout en faisant tourner des agents mal briefés et non vérifiés.
Les bons staff engineers ont toujours été ça : ils écrivent le design doc, posent le contexte, relisent en profondeur, rendent les gens autour meilleurs. Les agents donnent à tous les ingénieurs ce levier dès le premier jour. Vous vous offrez un cours accéléré de management : le feedback arrive en minutes, pas en trimestres, et vous pouvez revenir sur vos erreurs. Le métier devient moins « le code qu’on écrit » et plus « être la raison pour laquelle du bon code est écrit ».
Personne n’est né grand manager (ni grand ingénieur). Les compétences se bâtissent comme toujours, par la pratique — mais avec les agents, la pratique est bon marché. Les idées à appliquer dès aujourd’hui :
- Chaque tâche mérite un check qu’elle peut lancer. Demandez la preuve.
- Dites à l’agent ce qu’il ne peut pas voir, et omettez ce qu’il peut.
- Parlez du plan avant d’écrire le code.
- Corrigé deux fois ? Loggez-le dans
CLAUDE.md. Un workflow répété ? Transformez-le en skill. - Deux corrections ratées ? Repartez de zéro et reformulez le prompt.
- Relisez le diff comme si vous risquiez d’être pager pour lui.
Badge Pangram clôturant l’article original : le texte y est classé « écrit par un humain » à 90 % (IA 10 %) — clin d’œil d’un auteur dont le rôle, chez Anthropic, consiste pourtant à écrire sur l’IA.
Vous n’êtes pas obligé de vouloir devenir manager. Mais les ingénieurs qui excellent avec les agents auront appris à manager en chemin.
Note de veille : Addy Osmani (ex-lead Chrome, aujourd’hui Claude Code chez Anthropic) a déjà placé son billet cognitive surrender comme le fil rouge du risque de délégation passive — ce long-form en est le pendant opérationnel côté managers.