Harness Engineering : le guide complet pour des agents IA qui ne s'effondrent pas
Harness Engineering : le guide complet pour des agents IA qui ne s’effondrent pas
Source: F5Adon (@F5Adon) — post du 28 octobre 2026 · 237 585 vues, 3 585 likes, 629 reposts
Guide original : LunarResearcher (@LunarResearcher) — Harness Engineering: The Complete Guide to Building AI Agents That Don’t Fall Apart
« Andrej Karpathy a passé 8 ans chez OpenAI et Tesla. La semaine dernière, il a condensé tout ce qu’il a appris dans une conférence gratuite de 2 heures : Agents → Harness → Loops → Graphs. Certains bootcamps facturent 15 000 $ pour moins que ça. »
C’est le pitch du post. Il est efficace, il est viral, et il mérite d’être regardé de près : la vidéo jointe dure 2 h 03, et le vrai contenu est dans le guide qui l’accompagne — un texte de LunarResearcher sur le harness engineering, la couche que presque tout le monde oublie de construire.
Une réserve honnête avant de commencer : la vignette de la vidéo montre un enregistrement d’écran (une fenêtre ChatGPT, un intervenant en incrustation), pas une scène de conférence. Le post l’attribue à Karpathy, X ne permet pas de le vérifier, et peu importe au fond : ce qui reste quand la vidéo est oubliée, c’est la méthode ci-dessous.
Car le diagnostic de départ est juste.
Vos agents n’échouent pas là où vous croyez
Quand un agent rate sa tâche, réflexe numéro un : réécrire le prompt. Puis rajouter des instructions. Puis changer de modèle, ajouter des outils, agrandir la fenêtre de contexte, et espérer que la prochaine exécution se comportera autrement.
Mais beaucoup d’échecs d’agents ne sont pas des échecs de raisonnement. Ce sont des échecs d’environnement :
- l’agent ne savait pas quels fichiers comptaient ;
- il a utilisé le bon outil au mauvais endroit ;
- il a perdu les décisions prises à la session précédente ;
- il a annoncé un succès sans lancer les vérifications ;
- il a répété une action après un échec partiel ;
- il avait l’autorisation de faire quelque chose qui aurait dû exiger une validation.
Le modèle n’était pas forcément le problème. Le système autour du modèle était incomplet.
Ce système, c’est le harness. Et le concevoir devient une discipline d’ingénierie à part entière : l’art de construire l’environnement qui transforme l’intelligence du modèle en travail fiable.
Un prompt change un essai. Un harness change tous les essais.
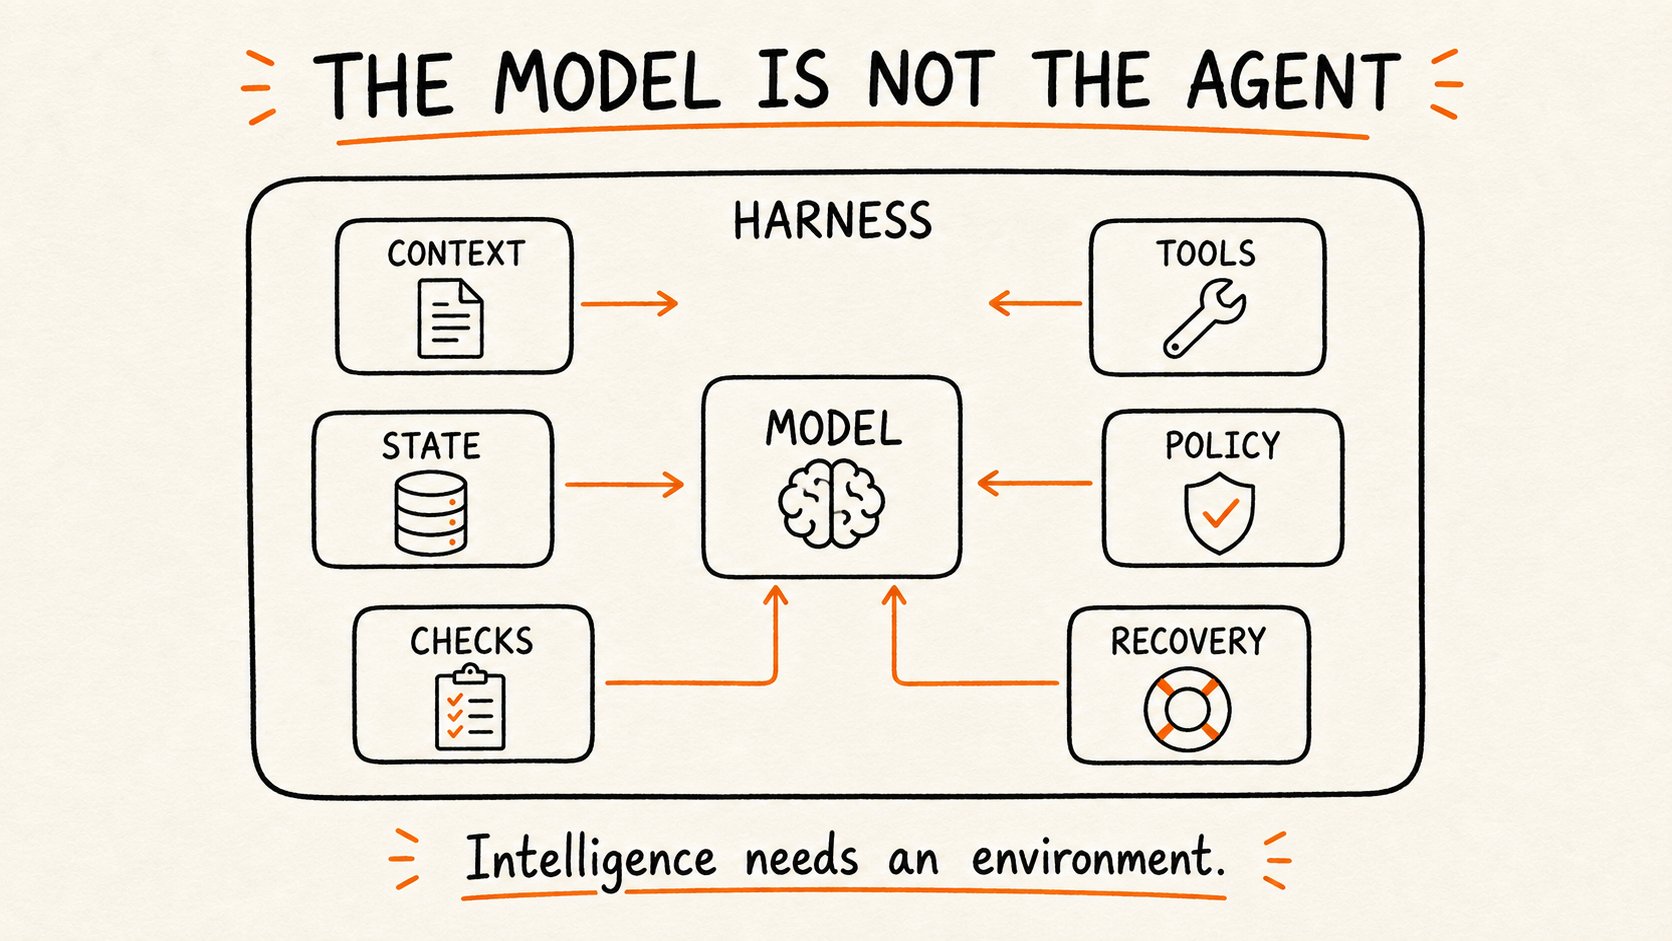
1. Le modèle n’est pas l’agent
Un modèle sait raisonner, générer, comparer, choisir. Un agent, lui, doit aussi interagir avec un environnement réel. Il doit :
- comprendre la tâche ;
- trouver le contexte pertinent ;
- sélectionner et utiliser des outils ;
- préserver son état ;
- respecter des permissions ;
- inspecter le résultat ;
- récupérer après un échec ;
- prouver que le travail est terminé.
Le modèle est le moteur de raisonnement à l’intérieur de ce système. Le harness est tout ce qui rend ce raisonnement opérationnel.
requête utilisateur
     |
     v
+-----------------------------+
|          HARNESS            |
| contrat | contexte | politique |
| outils  | état     | contrôles |
| traces  | récupération          |
+-----------------------------+
     |
     v
   modèle
     |
     v
environnement réel
Un modèle puissant dans un harness faible reste un agent faible. Il produit des réponses impressionnantes isolément, puis devient incohérent dès que la tâche s’allonge, que l’environnement change ou qu’un échec partiel survient.
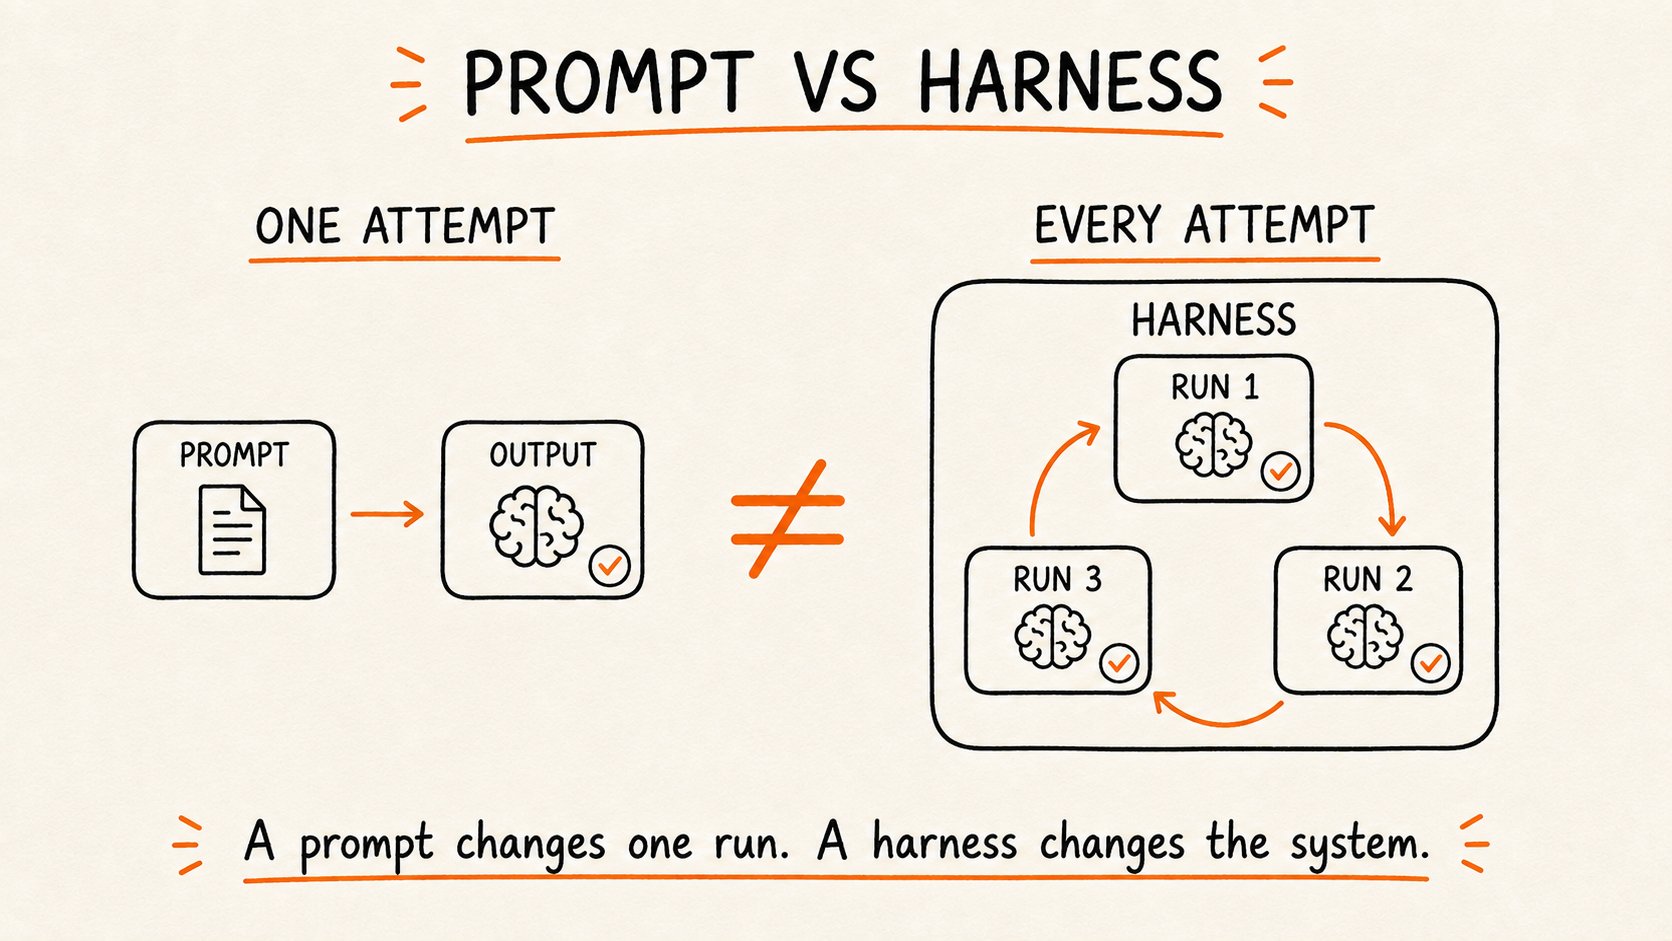
L’objectif n’est pas de supprimer l’incertitude du modèle. Il est de la contenir dans un système capable d’observer, de vérifier et de récupérer.
2. Commencer par un contrat de tâche
La plupart des tâches d’agents commencent par une intention floue : « améliore l’onboarding ». C’est suffisant pour une conversation. Pas pour une exécution autonome.
Avant que l’agent agisse, le harness doit convertir la demande en contrat. Un contrat utile répond à cinq questions :
- Quel résultat doit exister ?
- Qu’est-ce qui est dans le périmètre ?
- Qu’est-ce qui ne doit pas changer ?
- Quelle preuve démontre que c’est terminé ?
- Quelles actions exigent une validation humaine ?
objective: réduire l'abandon à l'onboarding

scope:
  - parcours d'inscription
  - analytics d'onboarding

constraints:
  - ne pas modifier l'authentification
  - préserver le comportement mobile existant

acceptance:
  - les tests passent
  - l'événement analytics est émis
  - les captures couvrent desktop et mobile

approval_required:
  - déploiement en production
  - migration de base de données
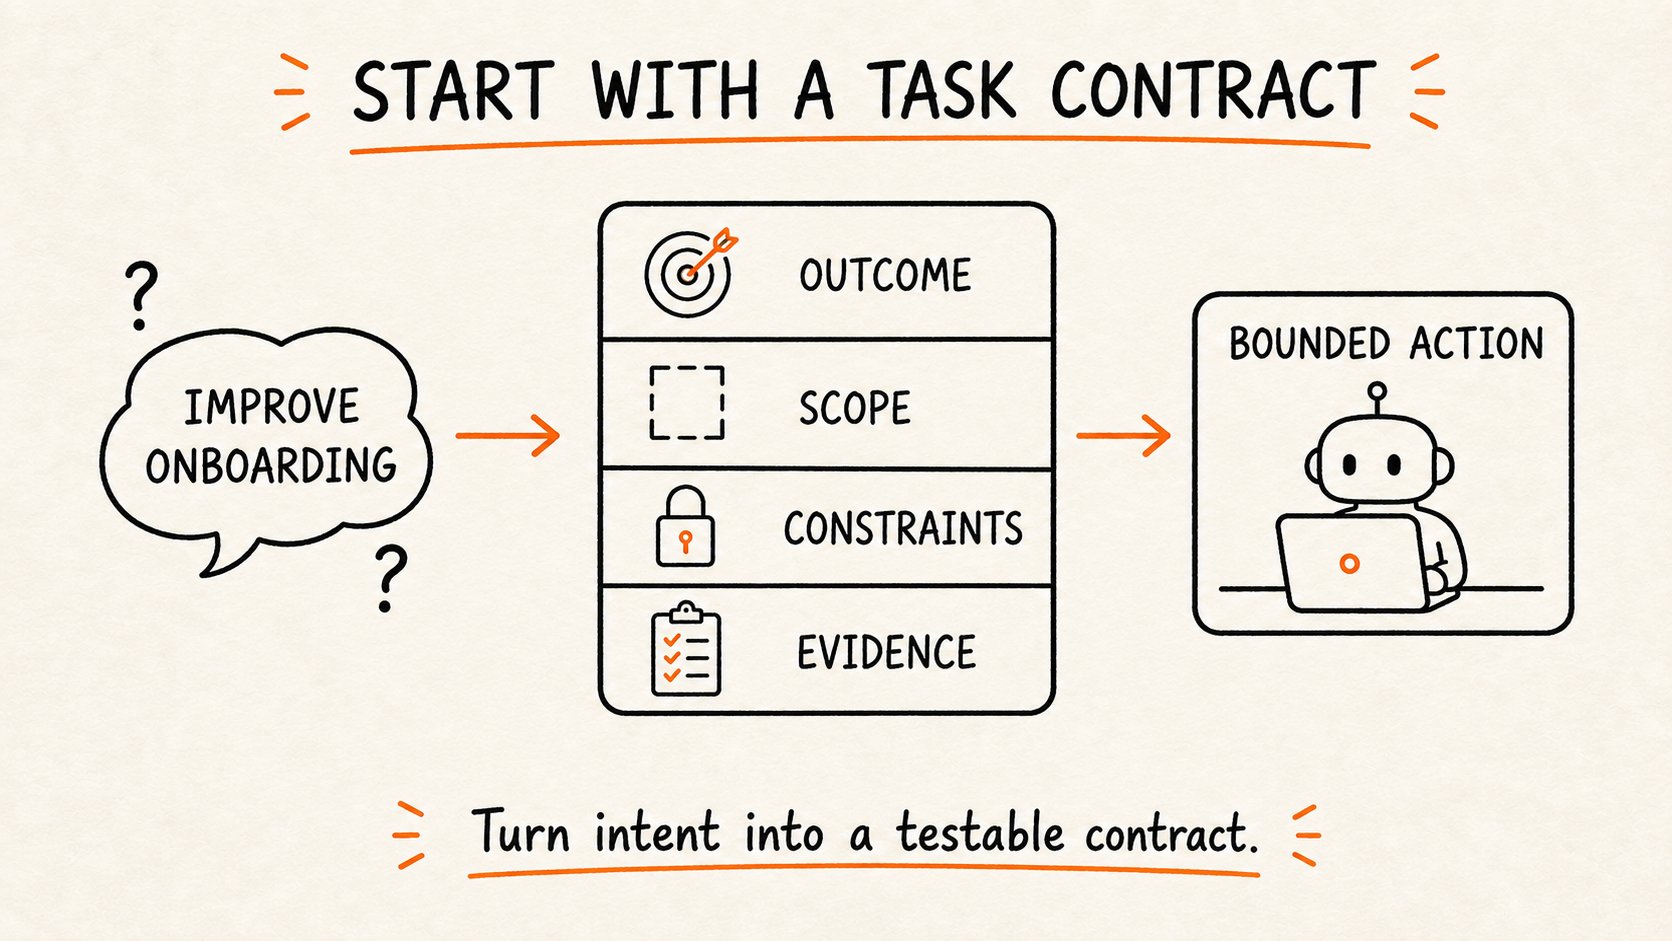
La question de l’agent change alors. Elle n’est plus « que faire ensuite ? » mais « quelle action rapproche l’environnement du résultat contractuel ? »
Sans contrat, l’agent optimise pour une activité plausible. Avec un contrat, il peut optimiser pour une complétion vérifiée.
3. Donner une carte, pas un manuel
Déverser tout le dépôt, toute la documentation et tout l’historique de conversation dans le contexte, ce n’est pas du context engineering. C’est une inondation de contexte.
Le harness doit fournir d’abord une petite carte, puis laisser l’agent chercher les détails quand ils deviennent pertinents.
CARTE DU PROJET

règles produit      -> docs/product/
architecture        -> docs/architecture.md
frontend            -> apps/web/
backend             -> services/api/
tests               -> tests/
commandes           -> docs/commands.md
règles de release   -> docs/release.md
C’est de la divulgation progressive :
tâche
  -> carte du projet
      -> sous-système pertinent
          -> fichiers exacts
              -> instructions locales
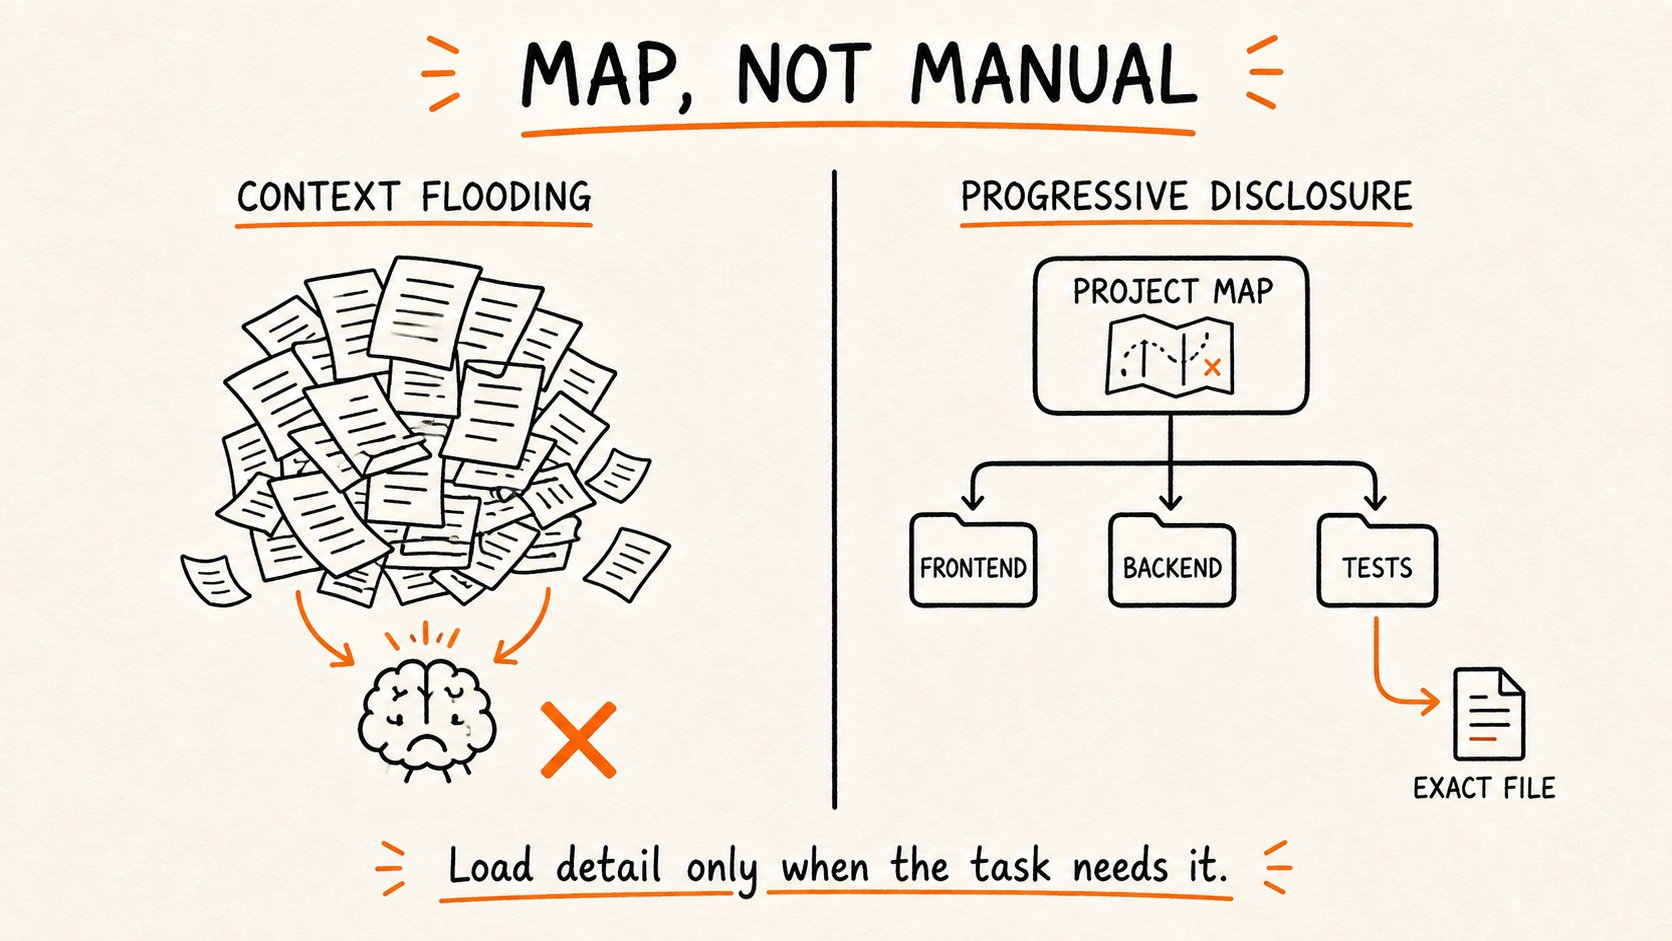
Le contexte doit s’étendre parce que la tâche l’exige, pas parce que l’information existe. Un bon compilateur de contexte décide :
- ce qui est toujours nécessaire ;
- ce qui peut être récupéré plus tard ;
- ce qui est devenu obsolète ;
- ce qui peut être résumé ;
- ce qui doit rester mot pour mot.
L’objectif n’est pas le contexte maximal. C’est le signal maximal par token.
4. Construire une passerelle d’outils, pas un tas d’outils
Donner vingt outils à un agent ne le rend pas capable. Ça lui donne vingt façons de se tromper.
Chaque outil devrait avoir un contrat clair :
OUTIL : edit_file

entrées :
  path
  patch

préconditions :
  le chemin existe
  le chemin est dans l'espace de travail autorisé

preuve de succès :
  patch appliqué
  diff résultant retourné

comportement en cas d'échec :
  aucun écrasement partiel
  erreur structurée retournée

classe de risque :
  réversible
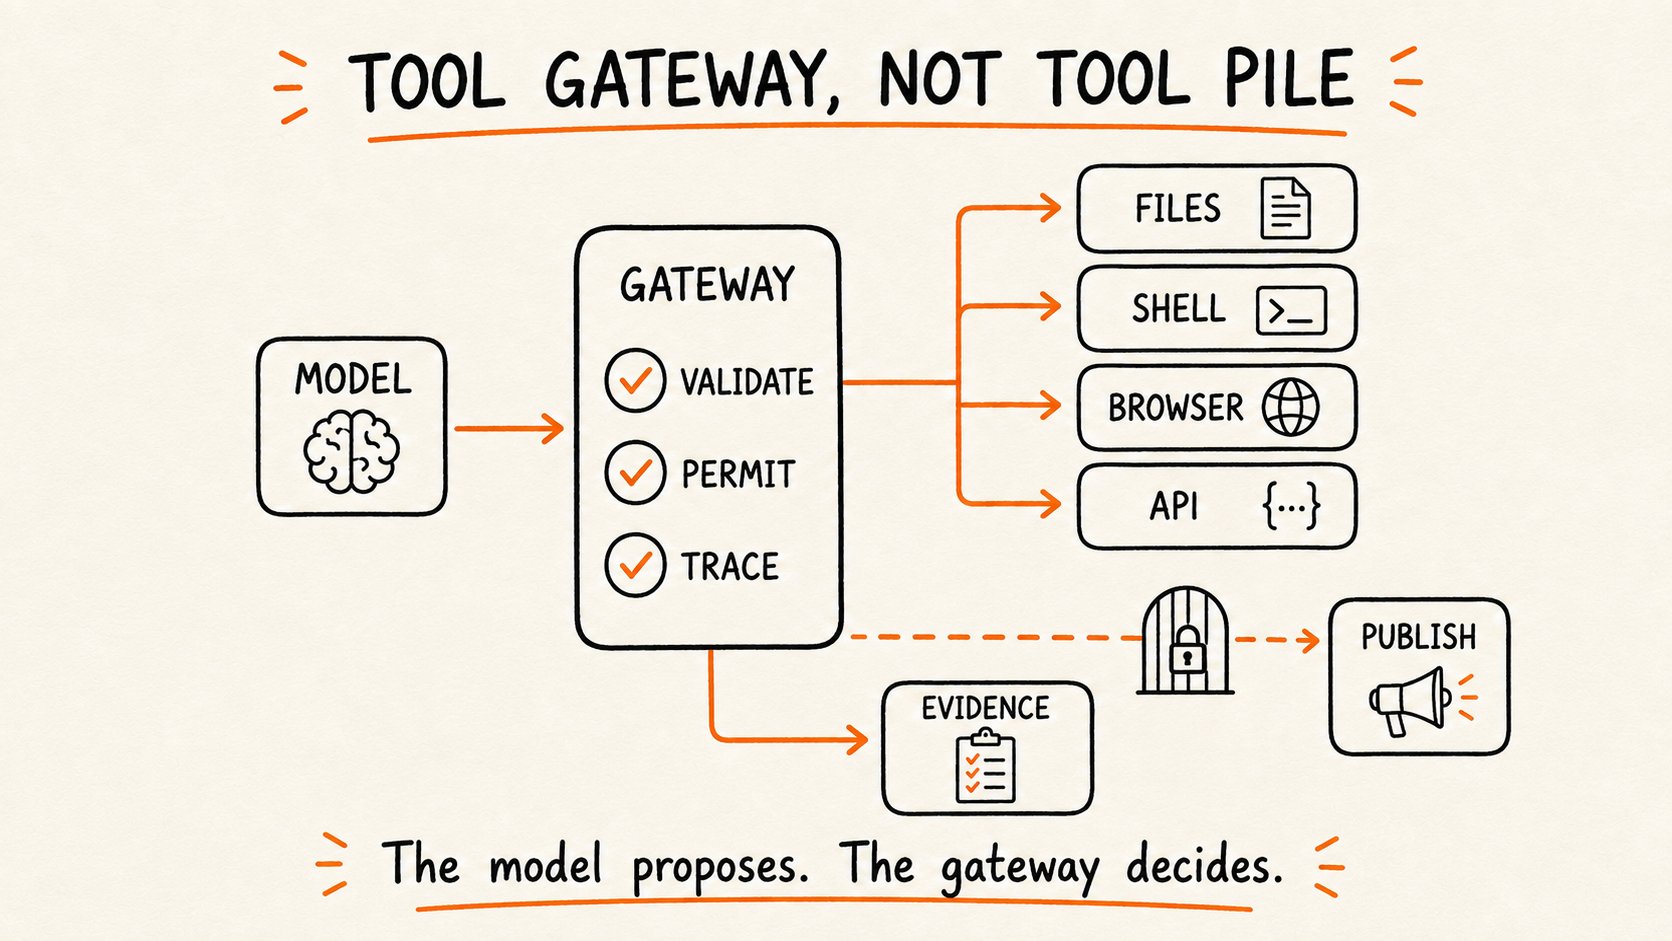
Le harness doit contrôler la façon dont les outils sont exposés et utilisés. Il peut :
- masquer les outils non pertinents ;
- valider les arguments ;
- restreindre les chemins et les domaines ;
- attacher des timeouts ;
- rendre les retries idempotents ;
- normaliser les sorties ;
- exiger une confirmation pour les actions risquées ;
- retourner des preuves, pas juste « succès ».
D’où une séparation essentielle :
le modèle décide de l'intention
la passerelle valide l'action
l'outil modifie l'environnement
le capteur observe le résultat
Le modèle peut proposer une action. La passerelle décide si cette action est suffisamment valide pour être exécutée.
5. Séparer le cerveau, les mains et l’histoire
Les agents fragiles mélangent tout dans une transcription qui grossit sans fin : raisonnement, appels d’outils, fichiers, décisions, erreurs et vieilles observations se disputent la même fenêtre de contexte.
Un système plus solide sépare trois responsabilités :
CERVEAU
planifie, raisonne, choisit

MAINS
exécutent les outils dans un environnement contrôlé

HISTOIRE
stocke les faits durables, les décisions et l'état d'exécution
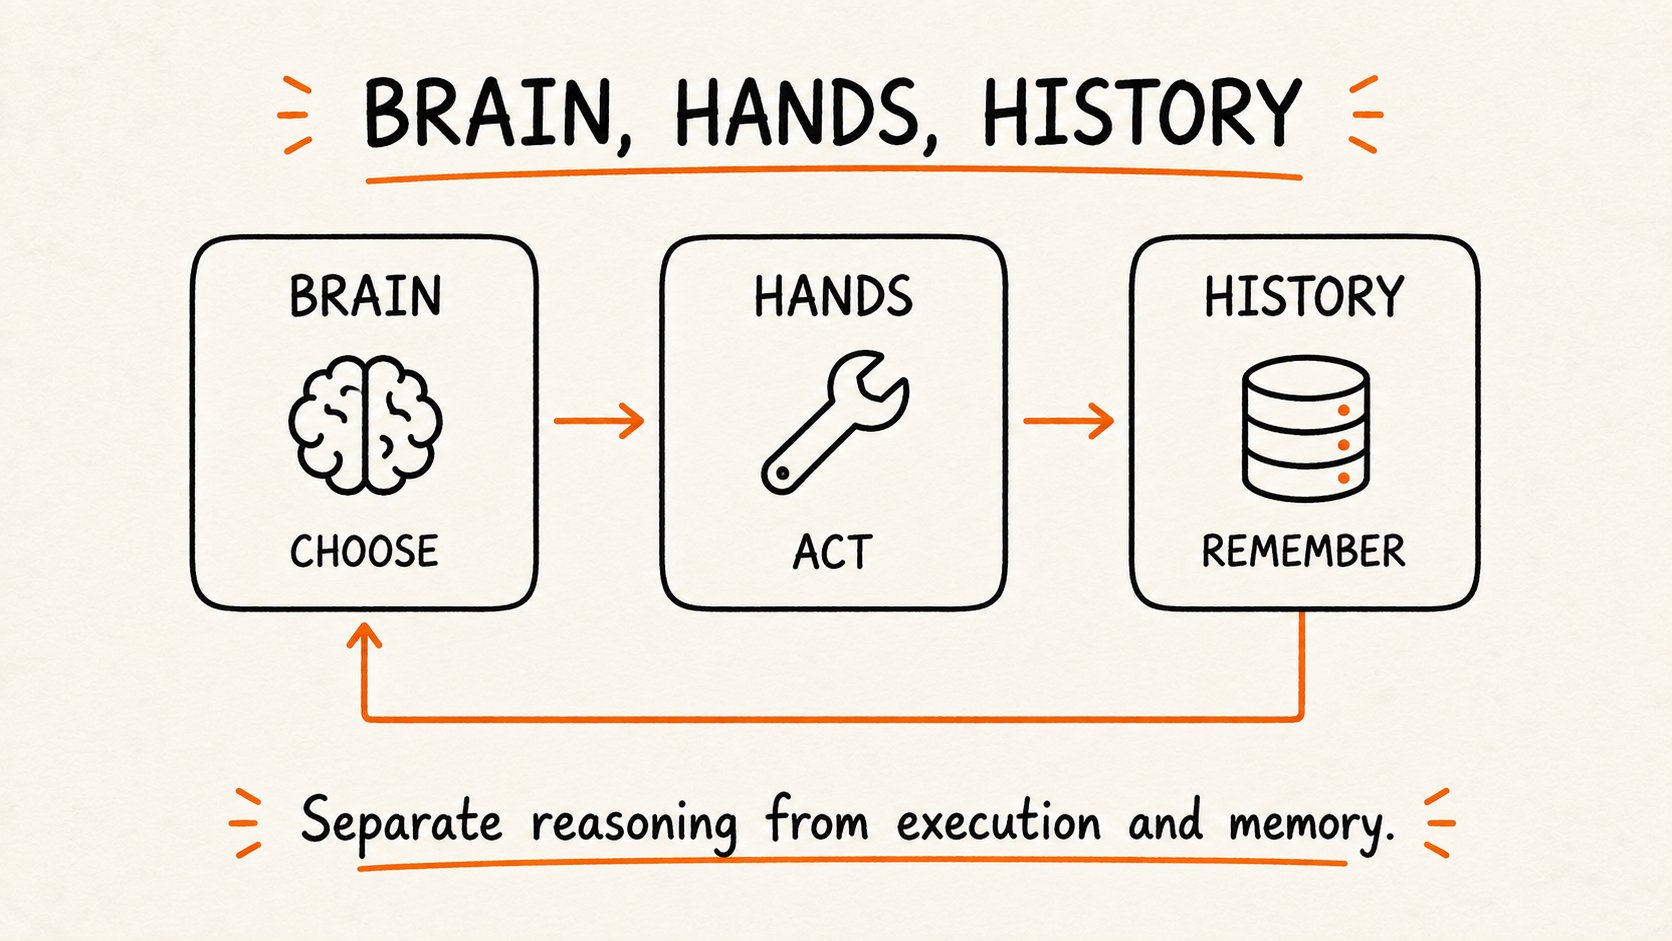
Le modèle n’a pas besoin de chaque événement brut dans son contexte actif. Il a besoin du bon état courant. Le sandbox n’a pas besoin de comprendre l’objectif global. Il a besoin d’exécuter une action bornée en sécurité. Le journal de session n’a pas besoin de raisonner. Il doit préserver ce qui s’est passé quand le contexte actuel disparaît.
Cette séparation rend les agents longs plus faciles à reprendre, à inspecter et à réparer. Elle permet aussi de remplacer une pièce sans reconstruire tout le système.
6. La mémoire doit devenir un état durable
L’historique de conversation n’est pas une mémoire fiable. C’est un flux d’événements. La mémoire utile doit être convertie en état explicite.
Préservez au minimum quatre catégories :
FAITS
informations stables découvertes sur l'environnement

DÉCISIONS
choix effectués et raison derrière chacun

PROGRESSION
travail terminé, en cours, bloqué, restant

LEÇONS
échecs qui doivent changer le comportement futur
Par exemple :
facts:
  - la validation du panier vit dans services/orders

decisions:
  - réutiliser le pipeline de validation existant
  - raison: évite une seconde source de vérité

progress:
  completed:
    - règle côté serveur ajoutée
  remaining:
    - mettre à jour le test d'intégration

lessons:
  - la commande de test locale exige TEST_DB_URL
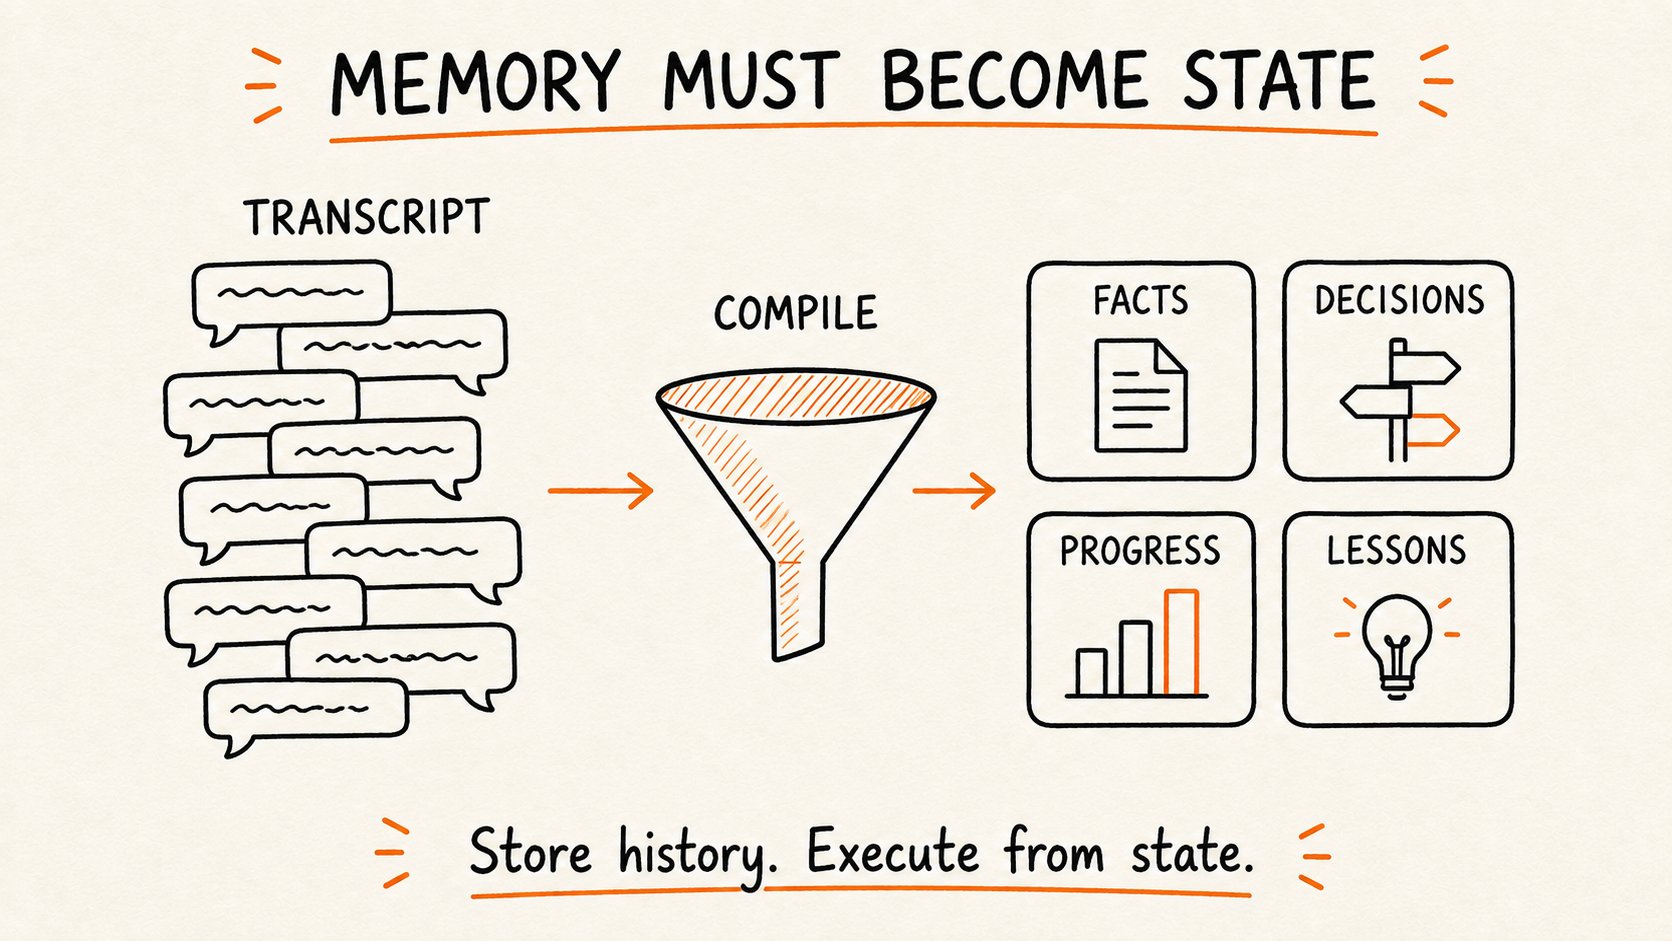
C’est infiniment plus utile que de rejouer cinquante pages de transcription en espérant que le modèle remarque la bonne ligne. Stockez l’historique brut pour l’audit. Compilez un état durable pour l’exécution.
7. La complétion exige des preuves
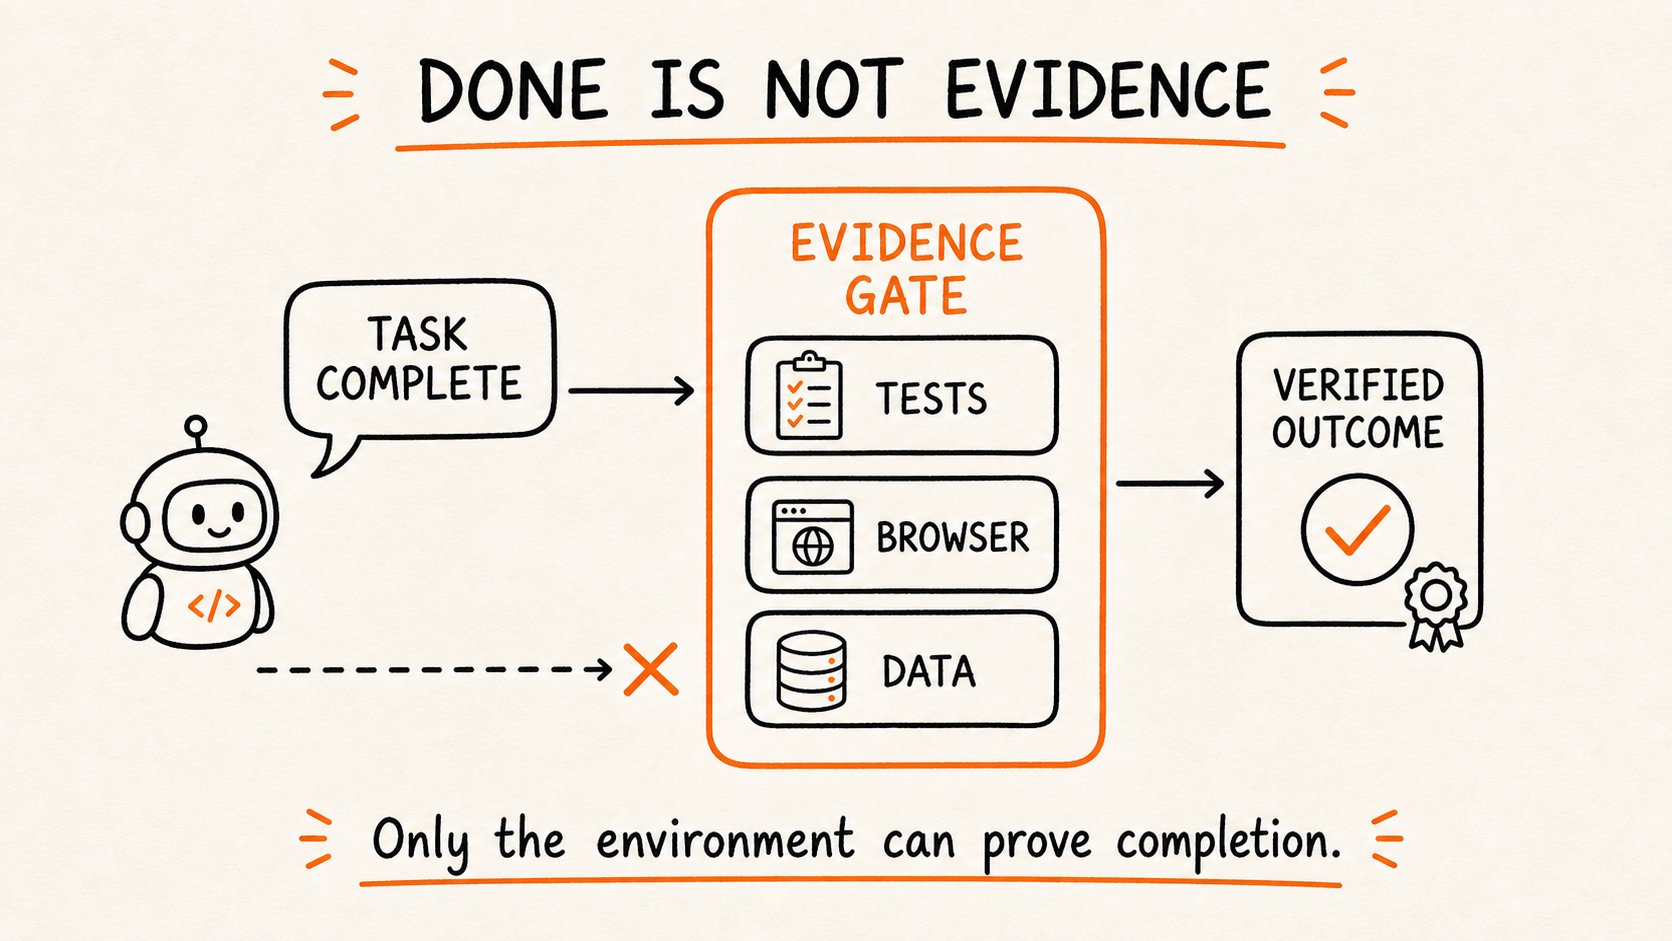
Quand un agent dit « terminé », ce n’est pas une preuve que la tâche est terminée. C’est une sortie de modèle de plus.
La complétion doit être décidée par des changements observables dans l’environnement.
affirmation                     preuve
----------------------------------------------------------
« le bug est corrigé »          le test qui échouait passe
« la page fonctionne »          le parcours navigateur est allé au bout
« la migration est sûre »       le dry run et le rollback passent
« le rapport est correct »      les valeurs correspondent à la source
« la tâche est terminée »       tous les critères d'acceptation passent
Le harness doit lancer les vérifications déterministes les moins chères d’abord :
syntaxe
  -> types
      -> tests ciblés
          -> tests d'intégration
              -> revue visuelle ou sémantique
                  -> validation humaine
N’utilisez pas un autre modèle là où un compilateur, un schéma, une somme de contrôle, une requête ou un test peut répondre. Les modèles pour l’ambiguïté. Le code pour la plomberie.
Un modèle peut proposer que la tâche soit terminée. Seul l’environnement peut le prouver.
8. La vérification doit attaquer le résultat
Le travailleur et l’évaluateur ne doivent pas partager le même objectif. Le travailleur essaie de produire la meilleure solution. L’évaluateur essaie de trouver la raison de la rejeter.
travailleur
  -> produit un candidat

vérificateur
  -> contrôle le contrat
  -> cherche les cas manquants
  -> teste les affirmations non étayées
  -> tente de casser le résultat

survit
  -> accepté

échoue
  -> retourne une preuve ciblée
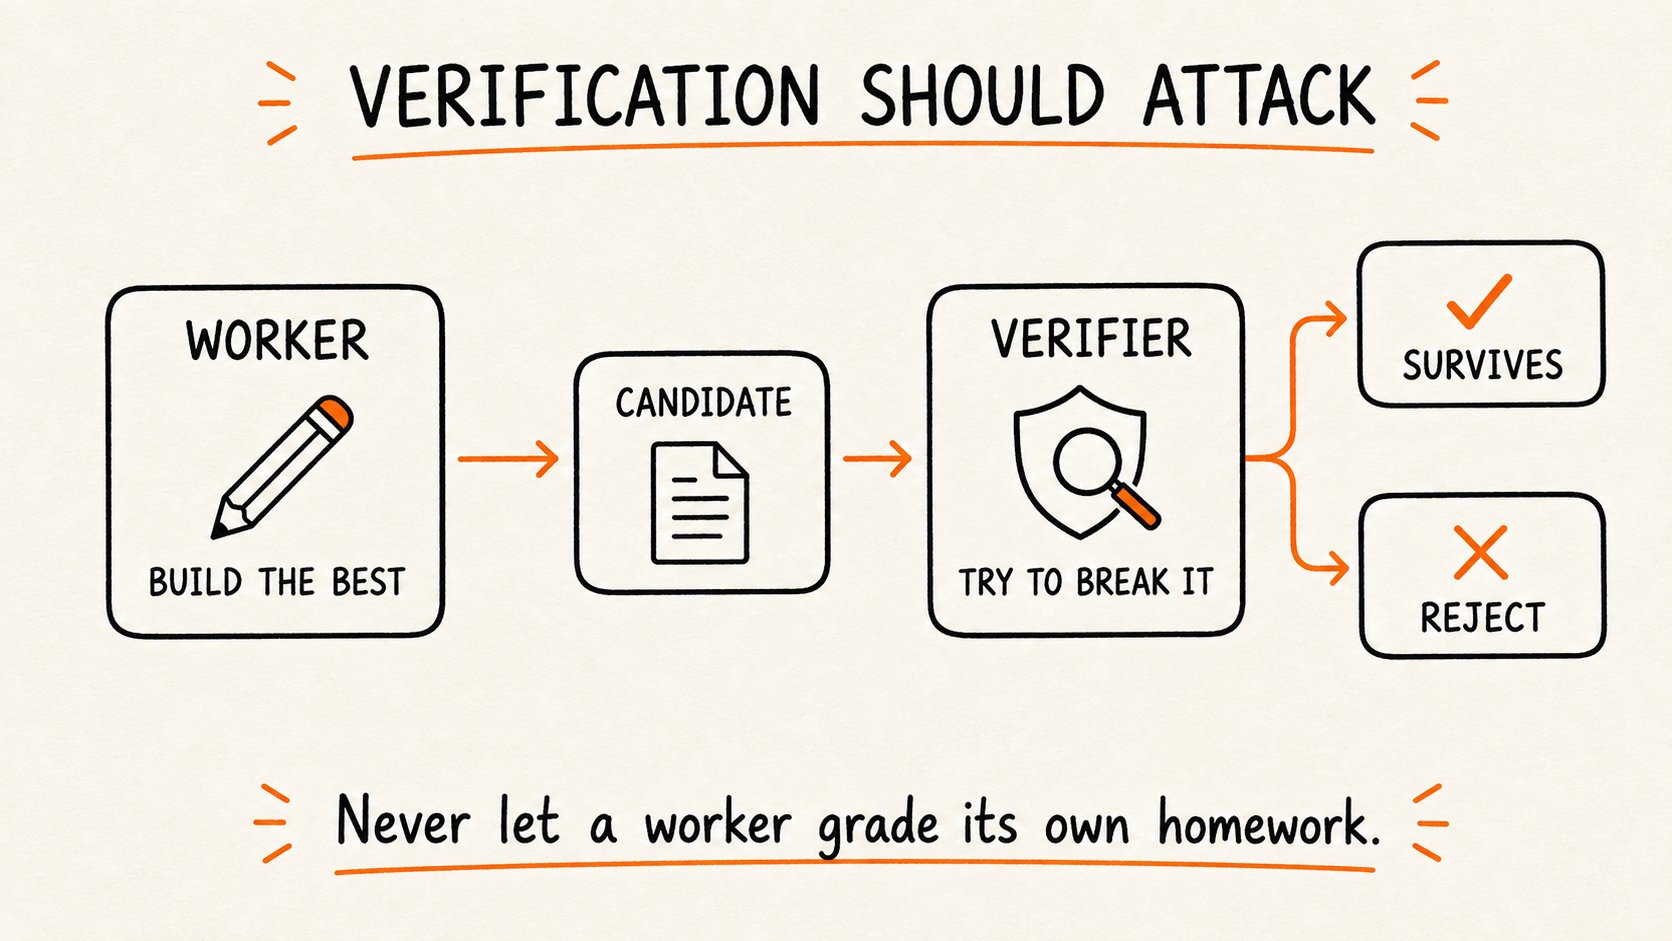
Cette asymétrie compte. Si vous demandez au même agent, dans le même contexte, de « revérifier son travail », il préserve souvent les hypothèses qui ont créé l’erreur.
Une étape de vérification utile doit avoir :
- une grille de rejet explicite ;
- accès à l’artefact produit ;
- accès au contrat d’acceptation ;
- des outils indépendants ou un contexte neuf si nécessaire ;
- le droit de rejeter sans réparer.
La vérification n’est pas un second avis. C’est une tentative de réfutation.
9. Le modèle propose, la politique autorise
Certaines règles ne devraient jamais dépendre de la mémoire du modèle :
ne jamais publier sans validation
ne jamais exposer un secret
ne jamais écrire hors de l'espace de travail
ne jamais dépasser le plafond de dépense
ne jamais marquer des tests comme passés s'ils n'ont pas tourné
Ce ne sont pas des suggestions de prompt. C’est de la politique. La conception la plus sûre garde la politique en dehors de la boucle de raisonnement.
RISQUE FAIBLE
lire des fichiers, chercher, inspecter
-> automatique

CHANGEMENT RÉVERSIBLE
éditer l'espace de travail, lancer les tests
-> automatique avec trace

EFFET EXTERNE
envoyer un message, déployer, acheter
-> validation explicite

IRRÉVERSIBLE OU SENSIBLE
supprimer des données, tourner des identifiants, publier globalement
-> barrière dure ou interdit
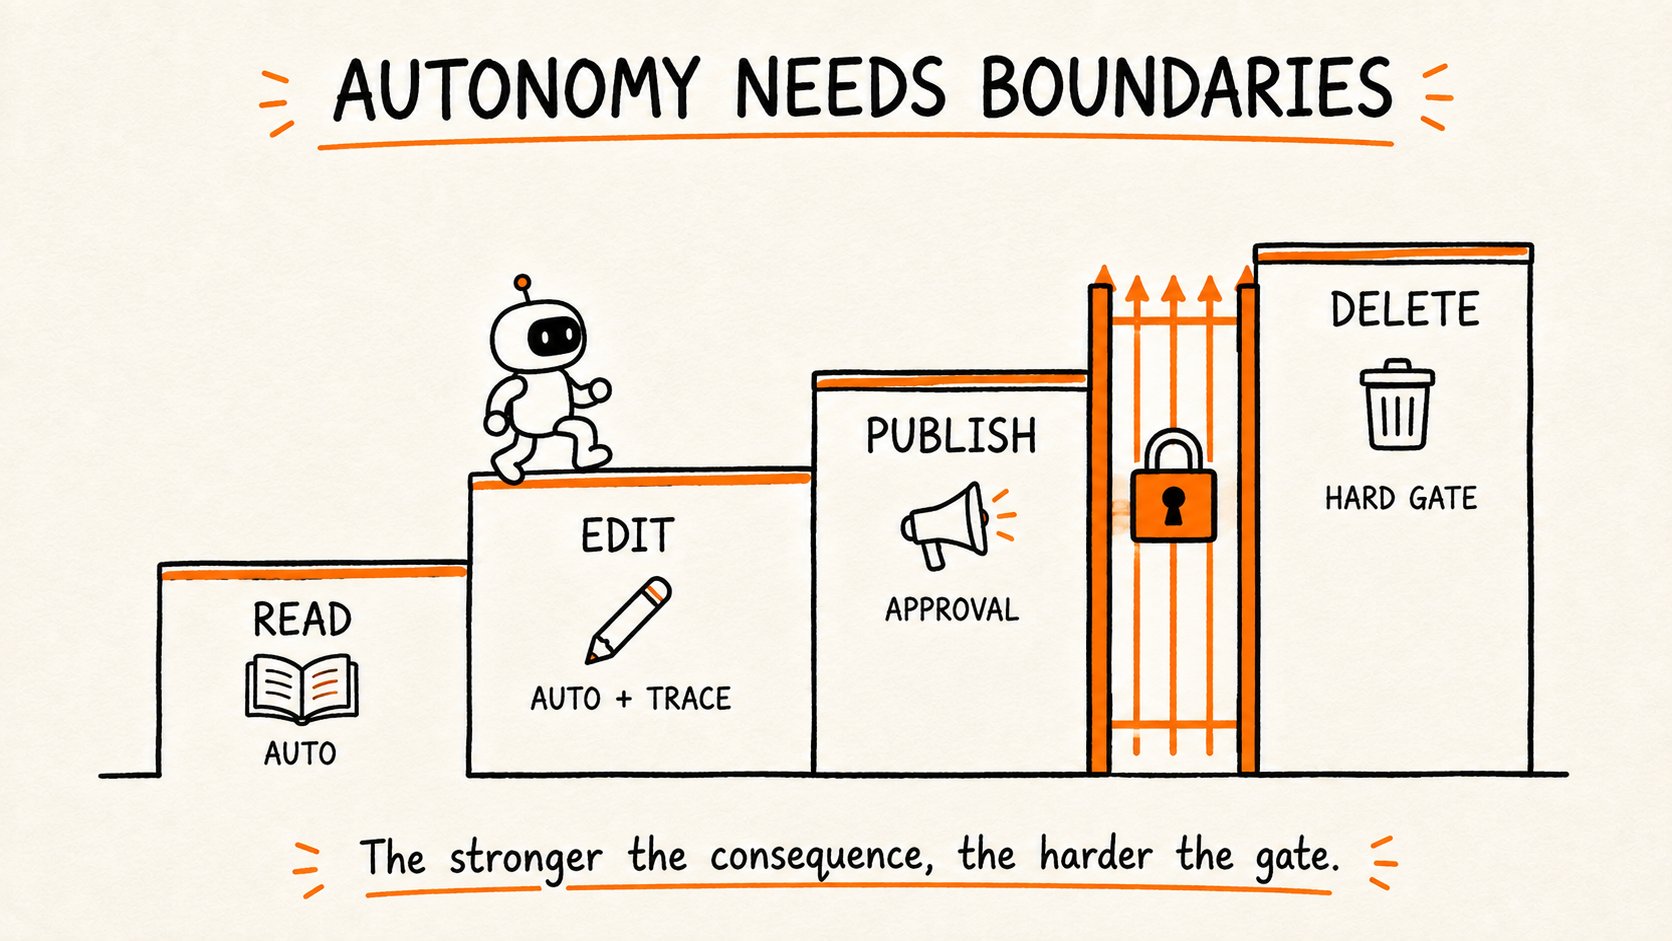
Plus la conséquence est forte, plus la barrière doit être dure. L’autonomie n’est pas l’absence de contrôle. C’est la capacité d’opérer librement à l’intérieur d’une frontière clairement appliquée.
10. La récupération doit viser la classe d’échec
La stratégie de récupération la plus répandue : « quelque chose a échoué, on réessaie ». Ce n’est pas de la récupération, c’est de la répétition.
Le harness doit classer l’échec avant de choisir l’action suivante :
timeout d'outil
-> retry avec backoff

arguments invalides
-> réparer l'appel d'outil

contexte manquant
-> récupérer la source précise

test échoué
-> inspecter le comportement qui échoue

permission refusée
-> demander une validation ou choisir un chemin sûr

exigences contradictoires
-> escalader vers un humain

échec répété à l'identique
-> arrêter la boucle
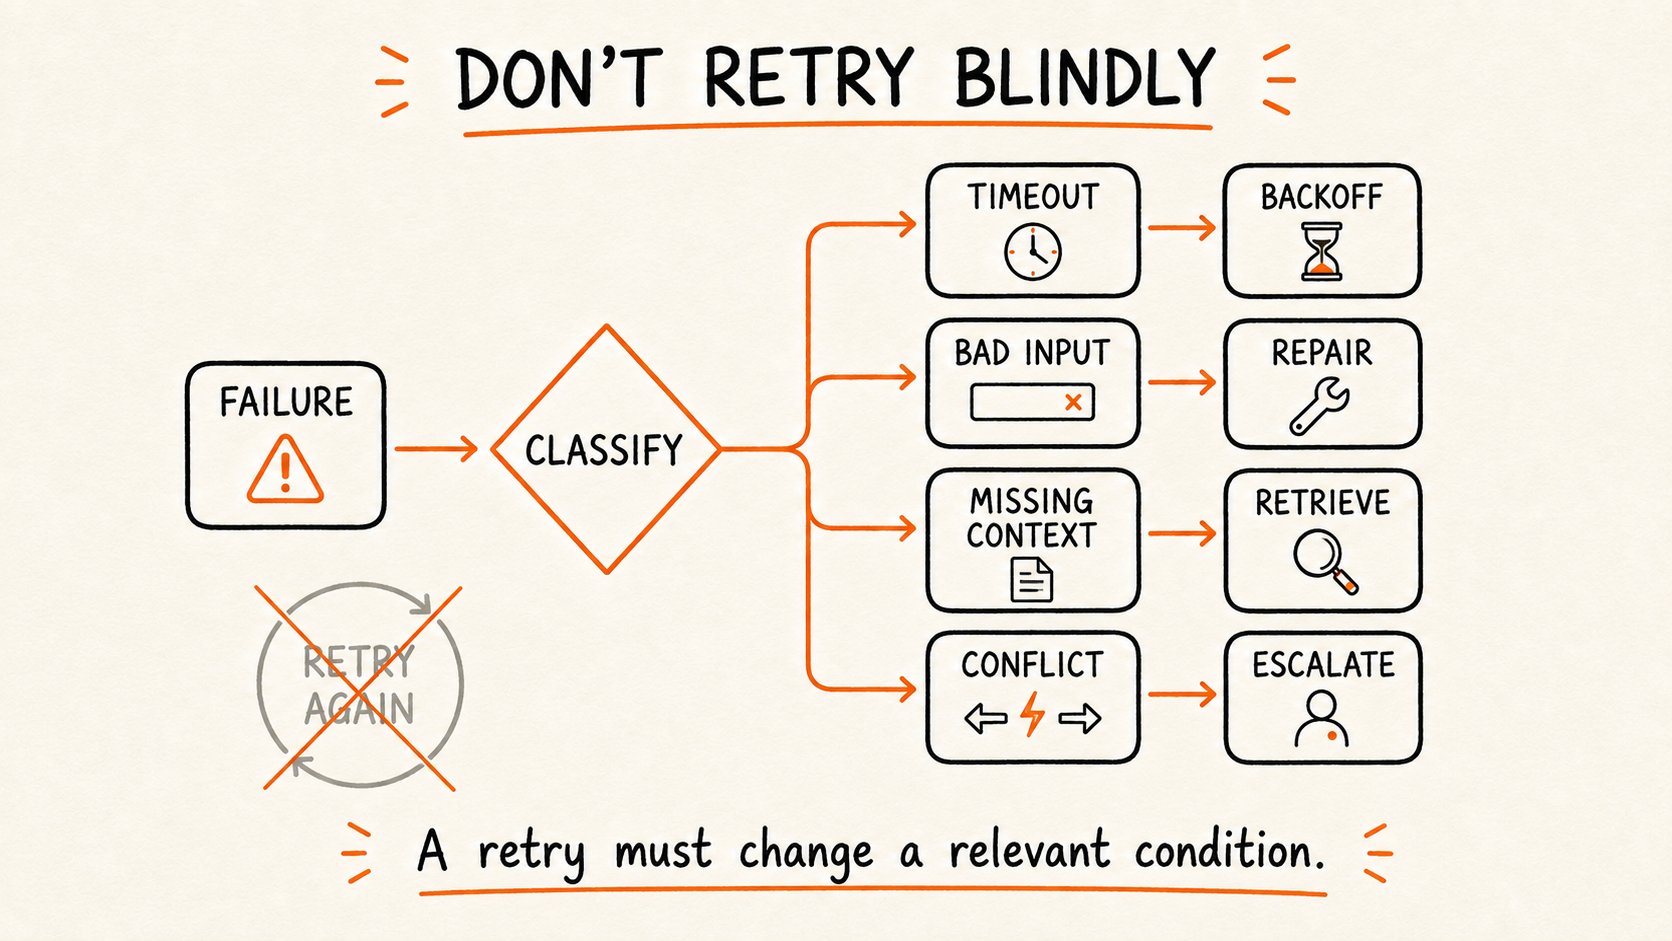
Un retry doit changer au moins une condition pertinente. Sinon, le système paie pour reproduire le même échec.
Une boucle d’agent bornée ressemble à ceci :
observer
  -> décider
      -> agir
          -> mesurer
              -> accepter
              -> réparer
              -> escalader
              -> arrêter
Et toute boucle a besoin d’un budget : nombre maximal de tentatives, temps maximal, dépense maximale, portée destructive maximale, condition d’escalade.
Un agent fiable sait continuer. Il sait aussi quand continuer n’est plus rationnel.
11. Les instructions doivent devenir de l’infrastructure
Les instructions d’agent sont utiles quand elles expliquent une réalité locale. Mais une instruction seule est une application faible. Si une règle compte de façon répétée, faites-la descendre dans la pile :
« utilise le formateur »
-> lancer le formateur automatiquement

« n'importe pas entre les couches »
-> ajouter un test d'architecture

« inclure un rollback de migration »
-> exiger le fichier de rollback en CI

« ne modifie pas les fichiers générés »
-> bloquer l'écriture dans les chemins générés

« cite chaque affirmation externe »
-> valider la couverture des citations
Cela crée une échelle d’instruction :
explication
  -> checklist
      -> template
          -> vérification automatisée
              -> politique appliquée
Déplacez la connaissance importante aussi bas que possible dans cette échelle. Le prompt explique le jugement. Le harness applique les invariants.
12. Observer l’exécution, pas seulement la réponse finale
Un artefact final propre peut cacher un processus désastreux. L’agent a peut-être :
- accédé aux mauvaises données ;
- ignoré une commande en échec ;
- rejoué deux fois une action externe ;
- consommé dix fois le budget prévu ;
- trouvé la bonne réponse pour la mauvaise raison.
Il faut des traces qui rendent l’exécution reconstructible :
09:14  contrat créé
09:15  source de contexte chargée : architecture.md
09:17  fichier édité : checkout.ts
09:18  test ciblé échoué : coupon dupliqué
09:21  implémentation réparée
09:22  test ciblé passé
09:24  test d'intégration passé
09:25  déploiement externe bloqué : validation requise
Une trace utile enregistre les transitions d’état, les sources de contexte, les entrées et sorties d’outils, les changements d’environnement, les résultats de vérification, les raisons des retries, les décisions de validation, le coût et la latence.
Le but n’est pas la surveillance. Le but est la réparation locale : quand un run échoue à l’étape 18, vous devez pouvoir repartir d’un checkpoint fiable au lieu de rejouer toute la tâche.
13. Chaque run a besoin d’un reçu de changement
Les longues transcriptions sont difficiles à relire. En fin d’exécution, le harness devrait compiler un petit reçu :
OBJECTIF
Corriger l'application en double d'un coupon au checkout.

MODIFIÉ
- logique de validation du checkout
- test de régression ciblé

VÉRIFIÉ
- lint passé
- tests unitaires passés
- test d'intégration checkout passé

NON VÉRIFIÉ
- fournisseur de paiement en production

DÉCISIONS
- ordre de priorité des coupons existant préservé

RISQUES
- client mobile legacy indisponible en local

VALIDATION REQUISE
- déployer en staging
Le reçu n’est pas un résumé de ce que le modèle a dit. C’est un résumé de ce que le système peut prouver. Il donne aux humains une surface de revue compacte et à la session suivante un point de départ fiable.
Le meilleur passage de relais n’est pas « voici la conversation ». C’est « voici l’état, les preuves et le risque non résolu ».
14. Chaque échec doit améliorer le harness
Les équipes les plus faibles corrigent la sortie ratée. Les plus solides corrigent aussi le système qui l’a permise.
Après un échec, demandez :
Le contrat de tâche était-il ambigu ?
Un contexte important était-il invisible ?
Le mauvais outil était-il exposé ?
Une précondition manquait-elle ?
Le résultat était-il invérifiable ?
La politique était-elle restée dans le prompt ?
La récupération était-elle trop large ?
La trace était-elle insuffisante ?
Puis convertissez la leçon en amélioration réutilisable :
échec
  -> diagnostic
      -> nouveau capteur, règle, carte, test ou contrat d'outil
          -> les runs futurs s'améliorent automatiquement
C’est le volant d’inertie du harness. Le système devient plus fiable parce que les échecs laissent de l’infrastructure derrière eux.
Une réponse corrigée aide un run. Un harness corrigé aide tous les runs suivants.
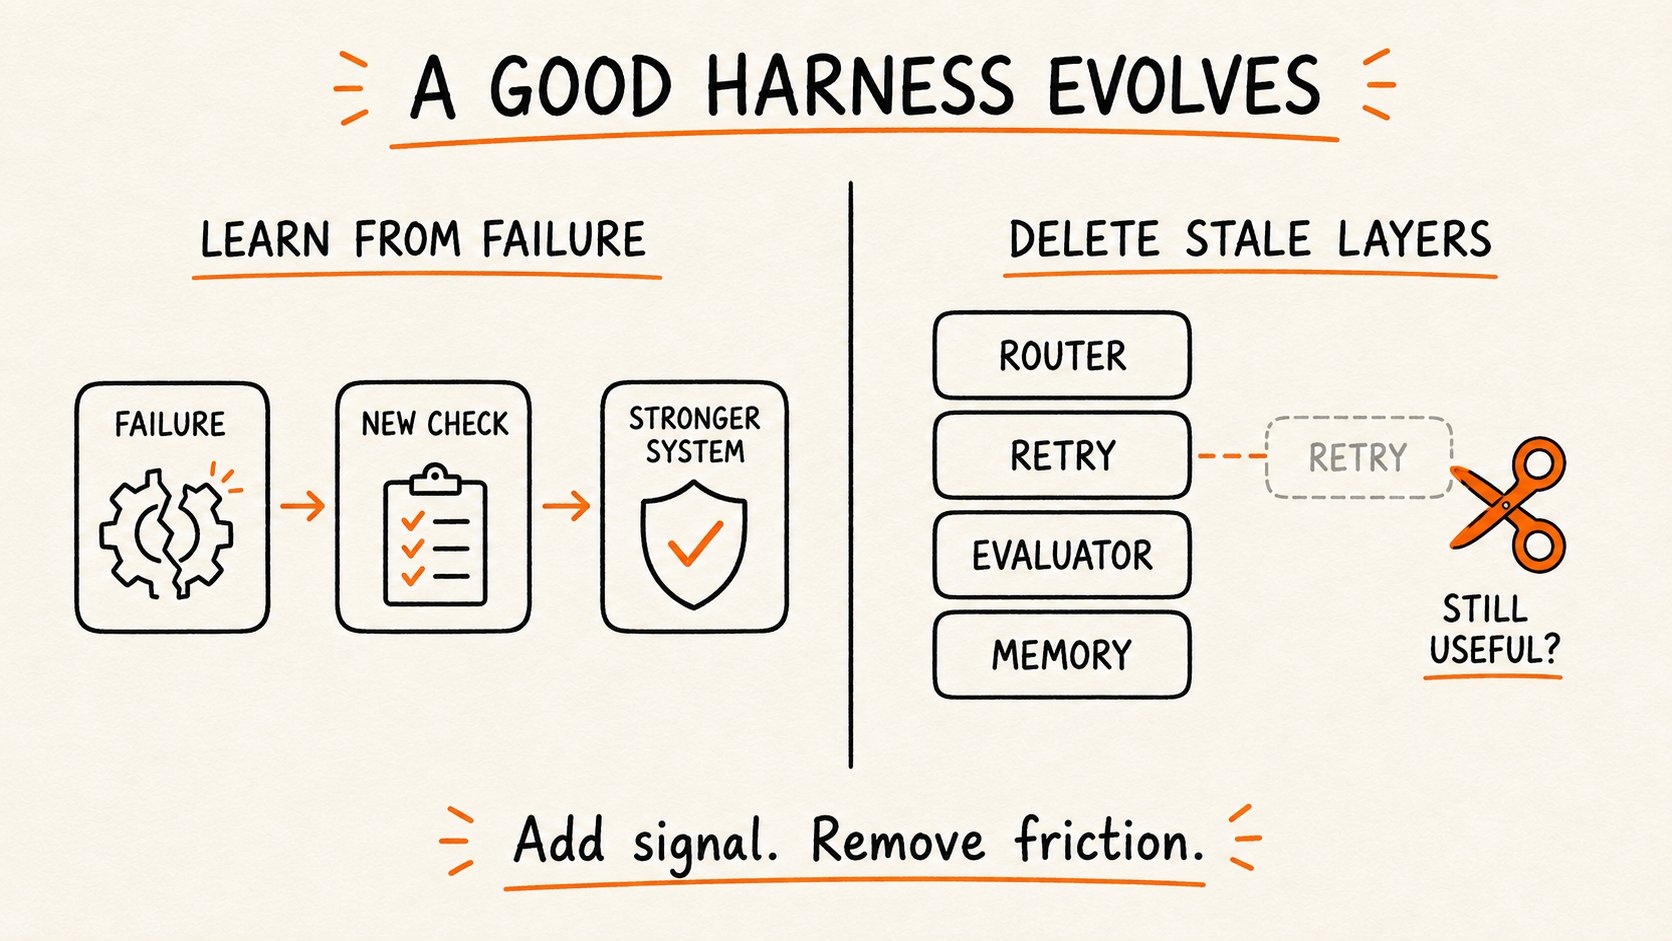
15. Les harness pourrissent aussi
Plus de harness n’est pas toujours mieux. Les modèles progressent, les outils progressent, les tâches changent. D’anciens garde-fous deviennent de la friction inutile. Un contournement créé pour le modèle d’hier peut empêcher le modèle d’aujourd’hui d’utiliser une meilleure stratégie.
C’est la décroissance du harness :
limite de l'ancien modèle
  -> contournement dans le harness
      -> le modèle progresse
          -> le contournement reste
              -> le système devient plus lent ou moins capable
Traitez les composants du harness comme du code de production. Mesurez s’ils apportent encore quelque chose. Pour chaque routeur, évaluateur, couche de mémoire et règle de retry, demandez :
- quel échec cela empêche-t-il ?
- à quelle fréquence cet échec survient-il encore ?
- quelle latence et quelle complexité cela ajoute-t-il ?
- peut-on obtenir le même résultat plus simplement ?
- que se passe-t-il si on le retire ?
Le meilleur harness n’est pas le plus gros. C’est le plus petit système qui ferme de façon fiable l’écart entre l’intention et la preuve.
Construisez pour pouvoir supprimer.
16. Le harness minimum viable
Pas besoin d’une plateforme d’orchestration pour commencer. Construisez par couches.
Niveau 1 — une tâche bornée
- objectif
- périmètre
- contraintes
- critères d’acceptation
Niveau 2 — un environnement lisible
- carte du projet
- commandes
- instructions locales
- dépendances connues
Niveau 3 — des actions contrôlées
- outils typés
- validation des arguments
- frontières de chemins et de permissions
- résultats structurés
Niveau 4 — une exécution durable
- état de run explicite
- checkpoints
- décisions
- leçons
Niveau 5 — des preuves
- vérifications déterministes
- vérification adversariale
- reçu de changement
Niveau 6 — récupération et apprentissage
- classification des échecs
- retries bornés
- escalade
- mises à jour du harness à partir des échecs récurrents
Construisez la plus petite couche qui élimine l’échec que vous avez réellement. Ne commencez pas par une architecture multi-agents parce qu’un prompt a occasionnellement besoin d’une clarification.
La complexité doit être gagnée par l’échec observé.
17. Une spécification de harness réutilisable
Avant de donner une autonomie sérieuse à un agent, définissez ceci :
SPÉCIFICATION DE HARNESS

1. CONTRAT
   objectif :
   périmètre :
   contraintes :
   preuves d'acceptation :

2. CONTEXTE
   carte toujours chargée :
   sources de récupération :
   instructions locales :
   règles de fraîcheur :

3. OUTILS
   outils autorisés :
   préconditions :
   effets de bord :
   preuves de succès :
   politique de timeout et de retry :

4. ÉTAT
   faits :
   décisions :
   progression :
   leçons :
   format de checkpoint :

5. POLITIQUE
   actions automatiques :
   actions soumises à validation :
   actions interdites :
   limites de budget :

6. VÉRIFICATION
   contrôles déterministes :
   contrôles adversariaux :
   règle d'acceptation :

7. RÉCUPÉRATION
   classes d'échec :
   limites de retry :
   conditions d'escalade :
   rollback sûr :

8. OBSERVABILITÉ
   événements de trace :
   métriques :
   reçu de changement final :
Si ces champs ne sont pas définis, l’agent n’est pas autonome. Il improvise.
18. Mesurer au bon niveau
Le nombre de tokens n’est pas la métrique finale. Le nombre de tâches tentées non plus. L’unité utile, c’est le travail accepté :
sorties acceptées
----------------------------------------
minutes de revue humaine + coût du run
Suivez aussi :
- le taux d’acceptation au premier passage ;
- le taux de récupération après un échec d’outil ;
- le taux d’échecs répétés ;
- les interventions humaines par tâche ;
- les affirmations de complétion non étayées ;
- le délai entre la demande et le résultat vérifié ;
- le coût du harness par composant.
Cela évite une illusion fréquente : un agent peut sembler très productif tout en créant un travail de revue coûteux.
L’objectif n’est pas plus d’activité d’agent. C’est plus de résultats dignes de confiance par unité d’attention humaine.
19. Quand vous n’avez pas besoin d’un gros harness
Tous les appels de modèle n’ont pas besoin d’un système d’exploitation. Restez au prompt simple quand :
- la tâche est courte ;
- la sortie est facile à inspecter ;
- l’échec coûte peu ;
- aucun effet de bord externe n’est possible ;
- l’utilisateur reste dans la boucle.
Ajoutez un harness quand :
- le travail traverse plusieurs outils ou sessions ;
- l’environnement peut changer ;
- les actions ont de vraies conséquences ;
- la complétion est difficile à juger à la main ;
- le même échec revient ;
- la revue humaine devient le goulot d’étranglement.
Le but d’un harness n’est pas de faire paraître une démo sophistiquée. C’est de rendre le vrai travail fiable.
Le vrai basculement
La première génération de produits IA était construite autour des prompts. La suivante se construit autour des environnements.
La question n’est plus seulement :
Comment faire mieux répondre le modèle ?
Elle est :
Comment construire un système où les bonnes actions sont faciles, les actions dangereuses sont contrôlées, les échecs sont visibles et la complétion est prouvable ?
C’est le passage du prompt engineering au harness engineering.
Le modèle fournit l’intelligence. Le harness fournit la structure. Ensemble, ils produisent une exécution fiable.
Si votre agent continue de s’effondrer, arrêtez d’ajouter des adjectifs au prompt. Construisez l’environnement dont il a besoin pour réussir.
Vidéos de l'article
- ▶ Ouvrir la vidéo
https://video.twimg.com/amplify_video/2115469079507079169/vid/avc1/1282x720/ASsohEqR90v9x9Cd.mp4?tag=29