Jev côté ingénierie : API, seuils de confiance et garde-fous
Jev côté ingénierie : API, seuils de confiance et garde-fous
Source: rvaniaaaa (@rvaniaaaa) — X Article du 20 septembre 2026
Une entreprise a passé deux ans sans rien dire, puis a lancé un modèle qui ne dit toujours rien, volontairement. En trois jours, des inconnus l’utilisaient pour trouver des vols à moins d’un demi-centime et trier cinq cents e-mails pour le prix d’un chewing-gum.
L’entreprise est TypeSafe AI. Le modèle est Jev, lancé le 15 septembre 2026. Il ne peut pas écrire un e-mail, résumer un document ni produire une ligne de code. Demandez-lui d’écrire quoi que ce soit et il refuse. Ce n’est pas une lacune oubliée. C’est le produit.
Les autres articles de ce blog sur le sujet — la vulgarisation d’Akshay Pachaar et le post de lancement de Diogo Almeida — racontent le quoi. Celui-ci s’intéresse au comment on l’intègre dans du code : ce qu’on déclare, ce qu’on reçoit, où on place le seuil, et ce qu’on fait quand la confiance n’est pas au rendez-vous.
Le test des trois questions, avant d’écrire la moindre ligne
La première chose utile de cet article n’est pas une API, c’est un filtre. Avant de toucher au code, trois questions à se poser sur la décision que tu veux lui confier :
- Peut-on écrire toutes les réponses valides à l’avance ? Si la liste des sorties possibles est ouverte, ce n’est pas une décision pour Jev, c’est une tâche d’écriture.
- Un humain rapide trancherait-il d’un coup d’œil ? Si juger correctement exige de réfléchir et pas seulement de reconnaître, un classifieur n’est pas le bon outil, même s’il coûte presque rien.
- Cela arrive-t-il assez souvent pour que la milliseconde et le centième de centime comptent ? Une décision prise cinq fois par semaine n’a pas besoin d’un accélération de 200×. Une décision prise cinq mille fois par jour, si.
Trois oui, c’est un vrai candidat. Un non, et le choix honnête est de la laisser exactement où elle est.
Testez tout de suite sur un cas réel : « Ce ticket de support est-il urgent ? » Toutes les réponses valides tiennent en deux mots. Une personne regarde le ticket trois secondes et sait. Ça arrive des centaines de fois par jour. Trois oui. Cette décision vous coûtait un appel de génération complet pour quelque chose qui n’en a jamais besoin.
Ce que fait réellement un appel
On donne deux choses à Jev : un état (la situation — un blob JSON, un log, une transcription, n’importe quel texte décrivant l’instant présent) et des questions typées. Les questions viennent en exactement trois formes :
Choice— choisit une option dans une liste que vous définissez (jusqu’à 255) et renvoie une probabilité pour chacune d’elles.Score— place l’entrée sur une échelle ordonnée que vous définissez et renvoie une position pondérée par les probabilités, qui peut atterrir entre deux niveaux plutôt que de s’y coller.Noul— le nom de TypeSafe pour la primitive oui/non : renvoie un nombre entre 0 et 1 représentant à quel point la réponse est vraie.
C’est tout le vocabulaire. Aucune prose à parser. Aucune réparation de JSON quand le modèle décide de vous expliquer d’abord.
result = client.system_one(state=..., questions={
    "owner": Choice(instructions="Which team should handle this?", criteria={...}),
})
# probabilities pour chaque option, en un seul aller-retour,
# évalués en parallèle plutôt qu'un token à la fois
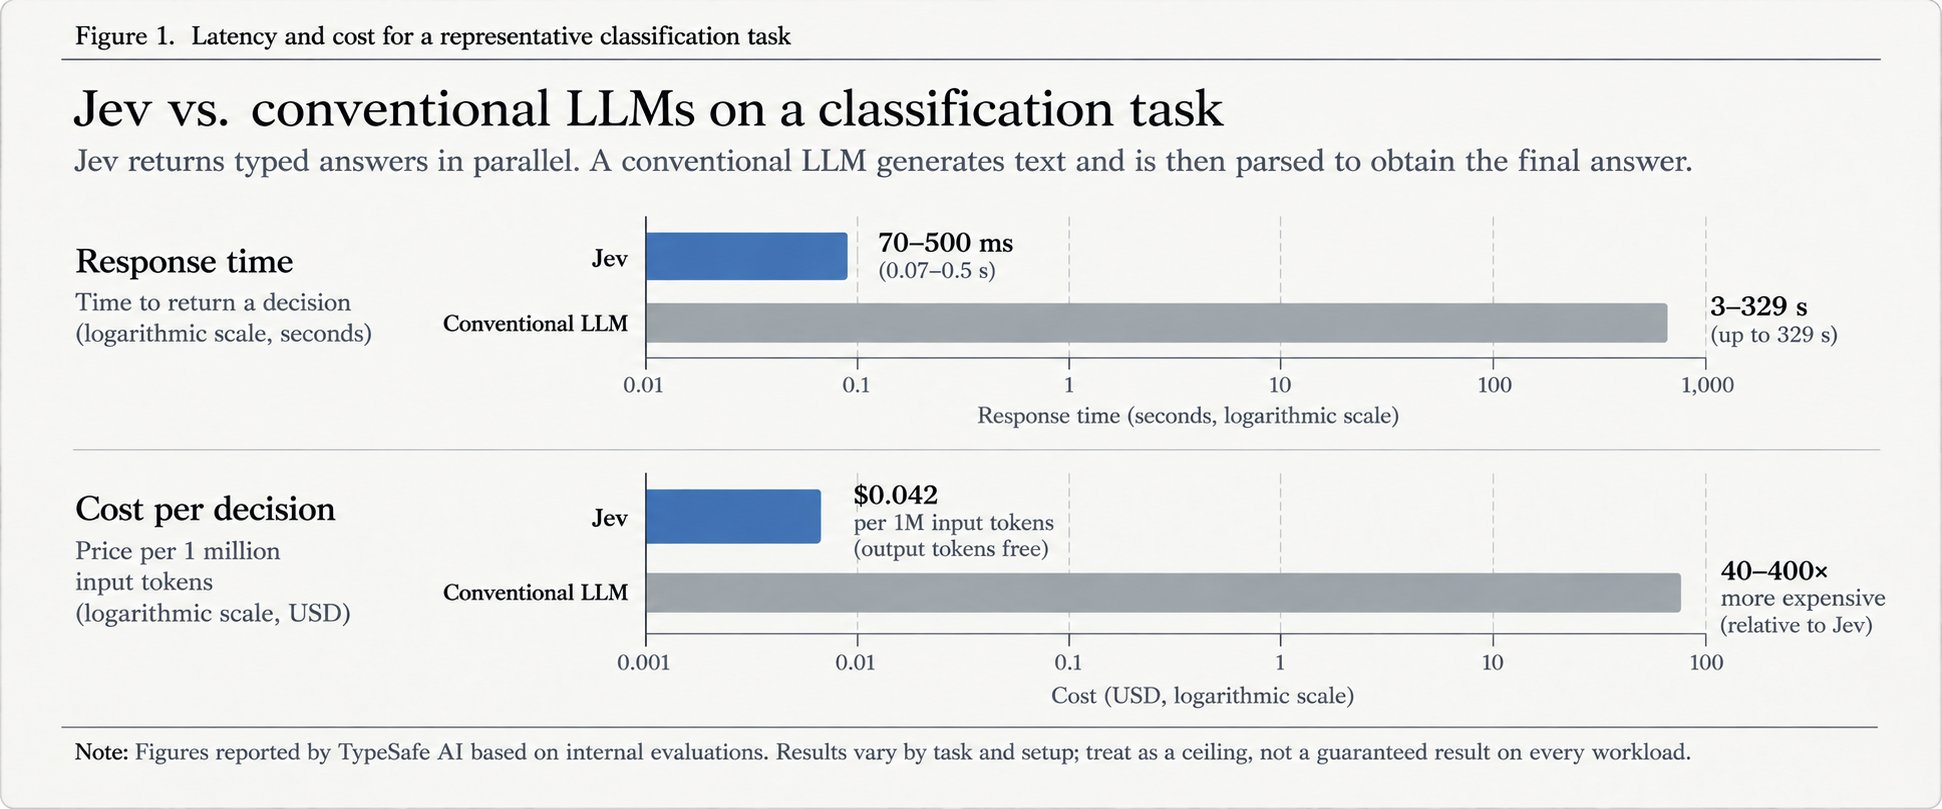
Les chiffres de cette figure — 70 à 500 ms, 0,042 $ par million de tokens d’entrée, tokens de sortie gratuits — sont des déclarations de TypeSafe AI fondées sur ses propres évaluations internes. La légende de la figure le dit d’ailleurs explicitement : « treat as a ceiling, not a guaranteed result on every workload ». Le comparatif « LLM conventionnel » (3 à 329 secondes sur la même tâche) vient de la même source, donc du même éditeur. Rien ici n’est une mesure indépendante.
Installer et brancher : TypeSafeClient
Python 3.10 ou plus récent, puis :
mkdir jev-starter && cd jev-starter
python3 -m venv .venv
.venv/bin/python -m pip install --upgrade typesafe-sdk
Récupérez une clé API dans le dashboard TypeSafe, et branchez votre première vraie décision :
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()  # reads TYPESAFE_API_KEY from the environment

state = {
    "ticket": "The deploy failed twice and customers are seeing 500s.",
    "priority_history": "No prior escalations from this customer.",
}

result = client.system_one(
    state=state,
    questions={
        "urgent": Noul(instructions="Does this need attention right now?"),
        "owner": Choice(
            instructions="Which team should handle this?",
            criteria={
                "engineering": "Product failures and outages",
                "billing": "Charges, invoices, and refunds",
                "sales": "Pricing and new accounts",
            },
        ),
        "severity": Score(
            instructions="Rate how severe this issue is.",
            criteria=["Cosmetic", "Minor", "Major", "Critical"],
        ),
    },
)

print(result.answers["urgent"].noul)        # e.g. 0.94
print(result.answers["owner"].choice)       # "engineering"
print(result.answers["owner"].confidence)   # e.g. 0.87
Trois questions, un appel API, un aller-retour. Les trois sont évaluées en parallèle sur le même état, et c’est pourquoi ajouter une quatrième ou une cinquième question ne déplace presque pas la latence. Deux points d’API à noter, parce qu’ils conditionnent la façon dont on écrit le reste du programme : Choice renvoie bien une distribution de probabilités sur toutes les options, et Score renvoie une position continue — pas un niveau unique.
Le seuil de confiance, et le repli qui va avec
Votre code décide de ce qui arrive ensuite :
if result.answers["urgent"].noul > 0.9 and result.answers["owner"].choice == "engineering":
    page_on_call()
elif result.answers["owner"].confidence < 0.6:
    send_to_human_review()
else:
    add_to_queue(result.answers["owner"].choice)
Ce dernier bloc, c’est toute l’architecture en miniature. Jev répond à la question floue ; du code ordinaire, du code que vous pouvez tester unitairement, possède toutes les branches ensuite.
Chaque décision bornée reçoit son propre seuil d’acceptation, et tout ce qui ne le franchit pas retombe sur le modèle qui sait réellement raisonner dans l’ambiguïté :
def handle_ticket_routing(ticket_state):
    result = jev.system_one(state=ticket_state, questions=ROUTING_SCHEMA)
    owner_answer = result.answers["owner"]

    if owner_answer.confidence < 0.75:
        return escalate_to_full_model(ticket_state)  # too close to call

    return owner_answer.choice
Un nombre élevé renvoyé par Jev dit qu’il est sûr. Il ne dit pas qu’il a raison — et tout l’écart entre certitude et justesse est précisément la raison pour laquelle le seuil existe, réglé séparément pour chaque type de décision plutôt qu’un nombre réutilisé partout.
L’audit d’agent : le vrai levier n’est pas le ratio
C’est le point le plus important de l’article, et le plus facile à rater. La fourchette publiée par TypeSafe est 20 à 200× plus rapide et 40 à 400× moins cher — là encore, déclaration éditeur, et plafond selon la figure citée plus haut.
Mais le vrai multiplicateur ne vient pas de Jev étant 200× plus rapide qu’un LLM sur un appel contre un appel. Il vient de la densité de décisions. Prenez un agent qui traite un ticket de support de bout en bout : lire la réclamation, vérifier si elle correspond à un bug connu, décider quelle équipe la porte, évaluer l’urgence, confirmer que le correctif a résolu le problème avant de fermer. Quatre de ces cinq étapes ont une réponse courte et bornée. Une seule — lire la réclamation — a réellement besoin de langage.
Dans une installation standard, les cinq passent pourtant par le même modèle génératif, chacune écrivant un paragraphe de raisonnement avant d’atterrir sur une réponse qui n’avait jamais que deux ou trois formes valides. Sortez les quatre étapes bornées et routez-les vers Jev : vous ne rendez pas un appel plus rapide, vous supprimez quatre appels de génération à coût plein pour chaque ticket, en volume, toute la journée.
La plupart des factures d’agent ne sont pas cheres parce que le travail est difficile. Elles sont chères parce que quatre étapes sur cinq n’ont jamais été censées être bon marché.
Un flux surtout génératif (écrire un long document à partir de zéro) n’approche pas le plafond annoncé. Un flux dense en décisions bornées s’en rapproche. La vraie compétence est donc d’auditer son propre agent avant de choisir un modèle, pour repérer quelles décisions n’étaient jamais des décisions que le modèle de langage devait prendre.
Les démos publiques des 72 premières heures
Ce qui a réellement fait réagir le monde, ce sont des développeurs qui ont testé Jev en public dans les trois jours suivant le lancement. Attention : cette section est de seconde main. Ce sont les chiffres rapportés par l’auteur de l’article, pas des benchmarks contrôlés par un tiers — la distinction est d’ailleurs écrite sous le tableau lui-même.
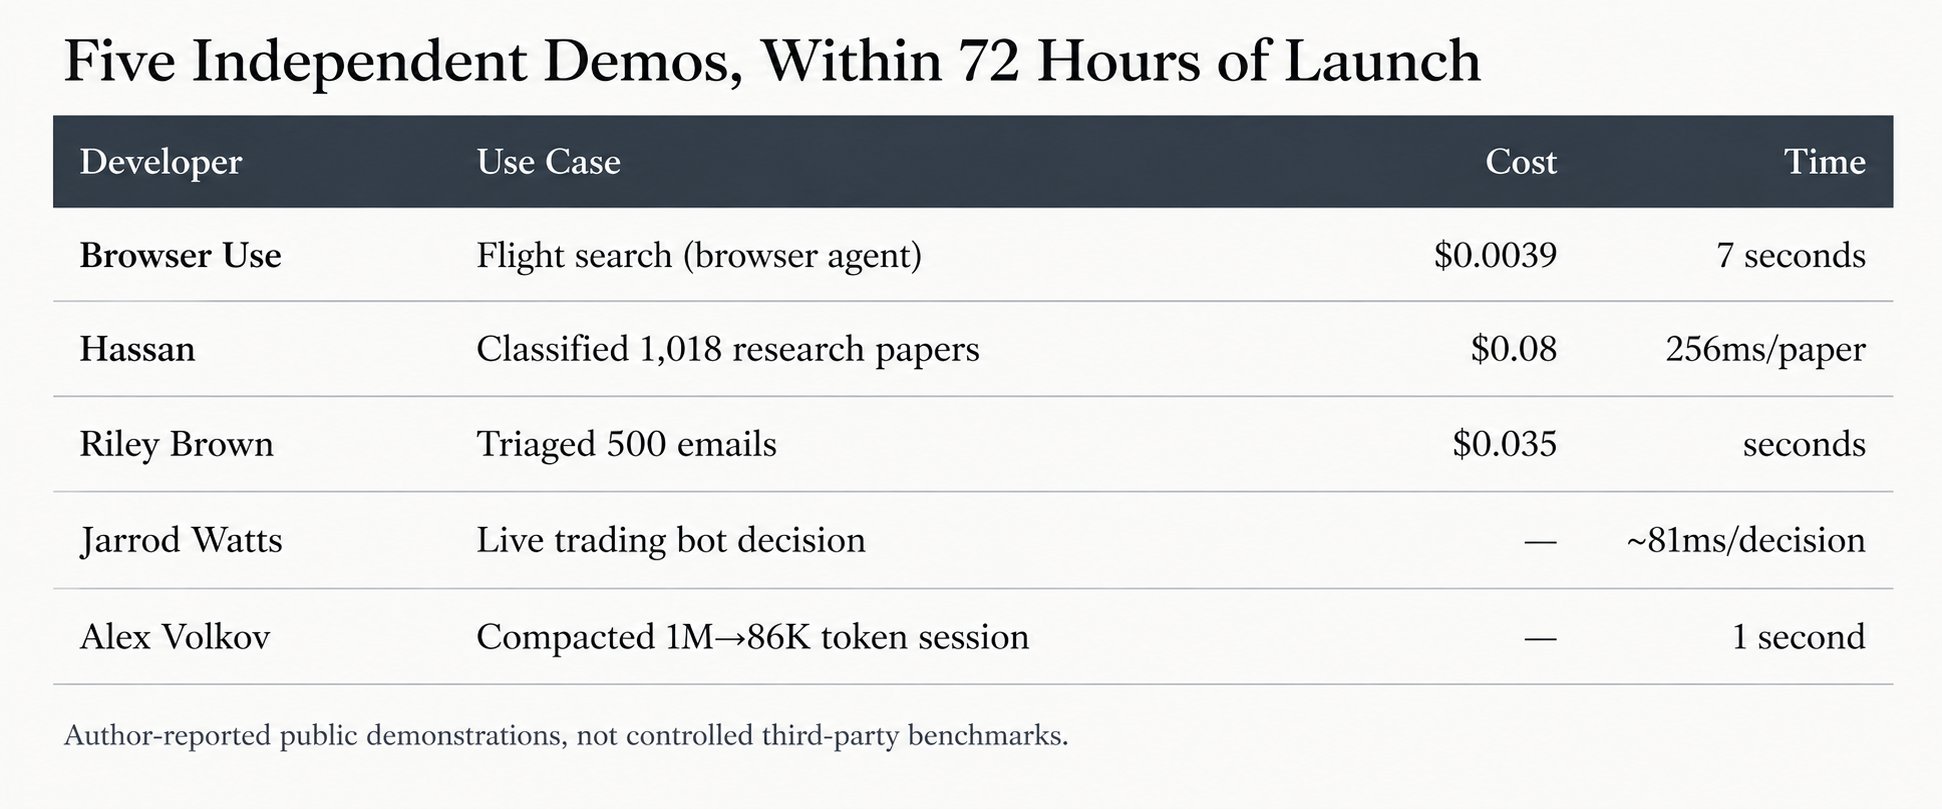
Le tableau ci-dessus est celui de l’article X, et sa légende assume le statut de ces chiffres. En résumé :
- Browser Use a branché Jev dans un agent qui lit une page web vivante, décide du prochain clic et l’exécute : résultats de vols trouvés en 7 secondes pour 0,0039 $. Non simulé, vidéo publique et horodatée, à vitesse réelle.
- Hassan a fait classifier 1 018 vrais papiers de recherche IA, un sujet par document. Coût total : 0,08 $. Temps médian par papier : 256 ms.
- Riley Brown a fait trier 500 vrais e-mails (répondre, chercher, attendre, réviser). Coût total : 3,5 cents.
- Jarrod Watts a monté un bot de market-making vivant sur la blockchain Monad, Jev décidant achat ou vente sur un vrai carnet d’ordres à chaque bloc de 300 ms. Le dépôt a dépassé 1 000 étoiles GitHub en trois jours, avec un tableau de bord public affichant des décisions à 81 ms.
- Alex Volkov a utilisé Jev comme plugin dans Claude pour examiner quels appels d’outils d’une session étaient réellement nécessaires. Il a compacté une session Claude de près d’un million de tokens à 86 000, en une seconde. Pas une passe de résumé : un filtre de pertinence à la vitesse de Jev.
C’est convaincant comme signal d’adoption — des tiers ont construit des choses et montré les reçus. Ce n’est pas une mesure de qualité : aucune de ces démos ne rapporte de taux d’erreur sur le fond, ce qui est précisément la variable qui déciderait de la décision de seuil.
Le garde-fou d’outils déjà en production
LangChain a construit un middleware qui fait passer chaque appel d’outil proposé par Jev avant son exécution, bloquant les actions risquées et approuvant les sûres :
from langchain.agents import create_agent
from langchain_typesafe.experimental.middleware import AutoModeMiddleware

# Jev checks every tool call before execution.
# Blocks risky actions, approves safe ones. Zero generation tokens spent on the check.
guardrail = AutoModeMiddleware(tools=["bash"])
agent = create_agent("openai:gpt-5.6-luna", middleware=[guardrail])
Une ligne de middleware. Chaque appel d’outil dangereux passe maintenant par un classifieur, à une fraction de centime, au lieu de faire confiance au même modèle qui a écrit la commande pour juger si elle est sûre. C’est le découplage le plus intéressant de tout le sujet : le modèle qui propose et le modèle qui autorise ne sont plus le même.
Les outils de développement comme Claude Code, Codex et Cursor ont discrètement livré une version de cette porte de classification depuis un moment, enfouie dans les parties closed-source de leur propre harnais. Ce qui a changé le 15 septembre, c’est que le même motif n’est plus enfermé.
Ce qu’il faut écrire dans le code, en clair
Jev ne peut pas casser son propre schéma de réponse. Si vous définissez trois catégories valides, il n’inventera jamais une quatrième. TypeSafe décrit cela comme une incapacité à halluciner, et c’est vrai — mais sous une définition étroite qu’il vaut la peine de préciser.
Il peut tout à fait choisir la mauvaise option valide, avec confiance, et il n’y aura aucun message d’erreur pour cela : renvoyer une réponse assurée est exactement ce qu’il est conçu pour faire.
Le cas le plus vicieux n’est pas la mauvaise catégorie, c’est le schéma qui se chevauche en secret. Trois catégories — « remboursement », « excuses », « escalade » — semblent distinctes et se recouvrent en permanence : la plupart des demandes de remboursement veulent aussi des excuses, et beaucoup d’escalades commencent comme de simples demandes de remboursement. Un modèle forcé de choisir exactement un élément parmi trois options qui n’ont jamais vraiment été séparées choisira quand même, à chaque fois, avec un score de confiance qui a exactement la même allure que le choix soit évident ou pile ou face.
Le correctif n’est pas un meilleur modèle. C’est de réécrire les trois catégories pour qu’elles ne décrivent pas secrètement le même ticket sous trois angles différents.
TypeSafe est assez direct sur la ligne à tracer. Jev ne génère pas de texte et ne conçoit pas une stratégie à partir de rien. Il ne peut pas enchaîner un jugement sur le suivant à l’intérieur d’un même appel, puisque chaque question d’une requête est répondue isolément : une décision qui dépend d’une autre décision demande toujours deux allers-retours distincts. Et il n’a rien à faire dans le microseconde, le territoire d’une infrastructure de trading colocalisée.
Surtout : aucune de ces vitesses ne change si une réponse était correcte. Dans un système de support où « urgent » et « non urgent » semblaient former un partage binaire propre sur le papier, Jev rangera une vraie urgence dans la mauvaise file en 90 ms, avec assurance, parce que la formulation ressemblait à cent fausses alertes qu’il avait correctement ignorées avant. L’erreur n’est pas devenue plus petite parce qu’elle est arrivée vite. Elle est devenue coûteuse plus vite — et personne n’a su jusqu’à ce qu’on cherche pourquoi le ticket dormait.
Ce que je retiens
Jev n’est pas un modèle de chat plus intelligent, et il n’a jamais prétendu l’être. C’est un pari : une bonne partie de ce que le logiciel appelle « intelligence » était de la classification portant un paragraphe comme déguisement, facturée au prix de la génération pour une réponse qui n’avait jamais que deux ou trois formes valides.
Le conseil pratique de l’article, qui est aussi le meilleur : ouvrez la dernière session d’agent que vous avez vraiment exécutée et comptez. Partout où elle s’est arrêtée pour décider quelque chose, et non pour écrire quelque chose, faites passer le test des trois questions. La plupart des sessions en cachent plus qu’on ne le remarque au premier passage — jusqu’à ce qu’on aille spécifiquement chercher la pause.
Pour le reste — l’explication généraliste du modèle et le contexte du lancement, lus dans l’ordre :
- Jev clairement expliqué — vulgarisation, source Akshay Pachaar
- Jev in short — le post de lancement de Diogo Almeida