Un moteur de vidéo faceless unique pour n'importe quel sujet (NotebookLM + Google Flow)
Un moteur de vidéo faceless unique pour n’importe quel sujet (NotebookLM + Google Flow)
Source: The AI Garage — vidéo du 3 octobre 2026, « NotebookLM: Build ONE Faceless Video Engine That Works for ANY Niche » — 10 min 13 s
Dix minutes, quatre outils, un document produit de bout en bout. La thèse tient en une phrase, énoncée dès la première seconde : « One faceless video engine where the niche is just an input. »
Le reproche habituel fait aux chaînes « faceless » est que leur outillage est à moitié figé. On construit une bibliothèque de sources, des règles de rédaction, un catalogue d’images pour l’histoire ancienne ; le jour où on veut passer à la finance ou à la true crime, tout est à refaire. La réponse proposée ici n’est pas un outil de plus, c’est une invariance : on construit le moteur une fois, la niche devient une variable.
La démonstration est faite sur l’histoire ancienne, avec un sujet unique — le site de Göbekli Tepe (le transcript automatique le rend tantôt « Gobecée », tantôt « Gobeclete »), 11 500 ans, dans le sud-est de la Turquie, qui a déplacé le calendrier de la « révolution néolithique ». Le site sert de cas d’école, pas de sujet : à chaque étape, l’auteur montre ce qui change et ce qui ne change pas quand on change de niche.
Voici les quatre étapes, dans l’ordre où elles apparaissent (0:00 le problème, 1:02 recherche et script, 2:53 plan visuel, 4:59 production, 7:26 montage).
Étape 1 — Sujet et script, avec deux notebooks NotebookLM
La partie la plus concrète de la vidéo. Elle occupe deux notebooks distincts, et non un seul.
Le premier notebook : le moteur de sujets
Trois sources larges sont importées — Ancient History (Wikipédia), Civilization (World History Encyclopedia), Cradle of Civilization (Wikipédia). Puis, dans Settings → Chat → Custom, on colle un prompt de « topic engine » dont on substitue la variable de niche, et on demande :
Give me 10 video ideas for my faceless YouTube channel in ancient history
Le choix retenu est « the 11,500-year-old temple that broke history », avec l’angle que NotebookLM propose dans la même réponse. Ce point est important : l’angle n’est pas inventé ensuite par l’auteur, il vient du moteur de sujets. Changez de niche, et l’angle sort de la même façon.
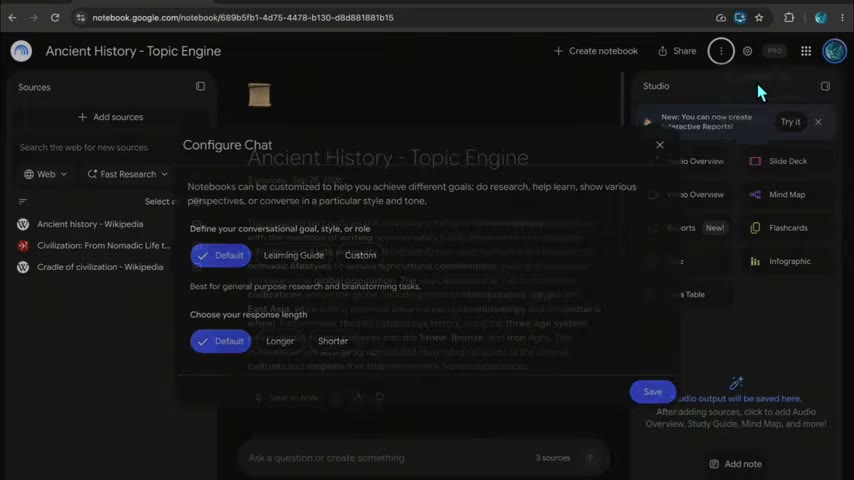
Le conseil donné sur le choix des sources : au stade du moteur de sujets, mieux vaut des sources larges que des sources déjà ciblées, parce qu’on veut que le moteur « voie autant de directions que possible avant d’en choisir une ». C’est l’inverse de l’intuition, et c’est la bonne idée — un notebook déjà verrouillé sur un sujet ne peut plus proposer de sujet.
Le deuxième notebook : la recherche resserrée
Nouveau notebook, Add sources → Web, mode Fast Research, recherche sur les fouilles de Göbekli Tepe. NotebookLM trouve 10 sources, on les sélectionne toutes et les importe.
On colle ensuite le prompt du « script engine », avec le titre et l’angle récupérés du premier notebook, et on demande un script d’environ 750 mots.
L’argument qui justifie tout le notebook : le script produit arrive avec des numéros de citation, et chaque numéro ouvre la source exacte derrière l’affirmation.
So I can verify the script instead of simply trusting the generated answer.
C’est le seul moment de la vidéo où la chaîne documentaire est réellement outillée. Partout ailleurs, le contrôle repose sur l’œil de l’auteur ; ici, il repose sur un lien. Pour une niche historique — où une date fausse se voit — c’est confortable. Pour une niche où l’erreur est invisible (chiffres, santé, droit), le mécanisme reste valable : chaque affirmation traçable reste vérifiable.
Étape 2 — Le plan visuel, dans ChatGPT
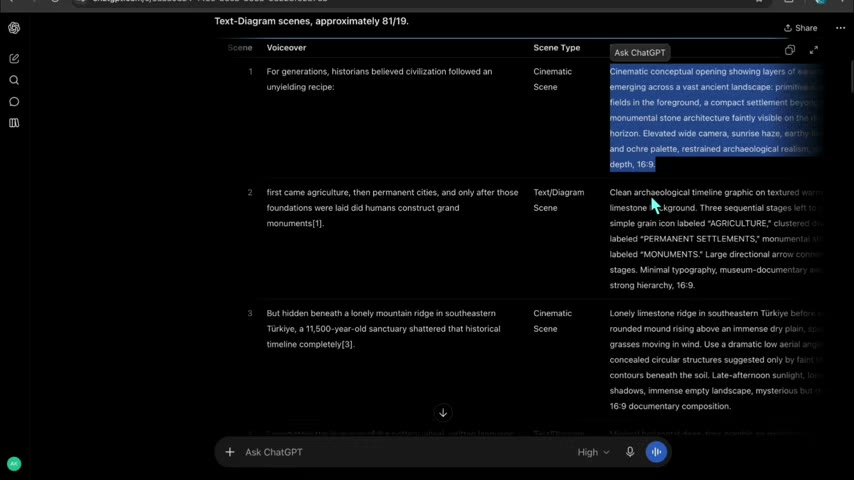
C’est la pièce centrale de l’argument, et de loin la plus transférable. Dans une nouvelle conversation ChatGPT, on colle le « visual plan prompt » en substituant la niche. Il produit un style visuel global, puis découpe la narration en cinq colonnes :
| Colonne | Contenu |
|---|---|
| Scene | le numéro de la scène |
| Voice over | le texte narratif de la scène |
| Scene type | Cinematic Scene ou Text/Diagram Scene |
| Image prompt | le prompt de génération d’image |
| Motion prompt | le prompt d’animation, assorti à l’image |
Il n’existe que deux types de scènes :
- Cinematic Scene — environnements, personnages, architecture, atmosphère, reconstitution historique ;
- Text/Diagram Scene — ce qui est plus clair en carte, frise, comparaison, structure ou schéma explicatif.
Pour ce documentaire, la cible est 80 % cinématique / 20 % texte ou diagramme. Et le ratio, lui aussi, est une variable : la finance pencherait vers plus de diagrammes, un récit plus cinématique vers moins.
À noter tout de même : l’en-tête du plan affiché à l’écran annonce « Text-Diagram scenes, approximately 8/19 ». Sur les 19 scènes planifiées, cela fait donc 8 scènes de diagramme, pas 4 — soit 42 %, loin de la cible de 20 % annoncée. Le ratio est bien une variable, mais le générateur ne l’a pas respecté au premier coup.
Chaque ligne porte son image prompt et son motion prompt. L’effet recherché est explicite : « before production begins, every line already has a visual purpose ». La question que le planteur pose pour chaque ligne est une seule, et elle est bonne :
What is the clearest visual for this idea?
Quand on passe à la finance, on ne reconstruit pas le tableau : on change les règles visuelles (plus de graphiques, de callouts de données, de comparaisons, moins de reconstitutions). En productivité ou en IA, les mêmes lignes deviennent des captures d’interface, des diagrammes de flux, des écrans avant/après, des animations de processus.
Étape 3 — La production par lots, dans Google Flow
Dans un nouveau projet Flow, mode agent. Les réglages, montrés à l’écran :
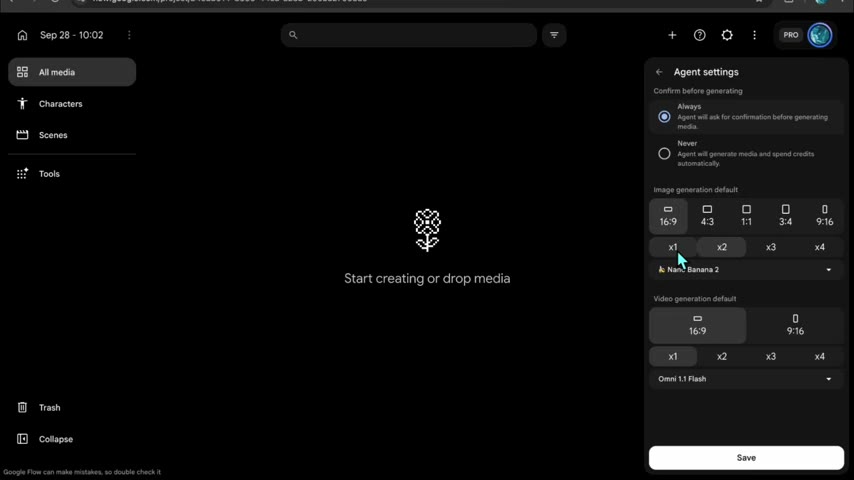
Confirm before generating→ Never ;- format de sortie image → 16:9 ;
- format de sortie vidéo → 16:9 ;
- modèles par défaut affichés : Nano Banana 2 (image) et Omni 1.1 Flash (vidéo).
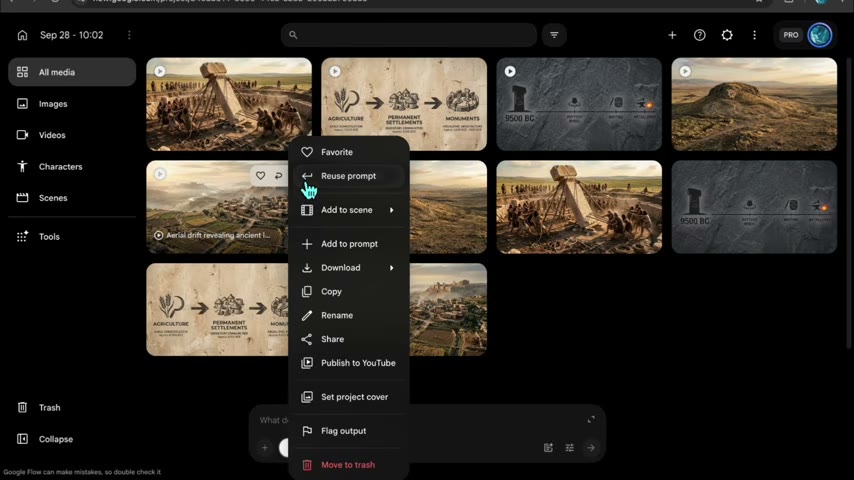
Seules les cinq premières scènes sont produites — assez pour montrer la technique par lots, puisque ces cinq-là contiennent déjà les deux types (1, 3 et 5 cinématiques ; 2 et 4 texte/diagramme).
La manœuvre est purement textuelle. On copie les prompts d’image des scènes 1 à 5 depuis le plan visuel, on tape create these scenes, puis on étiquette scene 1 … scene 5 et on colle le prompt correspondant sous chacun. Un seul envoi produit cinq images 16:9 distinctes.
Puis l’animation, exactement au même endroit : on ajoute les cinq images au prompt de l’agent, on tape animate these scenes, et on colle le motion prompt de chaque scène.
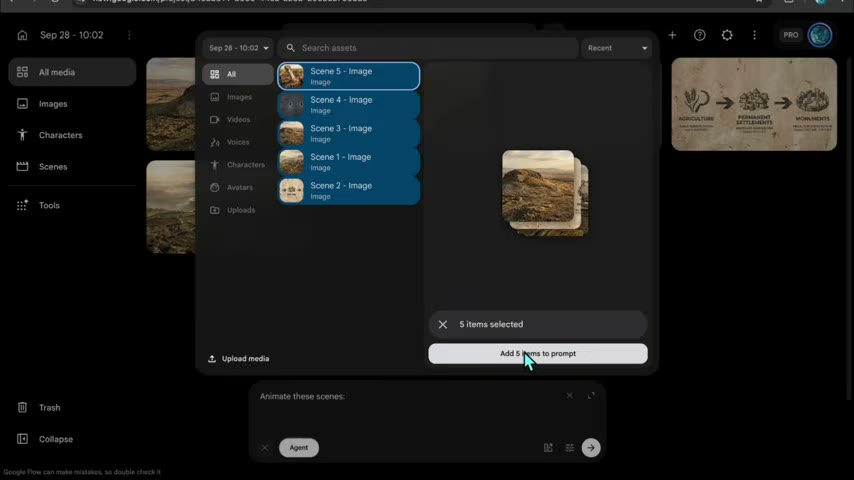
La phrase qui résume l’étape :
There’s no new production decision every five scenes because those decisions were already made in the visual plan.
Plus de décision de production à prendre tous les cinq plans : type de scène, prompt d’image, prompt de mouvement et voix off sont déjà dans un tableau unique et structuré. Passer de l’histoire ancienne à la finance ou à l’IA change ce qu’on met dans les lots, pas comment les lots sont produits.
Étape 4 — Voix, musique et montage
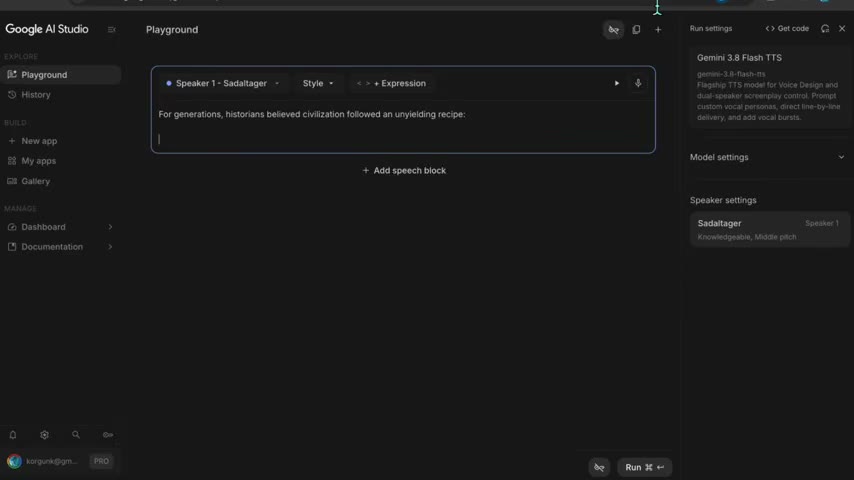
Voix off — Google AI Studio
On utilise le modèle Gemini 3 Flash TTS, avec la voix Sadaltiger (« knowledgeable, middle pitch », le registre qui colle au style documentaire). On colle la voix off des cinq premières scènes issue du plan visuel, on génère, on vérifie la diction, on télécharge l’audio.
Musique — bibliothèque audio de YouTube Studio
Filtres genre : Cinematic, ambiance : Dramatic. Après quelques écoutes, le morceau retenu est « How to Train Your Dragonet » d’Ezra Lipp.
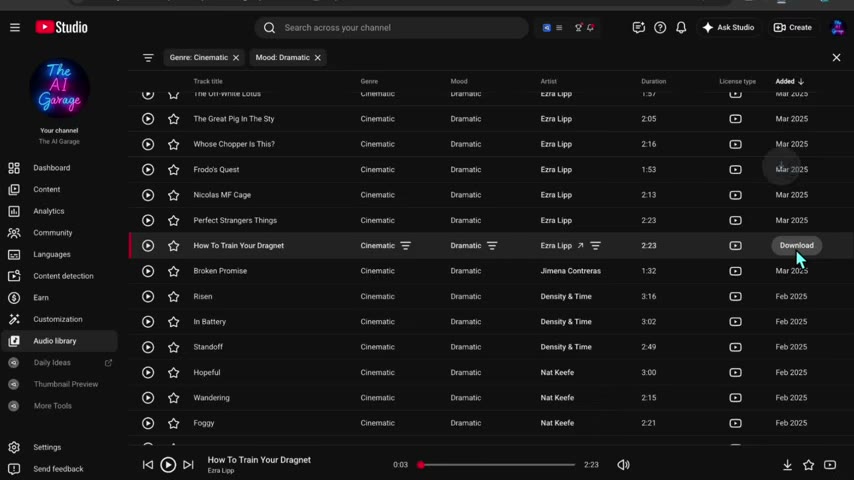
C’est un détail qui en dit long sur le calibrage de la chaîne : on reste dans un catalogue dont les droits sont couverts par la plateforme, pas dans une banque musicale à/licencer.
Montage — CapCut
Import de la voix off, des cinq plans et de la musique. Puis, dans l’ordre indiqué par le plan visuel :
- caler chaque plan sur sa narration ;
- rogner un plan plus long que sa section de voix off, pour que le visuel finisse avec l’idée ;
- poser la musique en dessous et baisser le volume pour qu’elle soutienne la narration ;
- fondus là où c’est nécessaire ;
- coupes franches, pas de transitions lourdes entre chaque plan — « when the visuals and story are already doing the work ».
Puis une dernière passe sur le timing, les niveaux audio et l’ordre des scènes, et export.
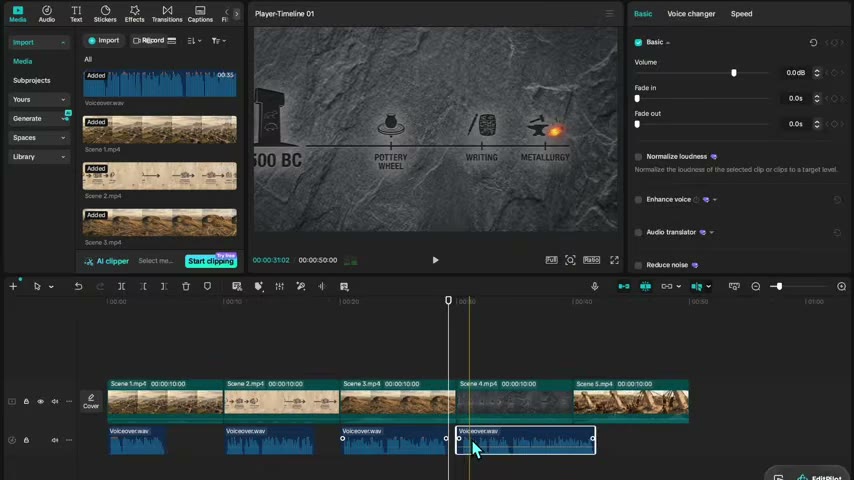
Le résultat
La vidéo termine sur le document produit — les cinq scènes assemblées, avec la voix off, la musique et les coupes franches.
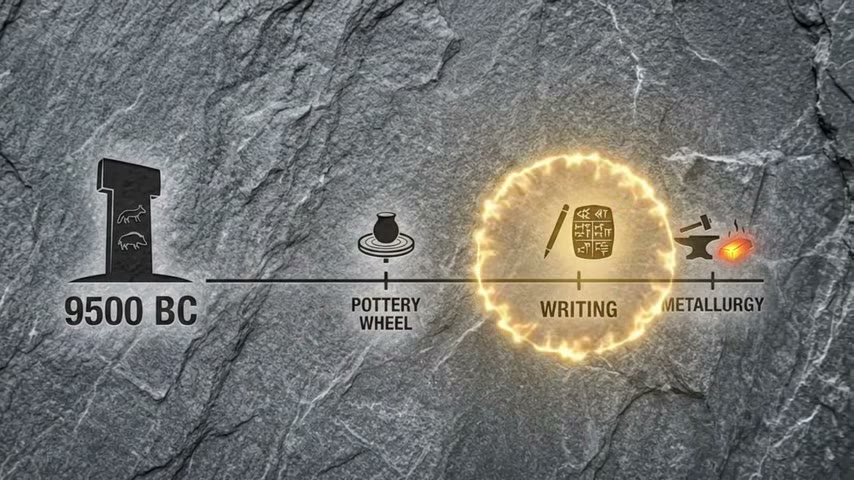
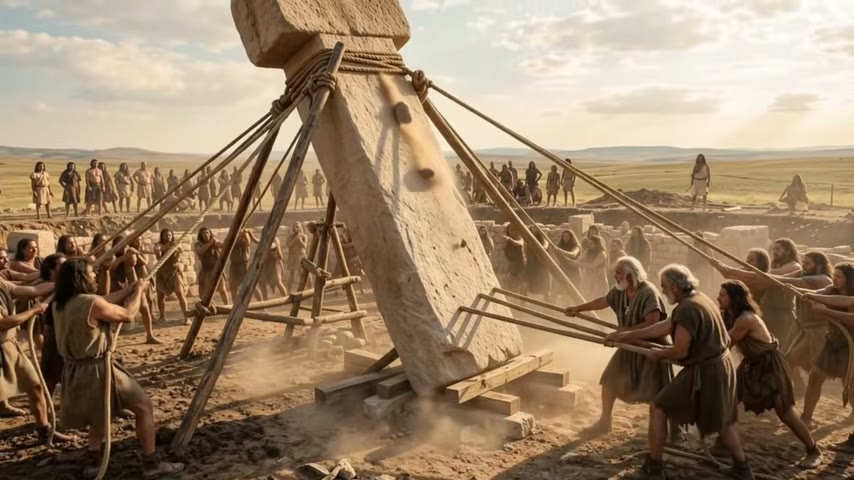
La narration jouée à la fin, pour ce qu’on peut en juger :
For generations, historians believed civilization followed an unyielding recipe. First came agriculture, then permanent cities, and only after those foundations were laid did humans construct grand monuments. But hidden beneath a lonely mountain ridge in southeastern Türkiye, an 11,500-year-old sanctuary shattered that historical timeline completely.
Sur le fond, l’argument est tenu : la vidéo elle-même est produite par le moteur qu’elle présente, et c’est même son argument de vente principal (« This video was made using my Faceless YouTube Engine system »).
Ce que la vidéo ne montre pas
Trois limites, qu’il vaut mieux dire que taire.
Les prompts ne sont pas dans la vidéo. C’est le paradoxe du format : la démonstration montre où coller le prompt et à quoi il doit ressembler — un plan en colonnes, une liste de scènes étiquetées — mais jamais son contenu. L’auteur les envoie en commentaire (« Comment Prompts and I’ll send you the exact prompt I used ») et vend un guide Gumroad de neuf étapes. Un lecteur pressé peut reproduire la mécanique ; il ne peut pas reproduire les instructions sans quitter la vidéo.
Cinq scènes sur dix-neuf. Le plan visuel complet compte 19 scènes — l’en-tête du tableau l’indique (« approximately 8/19 ») — et seules les cinq premières sont produites, pour la démonstration. La fin — les 14 scènes restantes, le document complet — est décrite, pas montrée. La preuve qui manque est donc précisément la preuve de tenue en charge.
Le contrôle humain, lui, reste très inégal. Le script est vérifiable (citations), mais les prompts d’image ne le sont pas : personne ne relit 19 prompts d’image avant de lancer la génération. Sur les deux scènes « Text/Diagram » montrées ici, les graphics sont propres — mais ce n’est pas une garantie : le lettrage généré par IA reste le point de rupture habituel de ce type de chaîne, et la vidéo ne montre aucun cas où c’est raté.
Reste que la démonstration est soignée : le décalage entre la voix off et l’image est respecté dans les cinq scènes, le choix de la voix « middle pitch » est explicité, le ratio 80/20 est posé comme une variable et non comme un dogme. Et l’objection de départ — « le moteur casse dès que la niche change » — reçoit une réponse structurée plutôt qu’un outil de plus : les sources changent, les règles d’écriture changent, le langage visuel change ; le moteur, non.
Outils cités — NotebookLM · ChatGPT · Google AI Studio · Google Flow · CapCut · YouTube Audio Library
Chaîne : The AI Garage — 7 236 vues, 129 likes au moment de la rédaction.