Penser critique quand les agents font le travail
Penser critique quand les agents font le travail
Source: Addy Osmani (@addyosmani) — post du 3 novembre 2026 · 3 716 525 vues, 15 988 likes, 2 459 reposts
Article original : Critical thinking when agents do the work — lire sur X
Autrefois, on enseignait l’esprit critique comme une manière d’aborder l’information : curiosité humble, plus une saine dose de scepticisme. Prendre connaissance des différents points de vue, se forger le sien. C’est toujours vrai. Mais de plus en plus, rien dans mon quotidien ne m’oblige à penser de façon critique, maintenant que l’essentiel de mon travail passe par des agents. Aux ingénieurs et aux profils produit qui ont pleinement adopté les workflows agentiques — plusieurs sessions en parallèle, en attendant que les modèles s’améliorent — je veux dire ceci : je suis un grand fan de ces outils. Je n’écris pas pour plaider en faveur de moins d’agents.
Mon objectif est de vous aider à garder l’esprit critique dans un monde où il est facile de tout déléguer à un agent.
Avant, l’essentiel de notre traitement cognitif et esthétique se faisait dans l’espace entre la question et la réponse. Cet espace se mesure désormais en secondes. Plus vous utilisez de workflows agentiques, plus cela devient difficile — mais pas de la façon qu’on imagine : à mesure que les modèles progressent, le pourcentage d’erreurs évidentes baisse. Beaucoup de sorties (la plupart ?) seront bien écrites et à peu près correctes, et elles ne réclameront pas un second regard.
Même si vous faites tourner plusieurs agents à la fois, vous n’avez toujours qu’une seule paire d’yeux pour lire les résultats.
Il faut donc inscrire l’esprit critique dans votre journée, parce que par défaut rien ne le fera pour vous.
Une partie de la difficulté vient de ce que ces workflows sont agréables. Obtenir vite des réponses plaisantes et souvent justes, c’est rafraîchissant dans une journée chargée — et c’est précisément pour cela qu’on relâche sa vigilance.
Externaliser, différer, se rendre
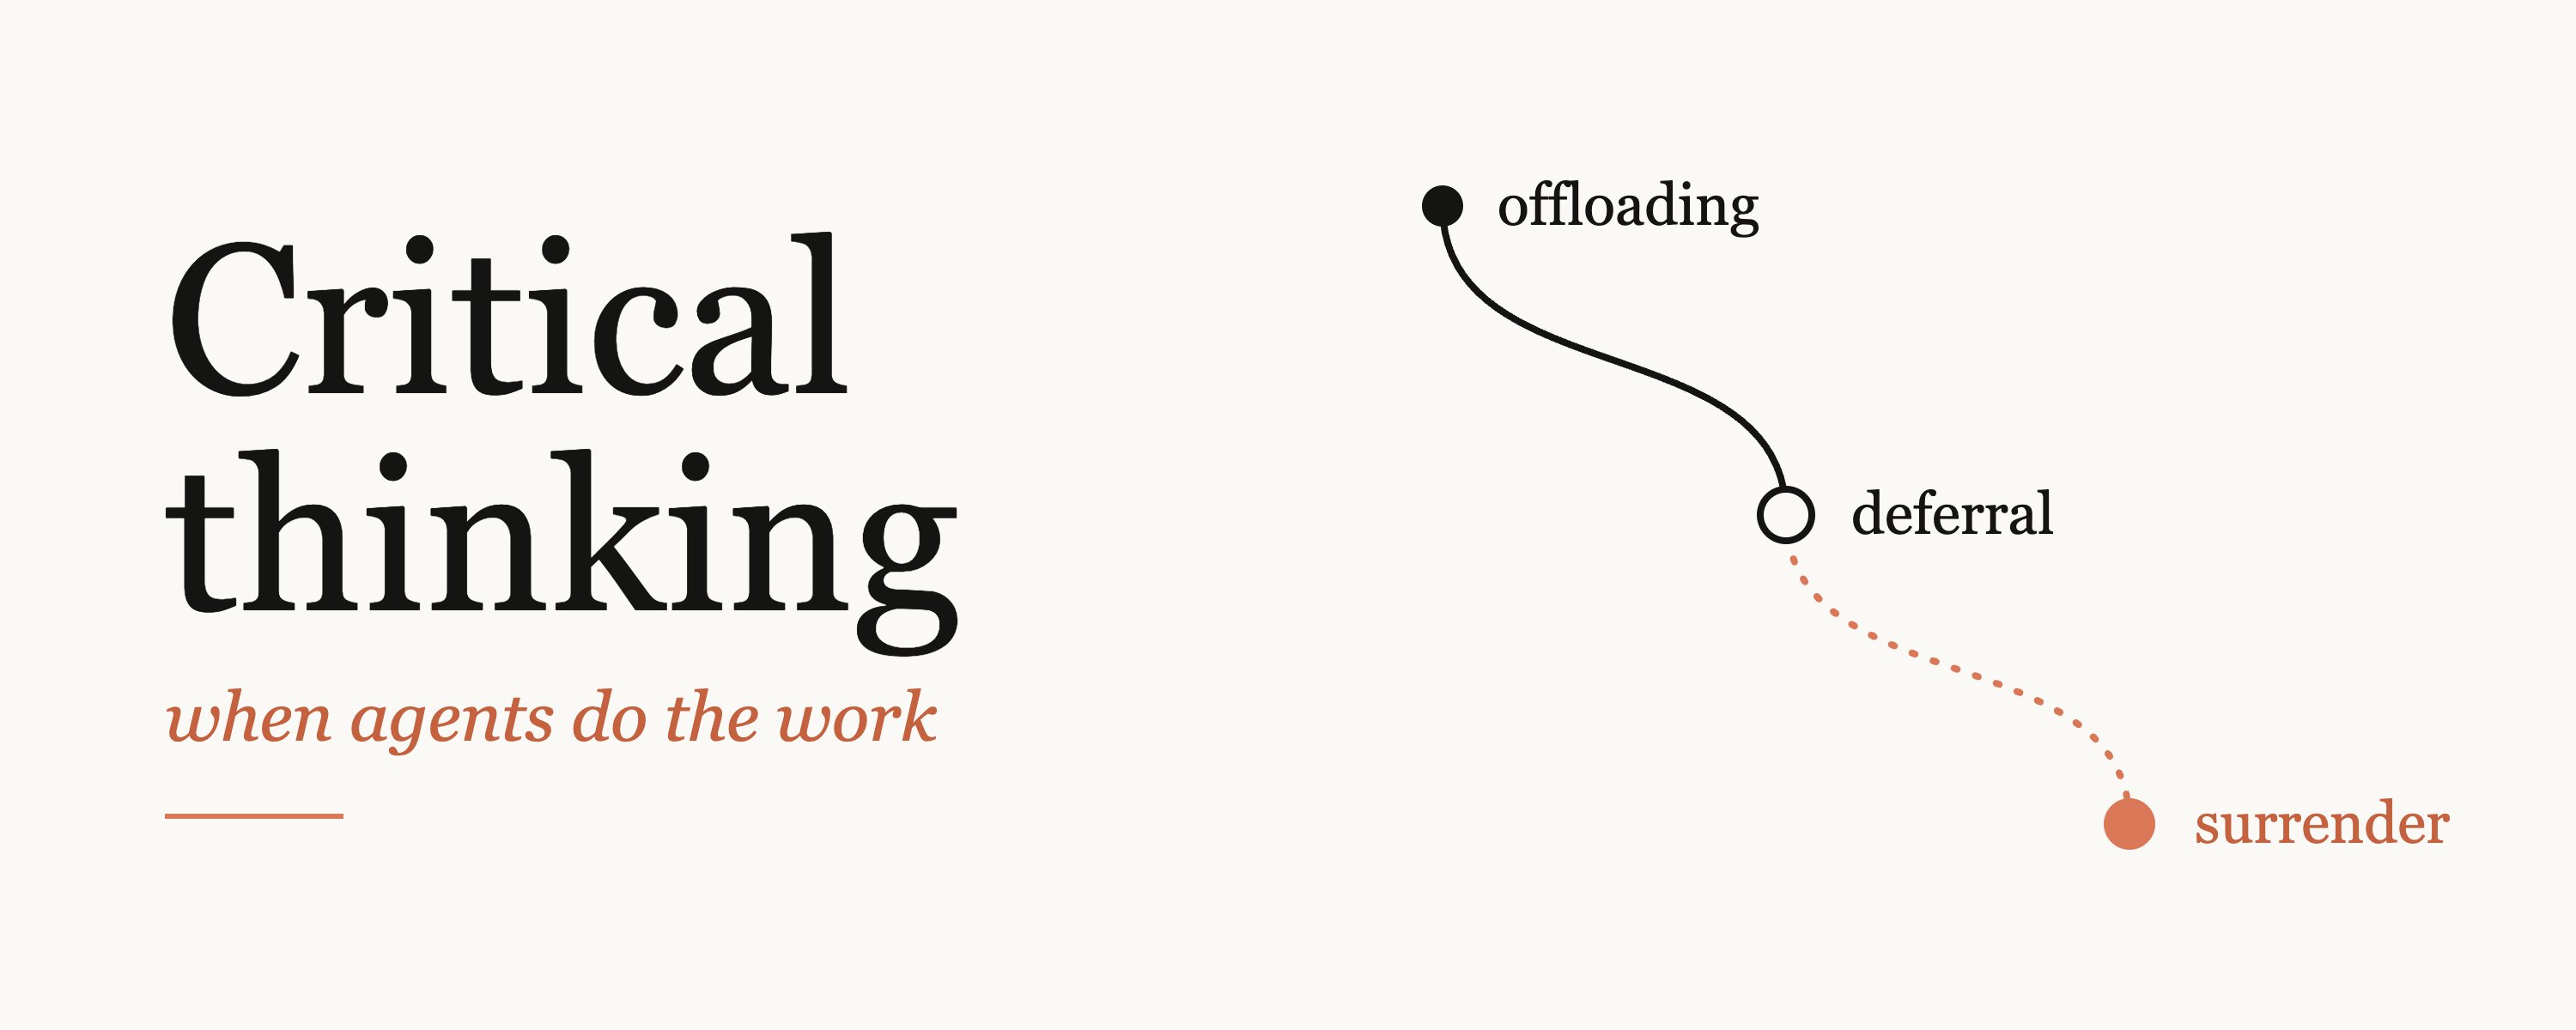
Quand j’en discute autour de moi, je décris cela comme un spectre.
En haut : l’externalisation cognitive (cognitive offloading), qui consiste à déléguer une tâche à l’IA tout en restant propriétaire du résultat. Je le fais toute la journée. Vous devriez aussi. Au milieu : la déférence (deferral), où la sortie de l’outil devient votre nouvelle entrée ; le résultat a cessé d’être une hypothèse. En bas : la reddition cognitive (cognitive surrender) — la sortie de l’IA devient discrètement la vôtre, et vous ne ressentez plus le besoin de la vérifier.
Le terme de reddition cognitive a été forgé par Steven Shaw et Gideon Nave, à Wharton. Il colle parfaitement à ce que j’observe : à mesure que la confiance (ou la paresse) augmente, les gens glissent vers le bas du spectre. La transition est rarement visible, parce que chaque pas est progressif et paraît raisonnable. Vous lisez bien la dernière réponse, alors vous survolez la suivante. Puis vous ne faites plus que parcourir la structure de celle d’après. Et le jour où on vous interroge sur une ligne, vous êtes incapable de l’expliquer — même avec l’aide de votre agent.
C’est la reddition cognitive. C’est ainsi que s’accumule la dette cognitive. On la découvre généralement au moment où l’on essaie d’appliquer un modèle mental du système… et qu’il n’existe pas. Margaret-Anne Storey a décrit comment cela se manifeste dans les équipes : une compréhension partagée du système qui s’érode. J’ai écrit sur l’équivalent dans le code, la comprehension debt (une expression de Jeremy Twei). Sur le moment, c’est totalement invisible. Le dépôt est impeccable et les tests passent. Cela ne devient évident qu’au moment de modifier le système et de réaliser que plus personne ne le comprend. La même chose vaut quand vous avez lu la table des matières d’un document de stratégie ou d’une spec, et signé.
Soyons clairs : je ne plaide pas pour l’impossible. Maintenir le modèle mental complet d’une grosse base de code moderne est hors de portée. L’équipe Claude Code dit publiquement qu’elle reconstruit la compréhension à la demande : quand elle a besoin de comprendre une partie, elle demande à Claude d’expliquer cette tranche, plutôt que de garder tout le modèle en tête. Comme je l’ai déjà écrit, ce type de dette est plus récupérable que la plupart des ingénieurs ne l’imaginent. Vous n’avez pas besoin de maintenir le modèle complet tant que vous pouvez le reconstruire localement au besoin. Il suffit de savoir ce que vous ne savez pas.
Là où les enjeux sont faibles, déléguez entièrement, sans remords. Mais quand vous ne pouvez pas expliquer une réponse à une question, même par le relais de votre agent, vous avez cédé la propriété du résultat.
Ce n’est d’ailleurs pas toujours un problème. Récemment, j’enregistrais un cours et je devais choisir l’un de trois hôtels à peu près équivalents comme lieu de tournage. Je n’avais pas le temps d’éplucher les avis, j’ai délégué la décision à une IA. Ça a marché, et je recommencerais. En revanche, je ne ferais pas ça pour décider comment investir notre argent, conseiller nos enfants sur leur carrière, ni au travail pour trancher ce qu’on doit construire, quels changements affectent quels utilisateurs, ou s’il est raisonnable de livrer. Prenez la délégation là où se tromper coûte peu ; gardez le raisonnement là où d’autres auront à vivre avec les conséquences.
Les questions que je me pose
Quand je ne savais pas ce que je pensais, je revenais à une liste de questions basiques : comment savoir que je travaille sur le bon problème ? Comment savoir que je le résous de la bonne manière ? Y a-t-il des preuves qui appuient ma conclusion ? Comment savoir que j’ai terminé ? La plupart du temps, cela se résume à qui, quoi, où, pourquoi, quand et comment. Écrit noir sur blanc, ça a l’air absurdement puéril, mais cela force à raisonner dans des catégories qu’on ignorerait autrement. Aujourd’hui, il est trop facile de sauter tout ça et de demander directement à son agent ce qu’il en pense. Voici les nouvelles versions de ces questions, celles que je me pose désormais.
Ai-je formulé une hypothèse avant de demander ? Avant de lancer un agent sur une tâche non triviale, j’écris — même juste dans ma tête — ce que je crois être la réponse. Ce n’est pas grave si la supposition est mauvaise : on a toujours le droit de changer d’avis devant de nouvelles informations. Mais une fois qu’on a lu une réponse bien tournée, il devient difficile d’imaginer une autre possibilité. Si vous n’avez aucune intuition, demandez ce que Thariq Shihipar appelle un blind spot pass : donnez au modèle ce que vous savez et laissez-le trouver vos inconnues inconnues.
Est-ce que je lui demande de m’aider à penser, ou de penser à ma place ? Les deux sont acceptables, à condition de savoir laquelle des deux vous faites.
Que faudrait-il pour que ce soit faux ? Allez vérifier ensuite. L’auto-évaluation de la confiance d’un modèle vaut bien moins qu’un test réel que vous pouvez exécuter : donnez-lui ce test.
Ai-je entendu l’argument contraire sous un autre angle ? Quand j’ai pris position sur un sujet un peu ouvert, je demande à plusieurs modèles de défendre la thèse opposée, puis je relis et je me forme mon opinion. C’est plus long, mais j’en sors en sachant bien plus.
Parierais-je là-dessus devant la personne qui devra maintenir le code ? Cela vaut pour le code et pour tout ce que vous livrez. Je crois que c’est le seuil de la responsabilité assumée.
Qu’est-ce que je ne pratique plus ? Peut-être une partie du débogage de routine. Ça me va d’en lâcher une partie, mais je veux que ce soit un choix conscient.
La vérification comme habitude
J’écris beaucoup sur la vérification, parce que je crois que le goulot d’étranglement s’est déplacé de l’écriture du code vers la certitude d’avoir raison. Quand vous donnez à un agent les moyens de vérifier ce qu’il fait — tests de bout en bout, tests basés sur des propriétés, interactions réelles avec l’application — il peut modifier, lancer la vérification, lire la sortie et réessayer avant même que vous ayez regardé quoi que ce soit. C’est ce que Boris Cherny résume par « donner à Claude un moyen de vérifier son travail », et je crois que c’est l’un des éléments les plus déterminants pour obtenir de bons résultats. Plutôt que de lire chaque ligne, vous construisez ces boucles et vous examinez les preuves.
Mais on peut aussi rendre la vérification. « Y a-t-il des preuves qui appuient ma conclusion ? » devient « est-ce que la coche est verte ? ». Les agents rendent la création de tests si peu coûteuse qu’on verra beaucoup de vert — et un test peut parfaitement passer sans attraper une fonctionnalité cassée. Si le test est écrit avec la même erreur que la fonctionnalité, il passera. Et une coche verte ne dit qu’une seule propriété. On imagine trop facilement qu’elle couvre tout.
Quand une coche passe au vert, demandez ce qu’elle a prouvé. Puis demandez ce qu’elle n’a pas prouvé.
Définissez « vérifié » à l’avance, parce qu’après coup vous rationaliserez n’importe quel résultat.
La ligne d’arrivée d’un travail d’agent doit être tangible : un test qui passe, une capture d’écran, un log ou une trace. Cela garantit que le critère de fin est factuel et non sujet à interprétation (ni à reddition) du genre « on dirait que c’est fini ». Quand vous recevez une notification de fin, avant de lire le résumé, examinez d’abord la commande exécutée et sa sortie.
Claude Code sait aussi s’autocritiquer (via un sous-agent dans un contexte neuf) pour se donner un contrôle de cohérence : cela vaut la peine de l’intégrer à la boucle pour qu’il tourne à chaque fois, pas seulement quand vous y pensez. Je demande quand même à la fin : « J’ai oublié quelque chose ? » Ça paraît bête, mais très souvent, après avoir terminé une fonctionnalité complexe avec un modèle de pointe, je la regarde, je la relis, puis je pose la question — et il revient avec deux ou trois éléments de plus. C’est pour ça que je la pose toujours.
Rien de tout cela n’a besoin d’être la norme : savoir quand creuser est une compétence. Ma règle préférée, tirée de notre article sur la façon dont l’équipe Claude Code fait la revue de code : « Si vous ne pouvez pas dire ce que les vérifications laisseraient passer, demandez une vraie revue plutôt qu’une approbation rapide. »
Cela vaut au-delà du code. Si un agent a synthétisé cinquante appels clients, ou une analyse concurrentielle, ouvrez deux ou trois documents sources pour vérifier que le résumé est exact. Vérifiez un chiffre dont dépend votre recommandation, pour vous assurer qu’il est correctement calculé.
Les agents ont rendu la vérification peu coûteuse à mettre en place. Ce qui reste difficile, c’est de savoir à quoi ressemble une bonne vérification.
Regarder vraiment ce qui est produit
Imaginez qu’un agent vous rende une PR de 600 lignes. Vous survolez la structure. Vous ne lisez pas chaque ligne. Les noms de variables semblent raisonnables et les tests passent, donc vous approuvez. Mais quelque part au milieu, il y a un subtil changement d’ordre dans une frontière de transaction, ou une valeur par défaut inversée sur un cas limite auquel vous n’aviez jamais pensé. Vous l’avez relue, disons, mais seulement pour ce que vous saviez déjà y trouver.
Écrire du code et le relire sont deux compétences distinctes, et il arrive un point où la relecture devient un tampon encreur. Alors lisez le diff comme si l’IA ne l’avait pas écrit, puis regardez au-delà du diff ce que l’agent a décidé. Sur une longue session, il prend beaucoup de petites décisions pour vous : les valeurs par défaut, ce qui sort du périmètre, quelle exigence il réinterprète quand deux d’entre elles entrent en conflit.
Vous ne verrez rien de tout cela dans un résumé qui dit que tout s’est bien passé. Demandez-lui donc la liste des décisions et des hypothèses qu’il a prises. Puis interrogez-vous. Prenez quelques lignes au hasard : et celle-là, pourquoi ? Pour un document, fermez-le et essayez de réécrire l’argument principal de mémoire. Certains ont une habitude que j’aime pour les longues sessions : faire écrire à Claude un rapport sur le changement, avec un quiz à la fin, et se fixer la règle « je ne fusionne qu’après avoir réussi le quiz sans faute ».
Comprenez ce que vous livrez assez bien pour le défendre. Parce qu’à un moment, quelqu’un pourrait vous poser la question.
Les agents peuvent aussi protéger votre attention. Par exemple, j’ai un projet open source qui reçoit beaucoup de pull requests. J’utilise des agents pour déterminer ce qui arrive, ce qui contrevient à nos règles, et où mon attention est probablement requise. Je les laisse rarement trancher seuls, mais ils peuvent réduire le champ à l’endroit où je dois regarder — et là, je peux vraiment réfléchir à si ces changements résolvent le bon problème de la bonne manière.
Reste le volume, et il faut être honnête avec soi-même. J’ai appelé cela la taxe d’orchestration : l’écart entre ce que vos agents produisent et ce que vous seriez à l’aise de signer de votre nom. Si le travail fini s’accumule plus vite que vous ne pouvez l’absorber, une session de plus n’aidera pas tant que ce n’est pas réglé : resserrez les contrôles pour qu’il en reste moins à valider, ou ralentissez.
Quand vous produisez plus que ce que vous pouvez assumer, vous ne relisez plus. Vous espérez.
Qualité en entrée, qualité en sortie
Le modèle mental humain reste dans la boucle, mais il n’est plus au milieu : il est au début et à la fin. Vous placez votre énergie en amont, dans la description de la tâche et le contexte, et en aval, dans la relecture de la sortie. C’est pourquoi une bonne entrée est si déterminante pour la qualité de la sortie — et je considère le bon prompt comme une compétence d’esprit critique.
Autrefois, si vous formuliez une demande floue, quelqu’un vous reprenait, et vous réalisiez : « Ah, en fait je n’avais pas vraiment réfléchi. » Un agent, lui, ne vous arrête généralement pas. Il comble ce que vous avez laissé vide et rend quelque chose qui a l’air fini, même si l’idée derrière reste floue. J’ai écrit là-dessus sous le nom de dette d’intention : les objectifs implicites, les contraintes et les raisons qui se trouvent dans des artefacts que vous n’avez pas écrits. Contrairement aux autres dettes, personne ne peut la rembourser à votre place. L’intention doit venir de vous.
Votre prompt est le reflet de votre compréhension du problème. Et si vous ne pouvez pas l’exprimer clairement, c’est peut-être qu’il n’est pas clair dans votre tête.
Rédigez votre propre brief, avec vos mots, avant de demander de l’aide. Décrivez le public, ce qui est hors périmètre, et la définition de « terminé ». Quand votre deuxième série de corrections n’y arrive toujours pas, arrêtez d’ajuster : réécrivez le prompt.
Vous pouvez aussi vous faire aider par l’agent. J’aime la distinction d’Andy Clark entre déléguer à un système d’IA et collaborer avec lui. Dans le second cas, vous êtes dans un cercle vertueux d’amplification mutuelle : vos prompts affinent votre sortie, qui affine le prompt suivant, qui affine votre modèle mental du problème. Si ce n’est pas clair, demandez à l’agent de vous interviewer sur ce qu’il ne comprend pas. Si vous fermez la session en ayant affiné votre propre modèle mental, c’est un signe de réussite.
Attention aussi à l’entrée. Il est facile pour chaque agent de transmettre simplement le résumé de l’agent précédent à son contexte — et bientôt, le troisième n’a jamais lu le document d’origine.
Il vous faut aussi vos propres critères de sortie. J’ai joué avec l’IA dans beaucoup de médiums créatifs, et la plupart du temps ça ne sort jamais, parce que ça ne passe pas mon seuil. Tout arrive bien formaté et sûr de lui, donc le poli n’est plus un signal utile.
L’IA a peut-être accéléré la production, mais si je ne serais pas à l’aise de m’attribuer la sortie, je ne la publie pas.
Quand quelque chose ne passe pas votre seuil, notez pourquoi dans une config partagée, un hook ou un test, pour que ça ne se reproduise pas. C’est comme ça que le goût se capitalise — et noter pourquoi une chose n’a pas passé le filtre est déjà une bonne pratique en soi.
« Mais les modèles seront meilleurs que moi à ça »
Si vous êtes aussi optimiste que beaucoup de gens autour de moi sur l’avenir de ce domaine, vous avez probablement eu cette pensée depuis deux sections. Dans un an ou deux, le modèle détectera ce que je détecterais, alors pourquoi entretenir la compétence ?
Vous avez sans doute raison sur une bonne partie de cette détection, et je plaide moi-même pour la déporter de plus en plus vers les agents. Mais voici pourquoi cela compte encore : au bout du compte, quelqu’un est responsable de ce qui est livré. Peu importe l’aide de l’IA, un humain doit assumer.
La question de savoir à quel point faire confiance à un agent pour une tâche donnée est elle-même un jugement. Rester calibré passe par la relecture, parce que ce que les modèles ratent change en permanence. La recherche d’Anthropic sur ses propres ingénieurs et chercheurs nomme ce piège le paradoxe de la supervision : « superviser Claude exige précisément les compétences de codage qui risquent de s’atrophier à force d’utiliser l’IA. »
Voilà quelques-unes des choses qui comptent le plus pour moi, et qu’un meilleur modèle ne résoudra pas : qu’est-ce que vous construisez, pourquoi cela en vaut-il la peine, qui cela impacte, et à quoi êtes-vous prêt à renoncer ? Ce sont des questions auxquelles vous devez répondre. Un agent peut vous aider à les travailler, et j’aimerais qu’il le fasse, mais elles restent les vôtres.
Vous pouvez déléguer le travail, et une bonne partie de l’audit. Pas la responsabilité.
Des pratiques pour le quotidien
Rien de tout cela n’a besoin d’être appliqué à la lettre. Prenez ce qui marche pour votre façon de travailler.
Une fois par semaine, écrivez un peu de code sans agent, ou faites une chose réelle qui serait pénible si vous oubliiez comment la faire. (J’ai appelé cela un exercice de calibration, sans aucune intention moralisatrice.) Une fois par mois, notez ce que vous avez cessé de faire et décidez ce que vous acceptez de ne plus faire. Une question d’un vieux billet de blog reste valable : à quel point seriez-vous perdu si l’IA n’existait pas ?
Si quelque chose dépasse votre compréhension, allez l’apprendre. Si, en écrivant, je tombe sur une expression que je n’ai jamais vue, je pourrais chercher une explication en une ligne et l’insérer. Je préfère faire un peu de recherche pour vraiment comprendre, afin de voir où cela s’inscrit.
Bien vérifier la machine est un vrai travail, et prétendre le contraire est exactement comme ça que les équipes finissent par ne plus le faire. Ce n’est pas gratuit : inscrivez-le comme une ligne dans votre planning, et vous le ferez vraiment.
Les compétences que vous cessez d’exercer finiront par disparaître, probablement plus vite que vous ne le pensez. Continuez à pratiquer celles que vous n’êtes pas prêt à lâcher.
Ce qu’il faut emporter
- Soyez intentionnel. Un agent peut vous interroger, vous interviewer et vous montrer ses preuves, mais seulement si vous l’avez prévu. Alors prévoyez-le.
- Soyez honnête sur votre position dans le spectre. Si vous ne pouvez pas expliquer la réponse, même avec l’aide d’un agent, vous l’avez rendue.
- Ayez une hypothèse. Formulez-la avant de demander, même si elle est mauvaise.
- Une coche verte ne dit qu’une chose. Qu’a-t-elle vérifié ? Qu’a-t-elle laissé de côté ?
- Cherchez les preuves. Lisez ce qui a été exécuté et ce qui est revenu avant de lire le résumé.
- Lisez pour savoir quelles décisions ont été prises. Qu’est-ce qu’il a décidé pour vous ?
- Travaillez votre prompt. La façon dont vous formulez votre demande montre à quel point vous avez compris le problème.
- Fixez un seuil, et tenez-le. Si vous ne signeriez pas de votre nom, ça ne sort pas.
Restez dans le jeu en exerçant manuellement les compétences qui comptent. Une chose que vous pouvez faire : avant de demander, écrivez ce que vous pensez qu’il va se passer ; une fois l’agent terminé, notez une chose qu’il n’a pas vérifiée. Dites-moi si cela change votre façon de lire les résultats. Pensez par vous-même. Posez de meilleures questions. Assumez la responsabilité du résultat.
Curiosité : l’auteur a fait passer son propre article au détecteur Pangram, qui conclut « écrit par un humain à 90 % ».