Amazon remplace Claude Sonnet par un mini-modèle de décision : −98 % de coûts, et plus précis
Amazon remplace Claude Sonnet par un mini-modèle de décision : −98 % de coûts, et plus précis
Source : undefinedKi (@undefinedKi) — post du 10 novembre 2026 · 5 429 vues, 113 likes, 11 reposts
Article original : « Amazon saves millions by replacing Sonnet 4.6 with Strands Decider » — Carr Onstott, Mehul Jaiswal et l’équipe Strands Agents, 9 novembre 2026
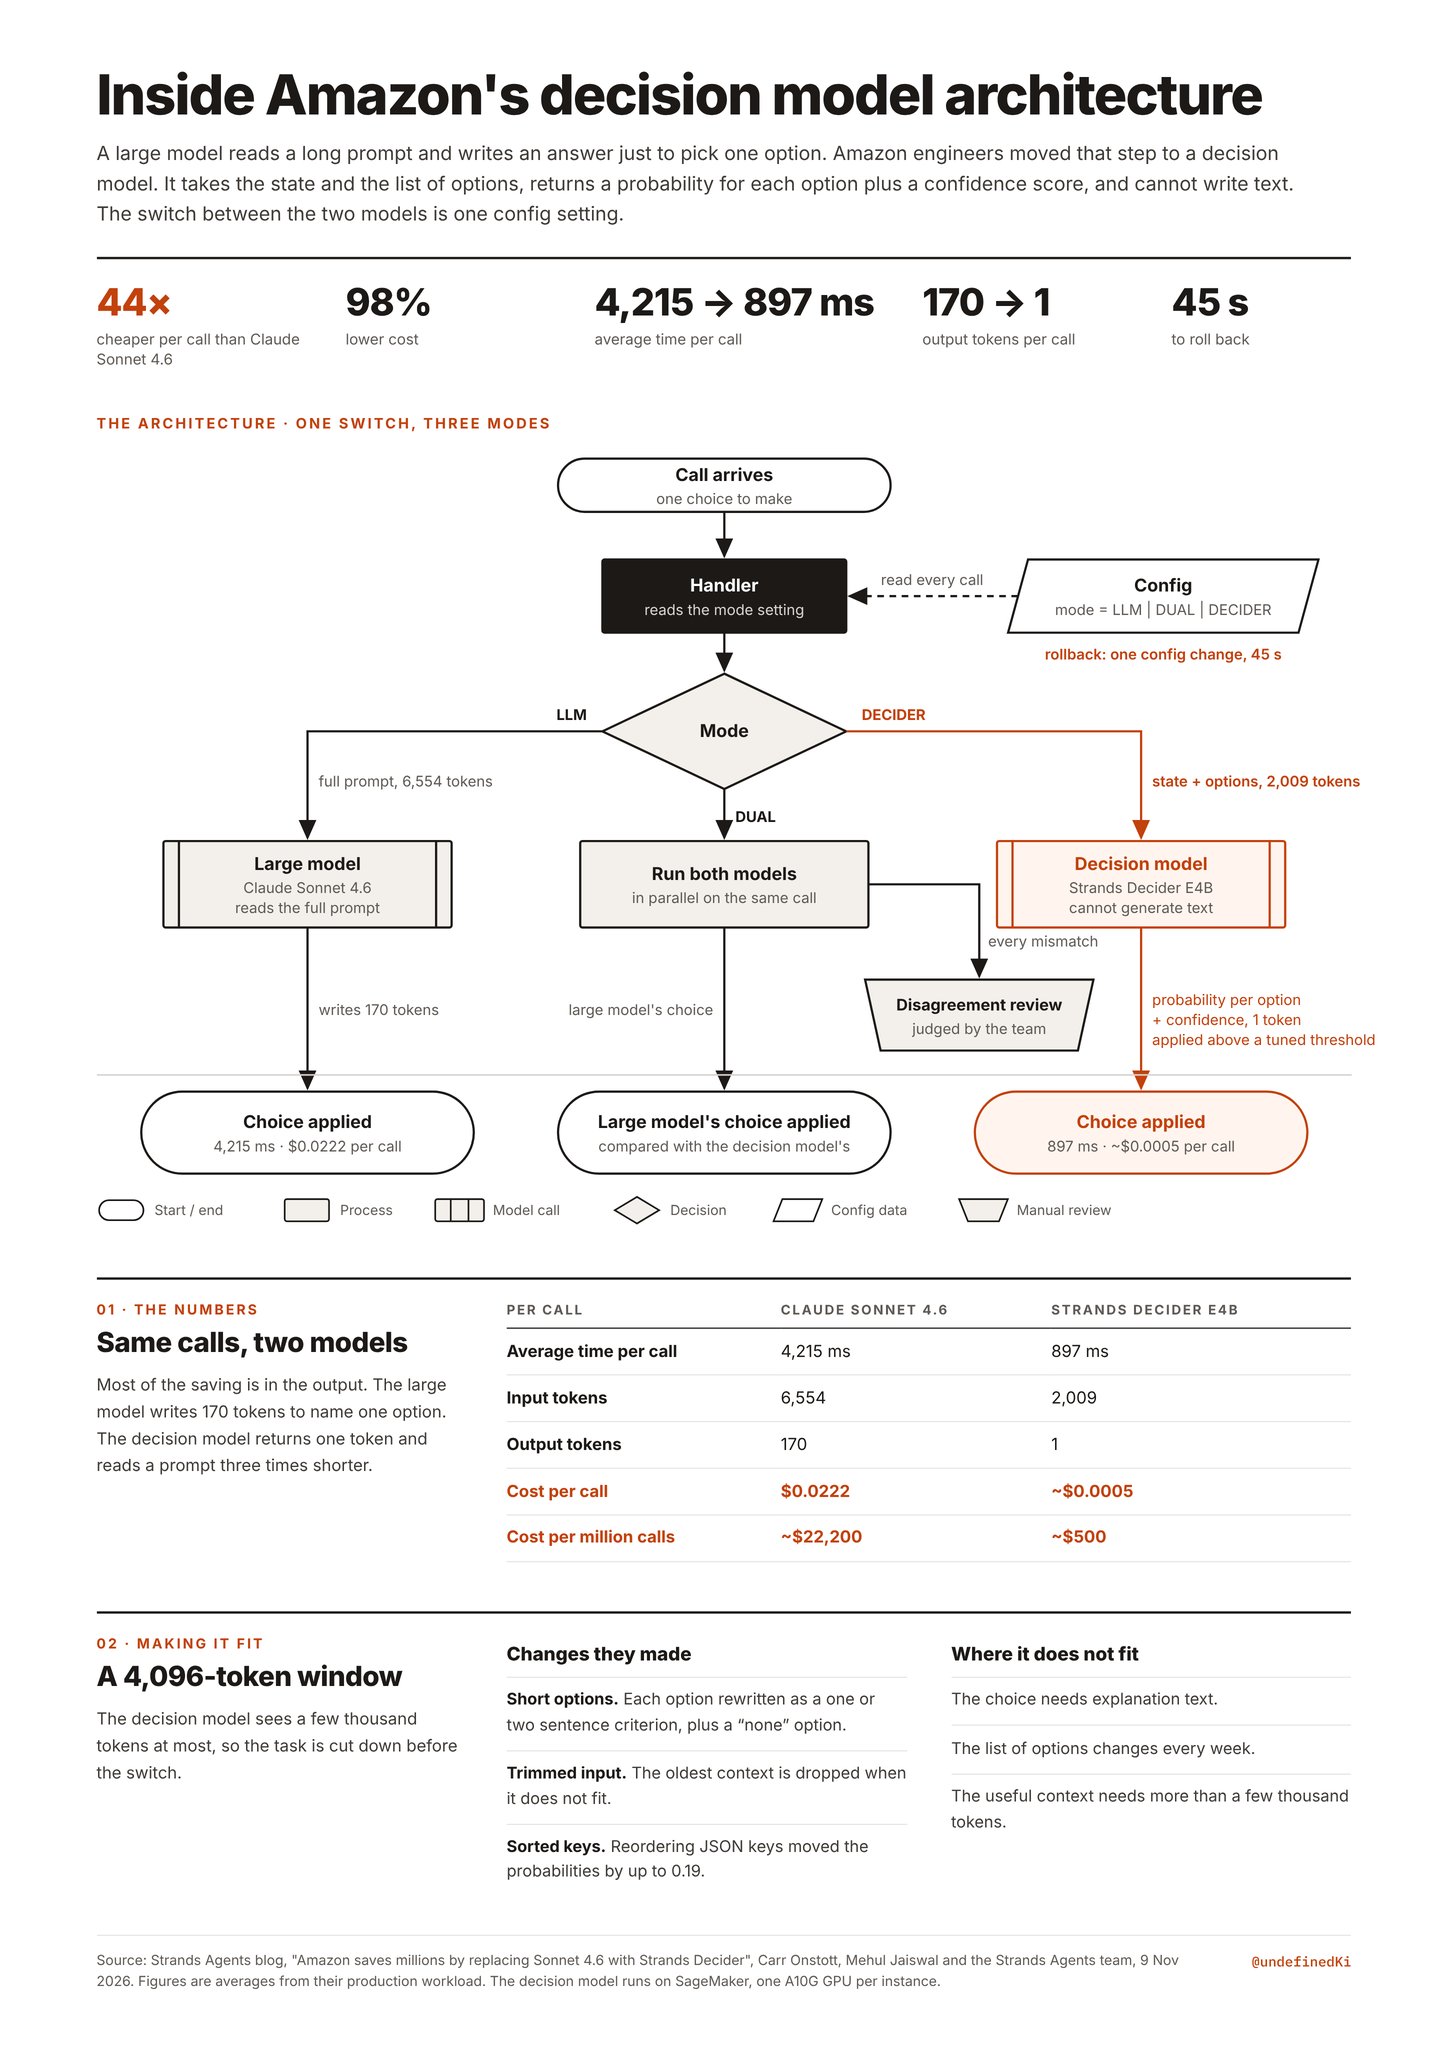
Amazon vient de publier la configuration interne que ses ingénieurs utilisent — celle qui a réduit leurs coûts d’agents de 98 %. L’idée tient en une observation simple, et l’exécution en trois modes.
L’observation : un agent passe son temps à choisir, pas à écrire
La plupart de ce qu’un agent IA fait, ce n’est pas de l’écriture — c’est du choix. Quel outil appeler, où envoyer une requête, quelle option parmi cinq correspond à la situation. Et à chaque fois, un gros modèle comme Claude Sonnet lit un prompt énorme et rédige une longue réponse… pour un seul arbitrage. Le tout facturé au tarif du haut de gamme.
Dans leur workload de production, ça donnait : 6 554 tokens en entrée, 170 tokens en sortie, 4 215 ms et 0,0222 $ par appel — soit environ 22 200 $ par million d’appels — juste pour nommer une option.
La solution : un modèle qui ne sait pas écrire
Ils ont confié chaque choix de ce type à un mini-modèle de décision — Strands Decider E4B, hébergé sur SageMaker avec une GPU A10G par instance. Ce modèle est incapable de générer du texte. On lui donne l’état de la situation et la liste des options ; il rend une probabilité par option plus un score de confiance, appliqué au-dessus d’un seuil réglé. Un seul token en sortie.
Résultat par appel : 2 009 tokens en entrée, 1 token en sortie, 897 ms, environ 0,0005 $ — ~500 $ par million d’appels. Soit 4× plus rapide, 44× moins cher que Sonnet 4.6 sur les mêmes appels… et plus précis que lui.
La bascule : les deux modèles en parallèle, rollback en 45 s
Le mouvement malin est la façon dont ils ont switché. Pas de grand soir, pas de prière : les trois modes vivent dans une seule clé de config (mode = LLM | DUAL | DECIDER), lue à chaque appel.
- LLM — le gros modèle lit le prompt complet et décide, comme avant.
- DUAL — les deux modèles tournent en parallèle sur le même appel ; le choix du gros modèle est appliqué, mais chaque désaccord avec le decision model part en revue manuelle jugée par l’équipe. C’est là qu’ils ont appris qui avait raison.
- DECIDER — le mini-modèle décide seul, au-dessus du seuil de confiance.
Revenir à Sonnet à tout moment ? Un changement de config, 45 secondes. C’est cette porte de sortie bon marché qui rend l’expérience acceptable — et c’est sans doute la leçon la plus transposable.
Ce qu’il a fallu adapter : la fenêtre de 4 096 tokens
Le decision model ne voit que quelques milliers de tokens au maximum, donc la tâche a été taillée avant le switch :
- Options raccourcies : chaque option réécrite comme un critère d’une ou deux phrases, plus une option « none ».
- Entrée rognée : le contexte le plus ancien est jeté quand ça ne tient pas.
- Clés JSON triées : détail savoureux — réordonner les clés du JSON d’entrée a déplacé les probabilités de sortie jusqu’à 0,19. Même un modèle de décision reste sensible à l’ordre des tokens.
Les limites, assumées
Le dispositif ne colle pas quand :
- le choix nécessite un texte d’explication ;
- la liste d’options change chaque semaine (le critère doit être stable) ;
- le contexte utile dépasse quelques milliers de tokens.
Autrement dit : tout ce qui demande de la vraie écriture ou de l’explication reste au gros modèle. Amazon n’a pas remplacé Sonnet — il lui a retiré exactement les appels où il était du gâchis.
Conclusion : router les décisions, pas seulement les tâches
La leçon dépasse Amazon. Un agent, c’est un mélange de jugement coûteux et d’arbitrages mécaniques, et la facturation actuelle ne fait pas la différence. Détacher les choix dans un modèle dédié — incapable d’écrire, donc incapable de partir en digression — c’est le même réflexe que le model routing par nœud dans un graphe d’agents : dépenser les tokens chers là où le jugement vit, et un token unique là où il ne vit pas.
Note de veille : le chiffre à retenir n’est pas le −98 %, c’est le 45 s de rollback. C’est parce que revenir en arrière ne coûte rien que l’équipe a pu mesurer les désaccords sur du trafic réel au lieu de débattre dans le vide. À lire en complément : le graph engineering avec Claude — l’étape 12, « étagez les modèles entre les nœuds », décrit exactement ce type de routage.