Graph engineering avec Claude : la feuille de route en 14 étapes de l'agent linéaire à l'architecte de graphes
Graph engineering avec Claude : la feuille de route en 14 étapes de l’agent linéaire à l’architecte de graphes
Source : Codez (@0xCodez) — post du 20 juillet 2026 · 7 770 823 vues, 4 627 likes, 795 reposts, 15 492 bookmarks
Article long-form original : « Graph Engineering with Claude: 14-Step roadmap from 0 to graph architect (Full Course) » — x.com/i/article/2079141496981184512
La plupart des gens qui construisent un agent multi-étapes aboutissent à une ligne droite. Étape un, étape deux, étape trois — chacune attendant poliment la fin de la précédente. Et la moitié de ces étapes n’auraient jamais eu besoin d’attendre : elles ne routent rien, ne branchent rien, ne parallélisent rien. Elles enchaînent — une tête, un contexte, une chose à la fois — jusqu’à ce que la fenêtre se remplisse et que l’agent oublie ce qu’il faisait.
Le décalage que personne n’exprime clairement : un prompt est une phrase, une boucle est un cycle, un harness est le plancher sur lequel l’agent se tient. Mais la forme du travail lui-même — ce qui tourne avant quoi, ce qui peut tourner en même temps, ce qui doit attendre tout le reste — cette forme est un graphe. Les nœuds font le raisonnement, les arêtes transportent les résultats.
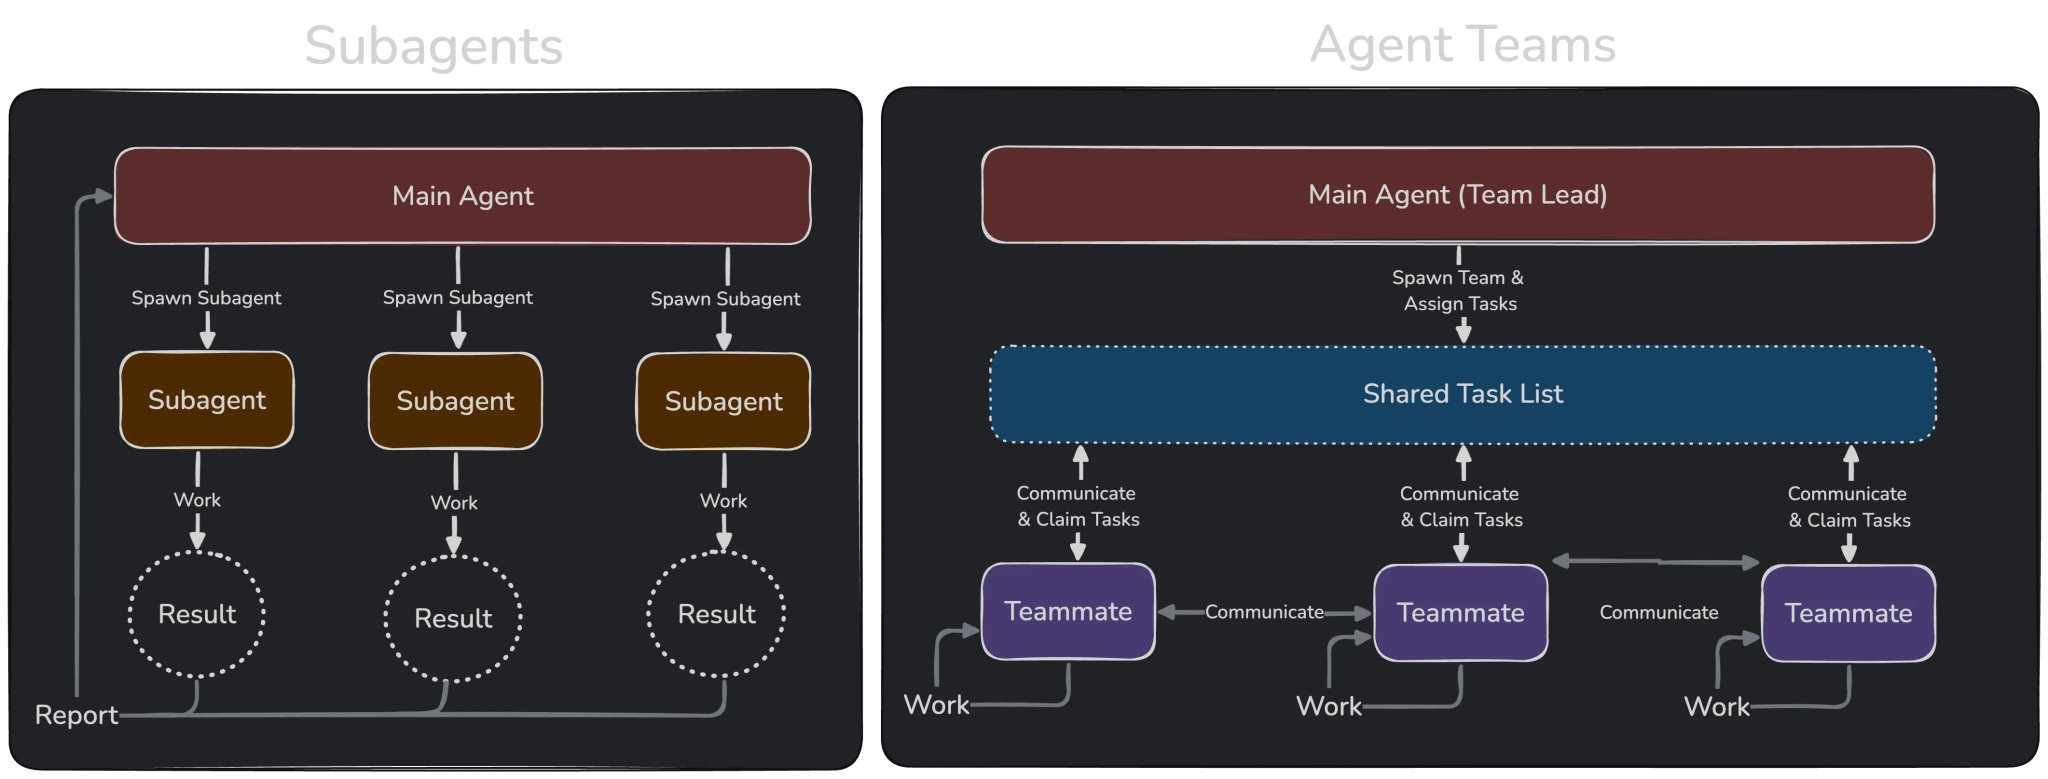
Et Claude Code a livré l’outillage pour construire ces graphes directement : les workflows dynamiques. Claude écrit un script d’orchestration en JavaScript, puis déploie une flotte coordonnée de subagents pour l’exécuter — et la coordination elle-même ne coûte zéro token de modèle, parce que c’est du code, pas une conversation.
Voici les 14 étapes de la feuille de route, résumées.
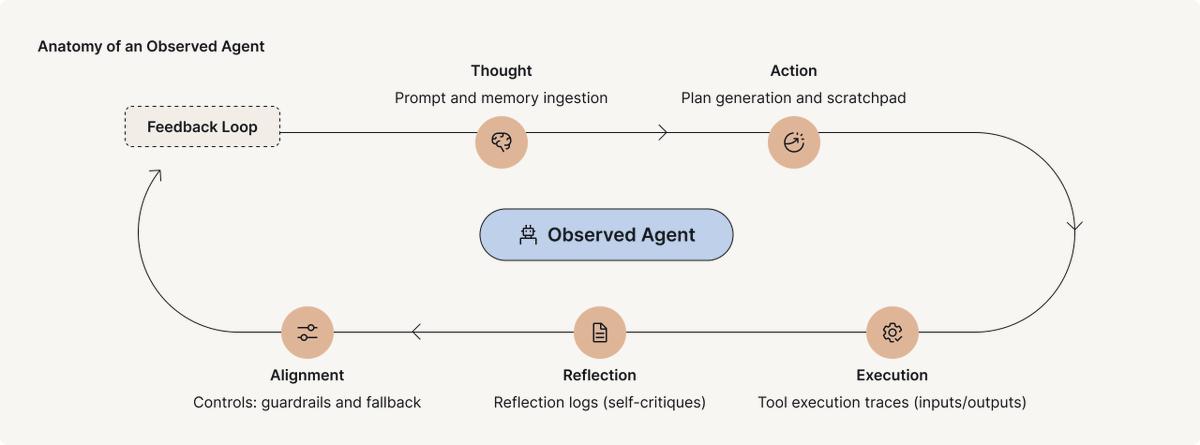
01. Les nœuds sont des jobs, les arêtes sont ce qui circule
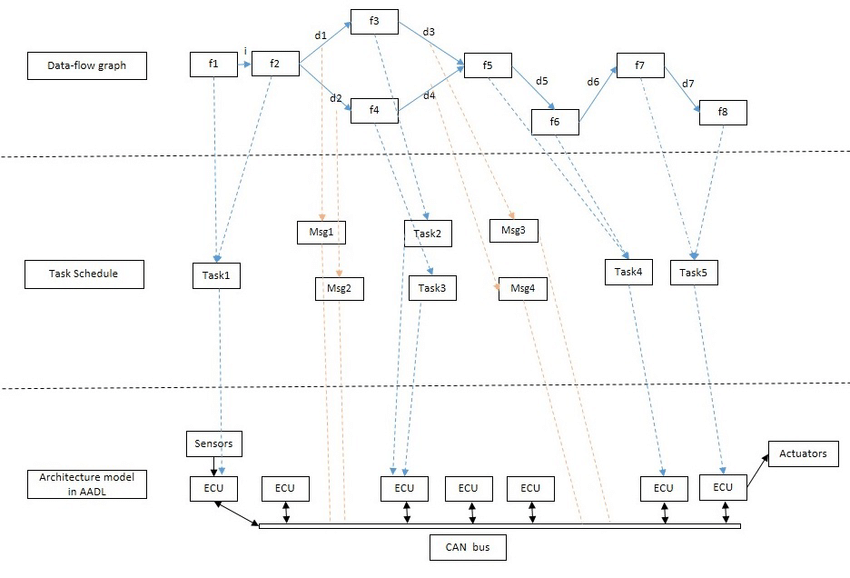
Un graphe n’a que deux choses, et les distinguer règle la plupart des confusions. Un nœud est une unité de travail — un agent, un job borné, une entrée et une sortie. Une arête est une dépendance : la sortie de ce nœud alimente l’entrée de tel autre. Rien de plus.
L’erreur classique est de traiter « et puis » comme une arête. « Résume le fichier et dis-moi la météo » n’a aucune arête entre les deux — la météo ne consomme pas le résumé. La question à poser à chaque « et puis » de votre agent : l’étape suivante lit-elle la sortie de la précédente ? Si non, il n’y a pas d’arête, et l’attente est du temps perdu.
02. Votre script linéaire est un graphe dégénéré
Écrire un agent en « fais A, puis B, puis C, puis D », c’est déjà dessiner un graphe — une chaîne sans branchement, un seul edge entrant et sortant par nœud. Elle fonctionne. Elle est aussi lente et fragile : si C bloque, D n’arrive jamais, et le travail de A reste prisonnier en amont.
Le premier vrai savoir-faire du graph engineering : redessiner la chaîne. Pour chaque flèche, poser la question de l’étape 1. La plupart des chaînes ont deux ou trois flèches qui ne transportent aucune donnée — c’était juste l’ordre dans lequel on a tapé les choses. Coupez-les : la chaîne s’aplatit en quelques nœuds indépendants qui peuvent tous tourner à la fois, alimentant un nœud unique qui a besoin de tous.
03. Donnez un contrat à chaque nœud
Un nœud qu’on ne peut pas raisonner est un nœud qu’on ne peut pas paralléliser. La solution : un contrat — entrée bornée, sortie bornée, exactement un job. L’entrée est passée explicitement, jamais supposée depuis une fenêtre partagée. La sortie a une forme définie, idéalement validée.
Dans un workflow, ce contrat est appliqué par un schéma : quand on donne à Claude un appel agent() avec un JSON schema, le subagent est forcé de retourner des données structurées validées — la validation a lieu à la couche tool-call, donc Claude réessaie en cas d’écart au lieu de livrer du texte libre à parser en priant.
04. Traitez l’arête comme un contrat de données
Une arête n’est pas « B vient après A », c’est une promesse sur ce qui traverse : A produit cette forme, B est construit pour consommer cette forme. Nommer l’arête par ses données permet de voir d’un coup d’œil si elle est réelle, et d’échanger un nœud sans casser le graphe tant que la forme tient.
En pratique, l’arête vit en JavaScript brut : l’étape de réduction entre fan-out et synthèse — aplatissement, dédoublonnage, filtrage — c’est juste du code sur les formes retournées. Aucun agent nécessaire. Un des gains silencieux du raisonnement en graphe : une énorme quantité de ce que les gens brûlent en tokens devrait être une arête, et les arêtes sont gratuites.
05. Déployez en éventail avec parallel()
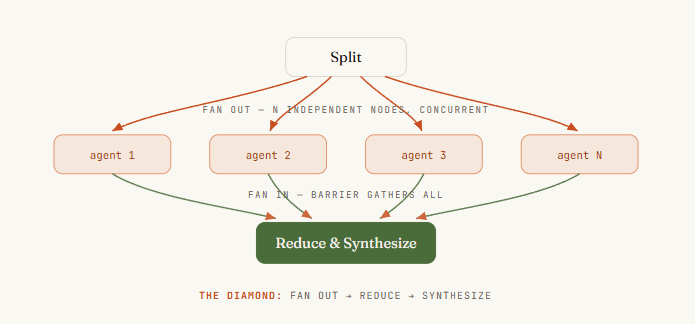
Le mouvement qui paie tout le reste. Quand vous avez N nœuds indépendants — N sources à vérifier, N fichiers à relire — vous ne les enchaînez pas : parallel() prend un tableau de thunks, deploie un subagent par thunk, tous concurrents, et rend le tableau des résultats.
Deux détails le rendent robuste : parallel() est une barrière (il attend tous les thunks avant de rendre la main) et un thunk qui lève une exception résout en null au lieu de faire échouer la fournée — d’où le .filter(Boolean) réflexe. La concurrence est plafonnée autour du nombre de cœurs, le surplus fait la queue : cent thunks finiront tous, simplement par petites poignées.
Surtout : le fan-out vit dans du code écrit par Claude, pas dans une conversation. Le contexte de Claude ne porte jamais neuf sources à la fois — chaque subagent porte les siennes, et seule la réponse finale revient. C’est ce qui permet de monter à des dizaines ou centaines de subagents sans noyer la session.
06. Rassemblez à une barrière (fan-in)
Un fan-out ne sert que si quelque chose le ramasse. Le fan-in est le nœud où les arêtes convergent — un agent (ou du code) voit tous les résultats amont d’un coup et fait quelque chose qui exige l’ensemble : dédoublonner entre sources, classer par impact, sortie anticipée si le total est vide. C’est le seul endroit où une barrière gagne son coût wall-clock.
La règle qui garde les graphes rapides : barrière uniquement quand une étape a réellement besoin de tous les résultats en même temps. Aplatir une liste ? C’est une arête, faites-le en ligne. Le smell test : si vous avez écrit parallel → transformation → parallel et que la transformation du milieu n’a aucune dépendance entre items, il fallait un pipeline() et aucune barrière.
07. Le losange : split → work → merge
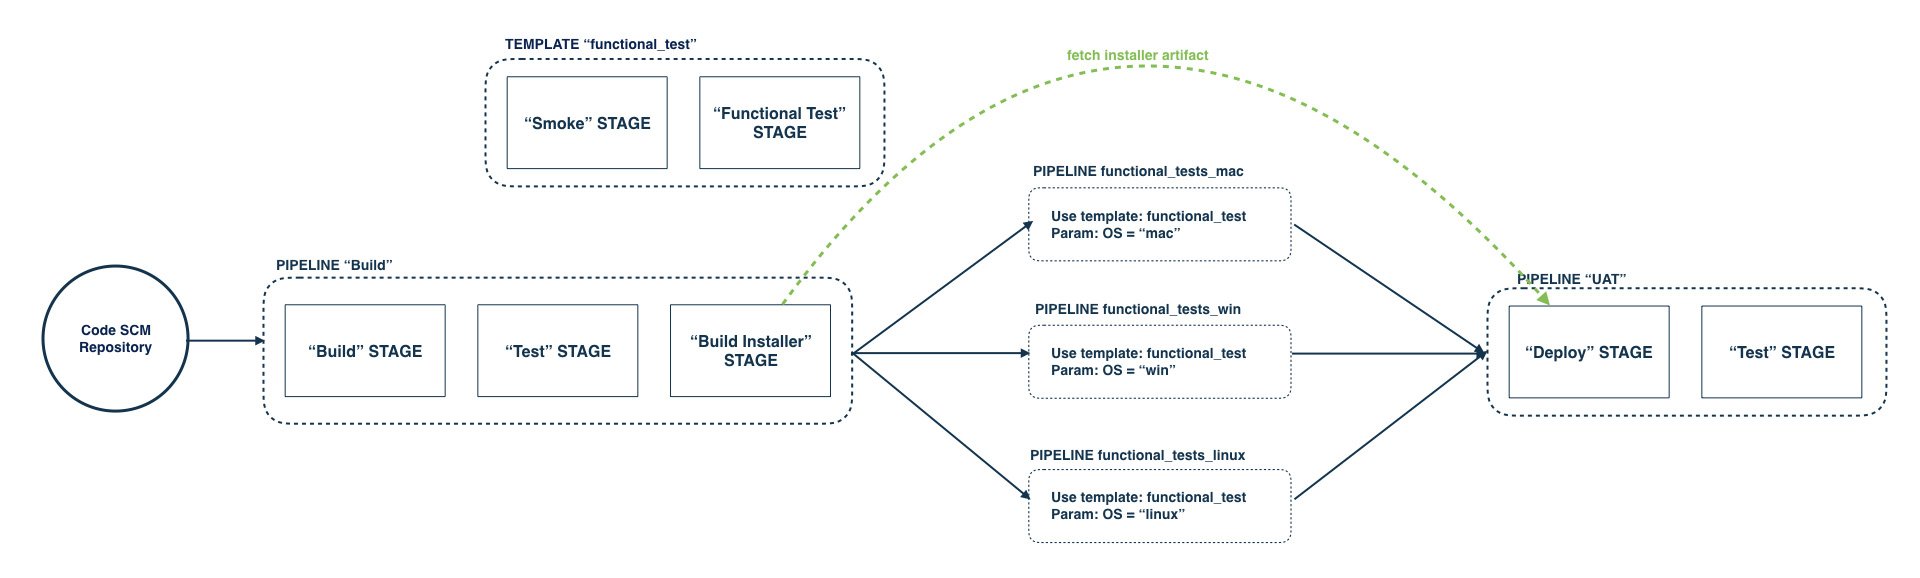
Fan-out + fan-in = la topologie de base de tout graphe d’agent série : le losange. Un nœud découpe, beaucoup travaillent en parallèle, un nœud fusionne. C’est la forme derrière un scan de marché, un audit de dépendances, une revue de code, un rapport de recherche — on change les sources et les prompts, le squelette s’adapte.
La forme canonique a un nom à retenir : fan out → reduce → synthesize. Déployer pour la largeur, réduire avec du code brut pour compresser, synthétiser avec un agent final pour écrire la réponse.
08. Routez l’arête à l’exécution avec une condition
Tous les graphes ne sont pas figés. Un nœud routeur inspecte un résultat et décide quel chemin aval s’active : classifier le ticket puis brancher vers le bon gestionnaire, mesurer la taille du diff puis choisir revue rapide ou audit complet. Dans un workflow, c’est un simple if ou switch JavaScript sur la sortie validée d’un nœud — le flux de contrôle vit dans le code.
C’est là que le déterminisme devient une force : la décision du routeur peut être portée par Claude (un subagent classifie), mais le routage est du code écrit par Claude — il s’exécute pareil à chaque fois. On a le jugement de Claude au nœud et la fiabilité du script à l’arête. Aucun « Claude a décidé de sauter l’audit » émergent : le saut devrait être écrit dans le graphe, et il ne l’est pas.
09. Mettez un vérificateur sur l’arête
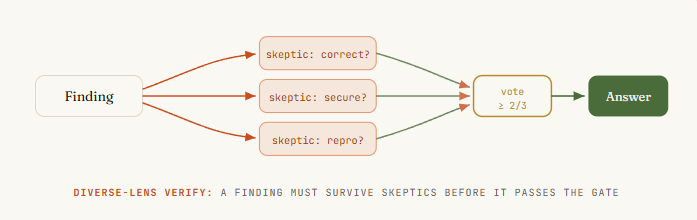
Le vrai levier d’un graphe n’est pas plus d’agents, c’est la structure qu’on peut enrouler autour d’eux pour produire de la confiance. Un nœud vérificateur s’assoit sur l’arête avant qu’un résultat soit autorisé à descendre, et son seul job est d’essayer de tuer la conclusion. S’il survit, il passe. Sinon, il n’atteint jamais la réponse.
Trois patterns à connaître :
- Adversarial verify : pour chaque conclusion, déployer N sceptiques indépendants invités à la réfuter ; ne la garder que si la majorité survit.
- Perspective-diverse verify : donner à chaque vérificateur un angle distinct — correction, sécurité, « est-ce que ça se reproduit » — car la diversité attrape des modes d’échec que N vérifications identiques ne verront jamais.
- Jury (judge panel) : générer N tentatives sous des angles différents, les noter avec des juges en parallèle, synthétiser à partir du gagnant en greffant le meilleur des seconnes.
10. Isolez les nœuds pour qu’un échec ne contamine pas le graphe
Dans une chaîne, l’échec cascase — C meurt, D ne tourne jamais, tout s’arrête. Dans un graphe, l’échec doit rester confiné à son nœud : filter(Boolean) est votre compartimentage, et chaque fan-in doit tolérer des entrées manquantes au lieu de supposer un jeu complet.
L’échec plus subtil : des nœuds qui s’écrasent mutuellement. Quand des agents écrivent des fichiers en parallèle, ils entrent en collision. La solution est l’isolation : chaque agent tourne dans son propre git worktree, travaille en sandbox, et fusionne proprement. À réserver aux nœuds qui écrivent vraiment en parallèle — c’est la ceinture de sécurité de la seule topologie qui en a besoin, pas une taxe par défaut sur chaque run.
11. Ajoutez un cycle — mais faites-le converger
Parfois on ne connaît la taille du job qu’en y étant : découverte de taille inconnue, chasse aux bugs où trouver un bug en révèle trois autres. Il faut alors un cycle — une arête contrôlée vers un nœud amont. Le danger est évident : un cycle qui ne converge pas est une boucle infinie qui déploie des agents jusqu’à épuisement du budget.
Le pattern qui converge : loop-until-dry — continuer à déployer des finders jusqu’à ce que K tours consécutifs ne remontent rien de nouveau, puis s’arrêter. Le détail qui fait tout — et l’erreur que quasiment tout le monde fait au premier essai — est ce contre quoi on dédoublonne : contre tout ce qui a été vu, pas seulement contre les résultats confirmés. Sinon les conclusions rejetées reviennent chaque tour, la boucle ne sèche jamais, et on a construit une machine qui paie pour redécouvrir éternellement les mêmes impasses.
12. Étagez les modèles entre les nœuds
Tous les nœuds n’ont pas besoin du meilleur modèle. Un graphe le rend évident d’une façon qu’un agent seul ne permet pas : certains nœuds sont bornés et répétitifs (extraire un champ, classifier un ticket), d’autres portent le vrai jugement (synthétiser le rapport, arbitrer une conclusion). Faites tourner les nœuds fastidieux sur un modèle moins cher, et dépensez les tokens chers là où le jugement vit.
Dans un workflow, chaque subagent hérite du modèle de session sauf si le script le surcharge — donc par défaut, un gros run est facturé entièrement à votre palier. L’option model sur un appel agent() précis route juste ce nœud ailleurs. Vérifiez /model avant un grand run, routez le fan-out répétitif vers le bas et gardez le nœud de fusion en haut : c’est le levier qui rend un graphe gourmand économique sans toucher à sa forme.
13. La topologie, c’est votre coût et votre latence
La forme du graphe n’est pas cosmétique — c’est le premier levier sur le temps wall-clock. Le choix qui piège tout le monde : parallel() contre pipeline(). La barrière de parallel() fait tout attendre le nœud le plus lent avant l’étape suivante. pipeline() fait circuler chaque item à travers toutes les étapes indépendamment, sans barrière — l’item A peut être à l’étape 3 pendant que B est encore à l’étape 1.
Par défaut : pipeline(). Barrière uniquement quand une étape a vraiment besoin de tous les résultats amont d’un coup — dédoublonnage croisé, sortie anticipée sur le total, prompt qui compare aux « autres conclusions ». « C’est du code plus propre » et « les étapes semblent séparées » ne sont pas des raisons : la latence de barrière est réelle, mesurable, gaspillée. Séparé n’est pas synchronisé.
14. Laissez Claude dessiner le graphe — self-routing
Le mouvement final : arrêter de dessiner le graphe à la main pour les jobs qu’on ne peut pas planifier à l’avance. Avec les workflows dynamiques, on décrit l’objectif et Claude écrit lui-même le script d’orchestration — décomposant la tâche, choisissant le fan-out, déployant la flotte, synthétisant le résultat. On obtient un graphe taillé pour ce run au lieu d’un graphe figé dont on espérait qu’il collerait.
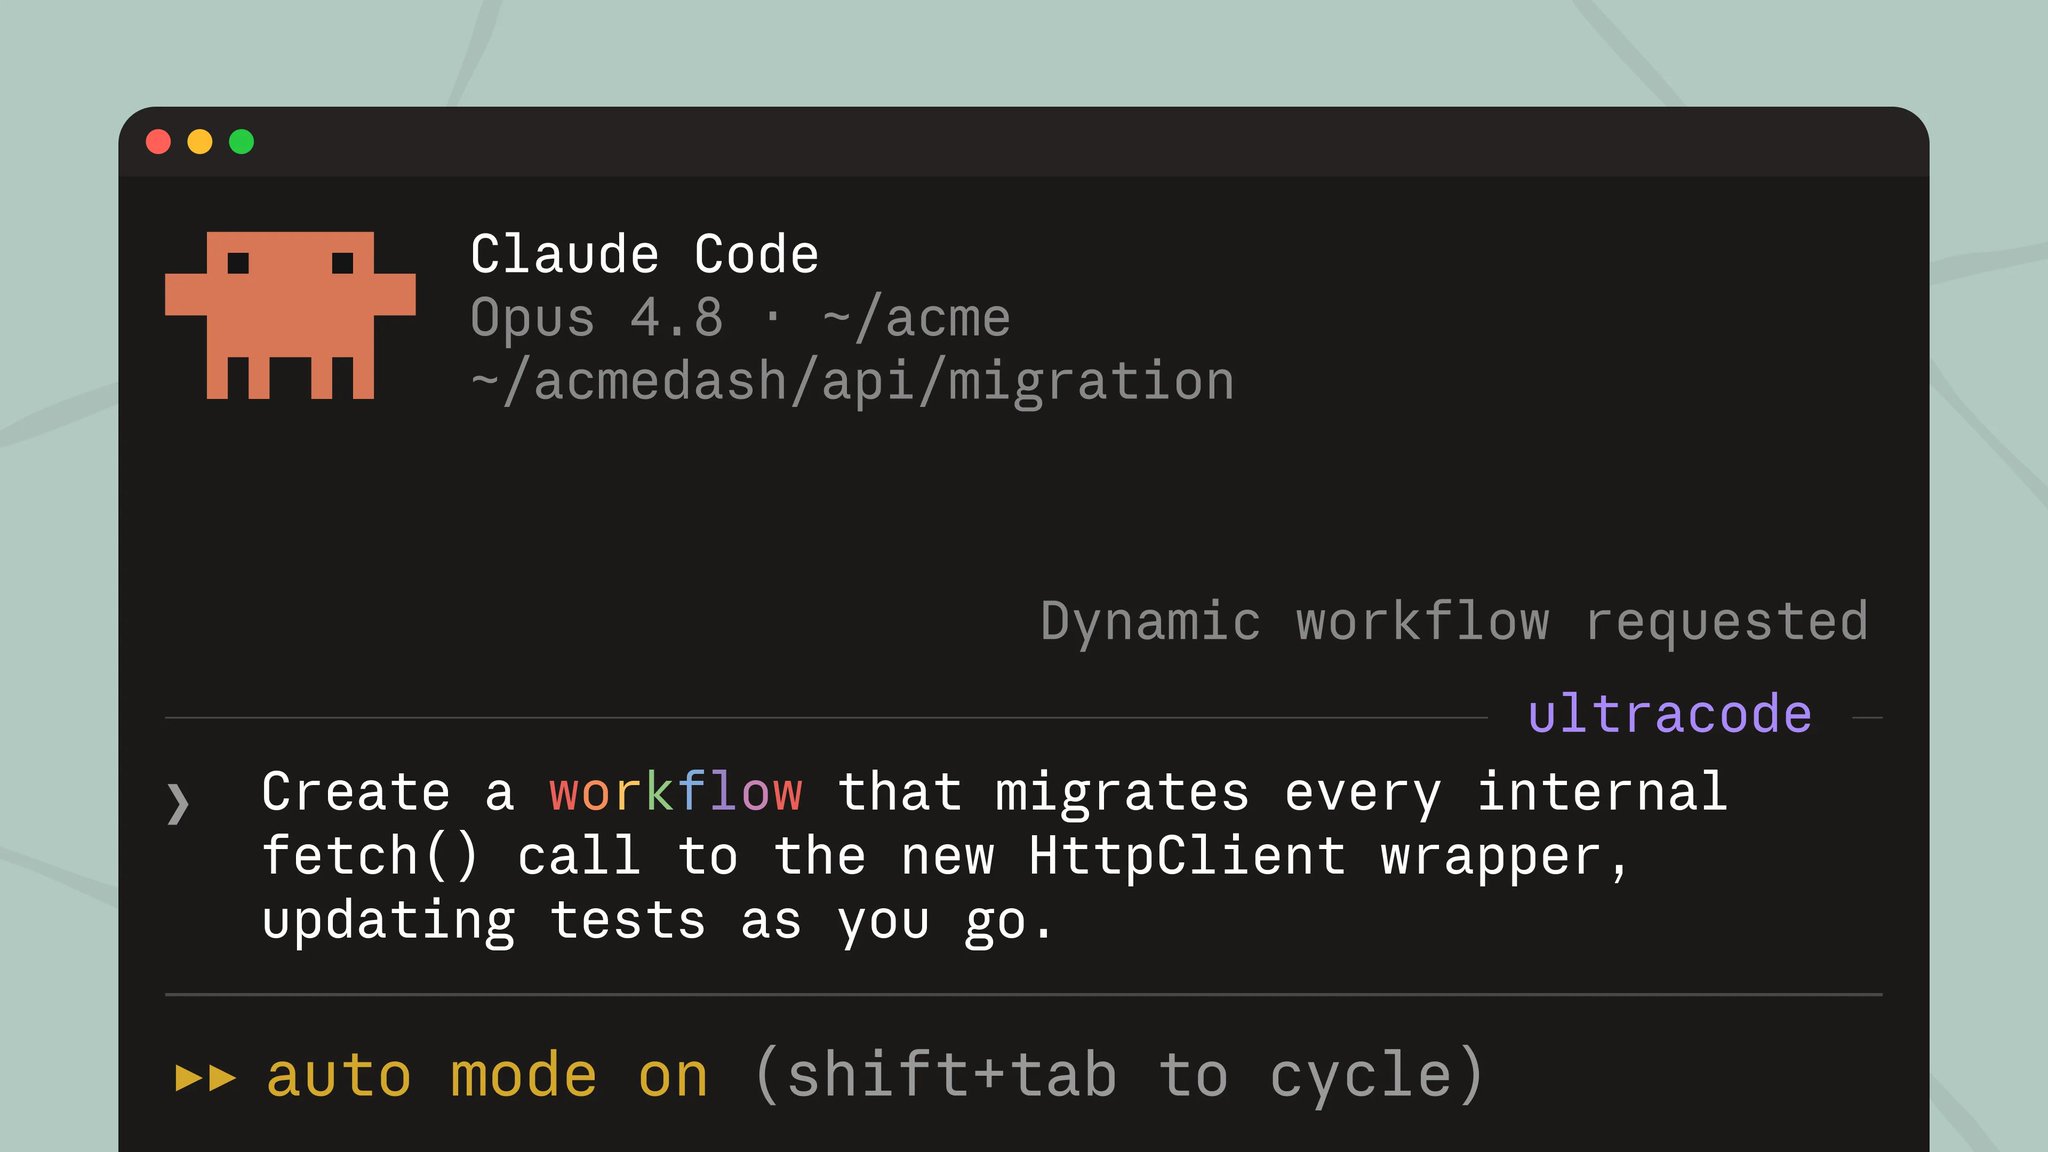
Trois portes d’entrée : dire le mot « workflow » dans son prompt et Claude en écrit un ; lancer un workflow sauvegardé — /deep-research est un vrai graphe en production : scope → parallel search → fetch → adversarial verify → synthesize, exactement le squelette de ce cours ; ou activer ultracode et Claude planifie un workflow pour chaque tâche substantielle de la session. Quand un run est bon, s sauvegarde son script dans .claude/workflows/ — versionné, relançable par nom, lançable par quiconque clone le dépôt.
Six graphes à construire avec Claude cette semaine
- Balayage sécurité sur toutes les routes. Un subagent par fichier de route, chacun à la chasse aux contrôles d’auth manquants, puis une passe vérificateur confirme chaque conclusion avant le rapport.
- Rapport sourcé avec
/deep-research. Claude décompose la question en angles distincts, cherche en parallèle, dédoublonne les sources, puis vérifie chaque affirmation adversarialement avec trois votes de sceptiques avant d’écrire. - Porter un module, fichier par fichier. Claude déploie la traduction en éventail, fait passer la suite de tests comme barrière à chaque fichier, et reboucle les échecs — la revue adversariale attrape ce qu’une passe unique livrerait cassé.
- Revue adversariale d’un diff. Routage sur la taille : petit diff → une passe rapide ; gros diff → audit parallèle complet avec reviewers sur angles distincts, puis jury de synthèse.
- Scan d’écosystème planifié. Sauvegardé une fois, relançable à l’infini : many sources en parallèle — releases, blogs, discussions — classement par impact à une barrière, digest écrit, le tout versionné dans
.claude/workflows/. - Découverte de taille inconnue. Des finders en parallèle, dédoublonnage de chaque trouvaille contre tout ce qui a été vu, vérification des survivants, boucle jusqu’à deux tours vides — puis arrêt.
Conclusion : le prompteur pose une question, l’architecte dessine un graphe
L’agent linéaire n’a jamais été un plafond — c’était juste la première forme, celle que tout le monde attrape parce qu’elle épouse notre façon de taper : une ligne, une tête, une chose à la fois.
Quand on sait voir les nœuds et les arêtes, on cesse de demander à l’agent de faire plus, et on commence à demander au graphe de faire plus large : déployer en éventail là où le travail est indépendant, verrouiller les arêtes là où la confiance compte, étager les modèles là où le jugement n’en a pas besoin.
La plupart des gens continueront d’encaisser leurs étapes en ligne. Ceux qui apprennent à dessiner le graphe piloteront une flotte — et ne remarqueront jamais le plafond sous lequel les autres restent coincés.
Note de veille : les 7,7 M de vues et surtout les 15 000 bookmarks montrent que le sujet touche — la coordination de flottes de subagents via des workflows dynamiques est en train de devenir l’unité d’ingénierie des agents, au-delà du simple « prompt engineering ». À lire en complément : la taxe d’orchestration sur le pilotage de plusieurs agents à la fois.