Boucles et graphes : arrêter de biberoter ses agents et n'approuver que la dernière étape
Boucles et graphes : arrêter de biberoter ses agents et n’approuver que la dernière étape
Source: Hanako (@hanakoxbt) — article X du 23 août 2026
Vous vérifiez chaque étape de vos agents. Non parce que vous le voulez, mais parce que rien d’autre ne le fait.
Sortir de cette chaise demande deux choses, et presque tout le monde n’en construit qu’une.
Une boucle rend une unité de travail correcte sans vous. Un graphe décide quelles unités existent.
Voilà la séparation, la mécanique qui n’est pas évidente, et l’endroit où vous n’approuvez qu’une seule chose au lieu de tout.
Une boucle, c’est un contrôle qui peut échouer
Retirez tout le reste et une boucle tient en quatre parties : produire, vérifier, corriger, répéter jusqu’au vert.
Le contrôle, c’est tout le reste.
Sans quelque chose qui puisse échouer pendant que vous êtes hors de la pièce, vous n’avez pas une boucle. Vous avez un ordonnanceur.
On dirait évident, et presque personne n’écrit le contrôle en premier. On construit le travail, puis on bricole une revue à la fin — et la revue, c’est encore un modèle qui regarde la sortie.
Deux optimistes qui se donnent raison.
Écrivez la condition d’abord, et écrivez-la de façon qu’un programme puisse l’évaluer :
GREEN    the test suite exits 0
GREEN    every claim carries a source line
GREEN    the diff touches only files listed in the plan
NOT A CHECK   the output looks good
NOT A CHECK   the model says it is confident
NOT A CHECK   no errors were raised
Cette dernière ligne attrape les gens méticuleux : l’absence d’erreur n’est pas une preuve de correction.
Construisez une boucle là-dessus et vous obtenez un système qui répète sereinement la même erreur jusqu’à épuisement du budget, avec un journal propre tout du long.
Le plafond que personne ne vous prévient
Une boucle améliore une unité de travail. C’est tout son métier, et elle le fait très bien.
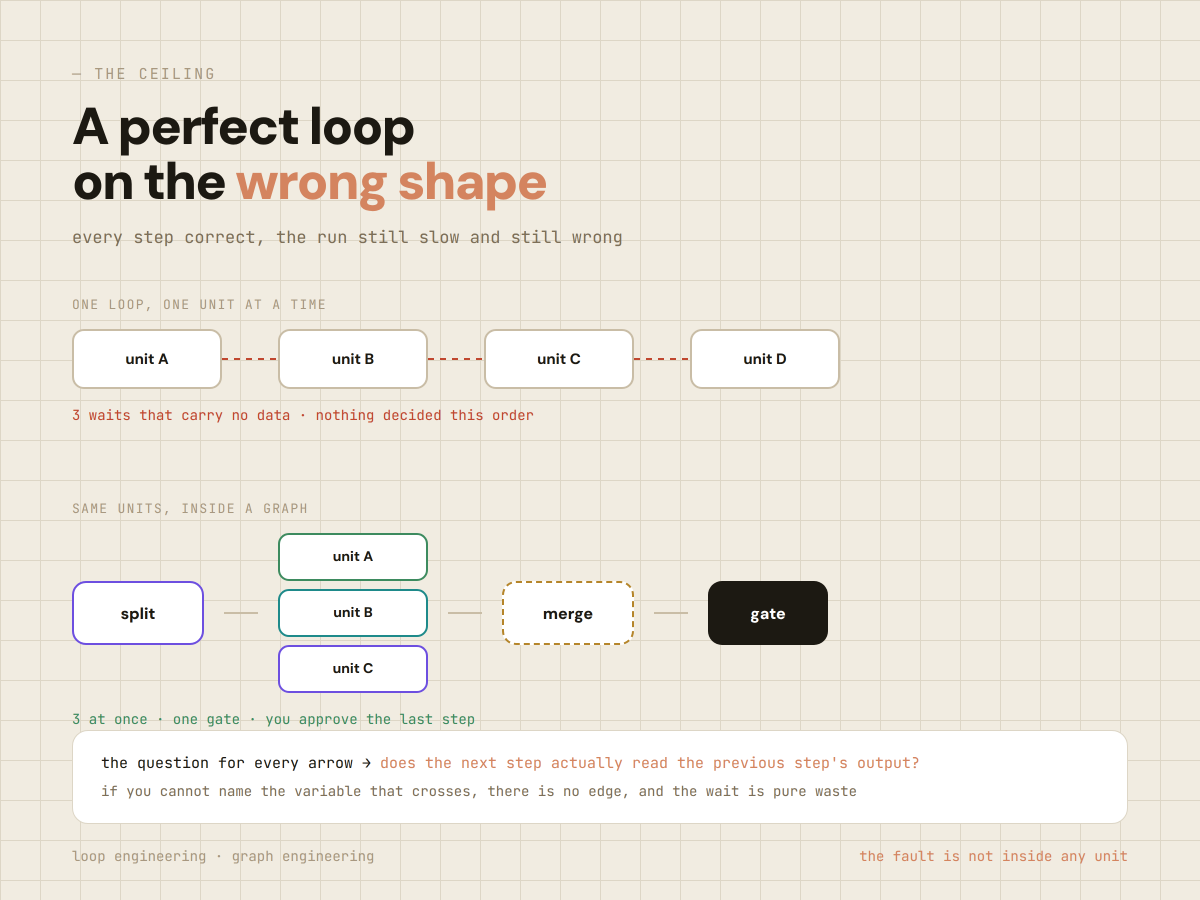
Elle ne décide pas quelles unités existent, ni leur ordre, ni le fait que deux des cinq étapes n’avaient aucune raison de s’attendre.
On se retrouve donc avec un excellent agent qui exécute les trois mauvaises étapes, dans le mauvais ordre, une par une.
Chaque étape est correcte. Le résultat reste lent et mal formé, et optimiser la boucle n’y changera rien, car le défaut n’est dans aucune unité.
C’est le moment où l’on accuse le modèle. C’est aussi le moment où la couche suivante commence à payer.
Le graphe, c’est la couche du dessus
Un graphe, c’est la forme du travail : ce qui s’exécute, ce qui s’exécute en même temps, ce qui attend, ce qui ne s’exécute jamais, et où les résultats repartent.
Deux choses, et rien d’autre. Un nœud est une unité de travail : un job borné, une entrée, une sortie. Une arête est une dépendance : la sortie de ce nœud alimente l’entrée de cet autre.
L’erreur derrière chaque attente inutile, c’est de traiter « et puis » comme une arête.
« Résume le fichier et puis vérifie la météo » n’a aucune arête entre les deux. La météo ne consomme pas le résumé.
Ce sont deux nœuds indépendants qu’un script linéaire a enchaînés, et l’enchaînement venait de l’ordre dans lequel vous les avez tapés.
Alors faites passer ce test sur chaque flèche d’un pipeline que vous avez déjà : est-ce que l’étape suivante lit vraiment la sortie de l’étape précédente ?
Si vous ne pouvez pas nommer la variable qui traverse, il n’y a pas d’arête, et l’attente est du pur gaspillage.
La plupart des chaînes ont deux ou trois flèches de ce genre, et les trouver est généralement le plus gros gain de vitesse disponible d’un coup.
Hanako propose un cours complet de 20 leçons sur les cinq couches de l’ingénierie d’agents (
agent-layers.vercel.app). Le présent article n’est que la version condensée et gratuite des mécanismes clés.
Quatre types de nœuds, dont un n’est pas un modèle
Splitter, worker, code node, gate. Voilà tout le vocabulaire.
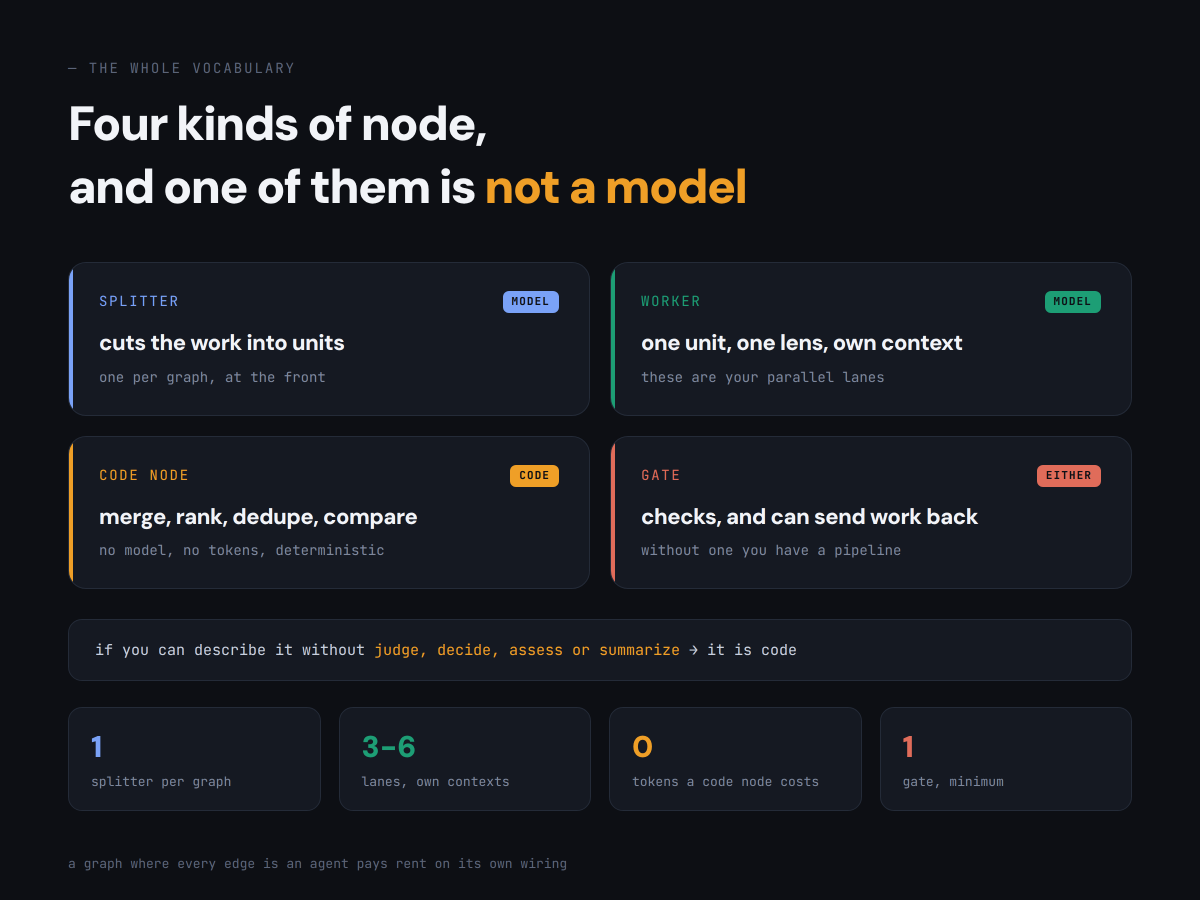
Le splitter découpe le travail en unités et se place à l’entrée.
Il décide plus que tout autre nœud, parce que découper sur la mauvaise dimension gâche tout l’aval.
Coupez un dépôt par dossier et quatre auditeurs passent leur temps sur les mêmes trois fichiers. Coupez par blast radius et chacun voit ce que les autres ne peuvent pas voir.
Les workers font une unité chacun, avec une seule lentille, dans leur propre contexte. Cette dernière condition est sautée en permanence.
Donnez une fenêtre partagée à quatre auditeurs et ils convergent : le premier écrit une constatation, les autres la lisent, et les quatre rapports finissent centrés sur la même chose.
Vous avez payé quatre fois pour une opinion et trois échos.
Le code node, c’est celui qu’on oublie. Fusionner, classer, dédupliquer, comparer chaque export avant/après.
Rien de tout ça n’est du raisonnement. Chaque transformation a exactement une bonne réponse, tient en quelques lignes, et la faire passer par un modèle ajoute du coût, de la latence et de la variance à une étape qui n’en avait pas.
Si vous pouvez décrire la transformation sans les mots juger, décider, évaluer ou résumer, c’est du code.
Un graphe où chaque arête est un agent paie un loyer sur son propre câblage.
Où la boucle vit vraiment
Une phrase lève toute la confusion : la boucle vit à l’intérieur d’un nœud. Le graphe vit entre eux.
À l’intérieur d’une unité : produire, vérifier, corriger, répéter jusqu’au vert.
Entre les unités : split, fan out, merge, gate, retour. Rien de cette seconde liste n’est exprimable depuis l’intérieur d’une seule unité.
Donc vous ne choisissez pas. Un graphe sans boucle dans ses nœuds produit du travail non vérifié en parallèle, ce qui est pire qu’en série puisqu’il y en a davantage.
Une boucle sans graphe autour d’elle est une très bonne étape dans une file que personne n’a dessinée.
Les deux chemins de retour, et celui qu’on saute
Un graphe sans retour possible est un pipeline. Il produit une sortie et oublie.
La semaine suivante il repart du même endroit avec les mêmes angles morts.
Les graphes qui fonctionnent ont deux chemins de retour, qui font des travaux différents.
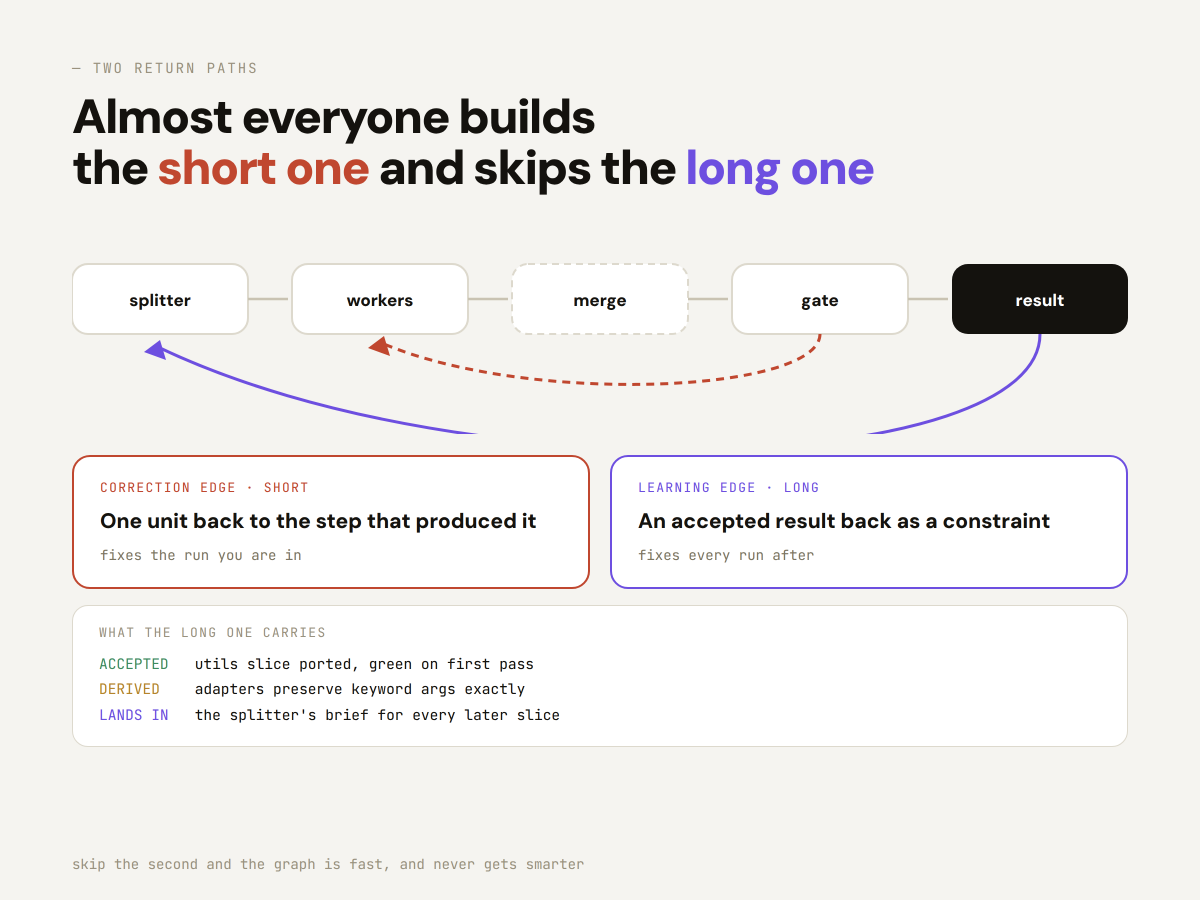
L’arête de correction est courte. Un gate renvoie une unité vers l’étape qui l’a produite, et répare l’exécution en cours.
L’arête d’apprentissage est longue. Un résultat accepté repart vers le splitter sous forme de contrainte, et répare toutes les exécutions suivantes.
Presque tout le monde construit la première et saute la seconde. Le symptôme, c’est un système rapide et qui ne devient jamais plus intelligent.
L’arête d’apprentissage ne transporte pas la sortie, elle transporte une contrainte qui en est dérivée :
ACCEPTED   utils slice ported, green on first pass
DERIVED    adapters preserve keyword args exactly
LANDS IN   the splitter's brief for every later slice
Voyez où elle atterrit. Pas dans les instructions du worker, mais dans le brief qui façonne la façon dont le travail est découpé.
Une cause confirmée devient une règle, donc la prochaine panne commence là où celle-ci s’est terminée.
Renvoyer l’unité, pas le lot
C’est l’erreur la plus coûteuse sur le chemin de retour, et elle mérite d’être dite sans détour.
Quatre tranches ont été portées. Une échoue à ses tests. Si tout le lot repart, trois tranches correctes sont réécrites.
Leur version suivante sera différente, pas meilleure, puisque rien ne leur était reproché.
On revérifie alors les quatre, et parmi les trois autres, il peut y en avoir une qui échoue cette fois-ci pour des raisons sans rapport.
Vous avez converti un échec en quatre résultats incertains et payé le privilège. Faites-le deux fois dans une même exécution et ça ne converge jamais.
Vu de l’extérieur, on dirait le modèle qui échoue en boucle. C’est un chemin de retour qui détruit du travail correct.
Quatre choses voyagent avec un retour, et chacune fait un travail :
UNIT      handlers slice
VERDICT   red
REASON    test_auth_redirect failed
EVIDENCE  expected 302, got 200, handlers/auth.py:88
SCOPE     fix this file only, do not touch other slices
La ligne SCOPE compte plus qu’elle n’en a l’air.
Sans elle, une unité renvoyée gonfle : l’agent ouvre le fichier, remarque deux problèmes voisins, les corrige aussi, et votre correction d’une tranche devient un diff de quatre fichiers que personne n’a relu.
Plafonnez à trois tentatives. Si une unité échoue trois fois, le problème est dans le plan qui l’a produite — et la boucle ne voit pas le plan.
Ouvrir la porte sur le blast radius, pas sur la confiance
La plupart des écrits construisent un score de confiance, fixent un seuil et laissent passer ce qui est au-dessus. C’est la mauvaise variable.
La confiance est l’entrée la plus faible de cette décision, pour une raison facile à manquer : c’est la seule que le modèle peut influencer.
La variable solide, c’est ce qui arrive si le changement est faux. Classez le travail selon le coût de l’erreur à défaire :
- Réversible et contenu. Une modif de copie, un test, une fonction isolée couverte. Un mauvais merge coûte un revert, cette voie peut s’ouvrir en premier.
- Réversible mais large. Une utilité partagée, un ajout de schéma, tout ce que touchent une douzaine d’appelants. On gate sur des vérifications déterministes plus une trajectoire propre.
- Difficile à inverser. Migrations, suppressions, tout ce qui écrit en production ou déplace de l’argent. Cette voie ne s’ouvre pas, quel que soit le score.
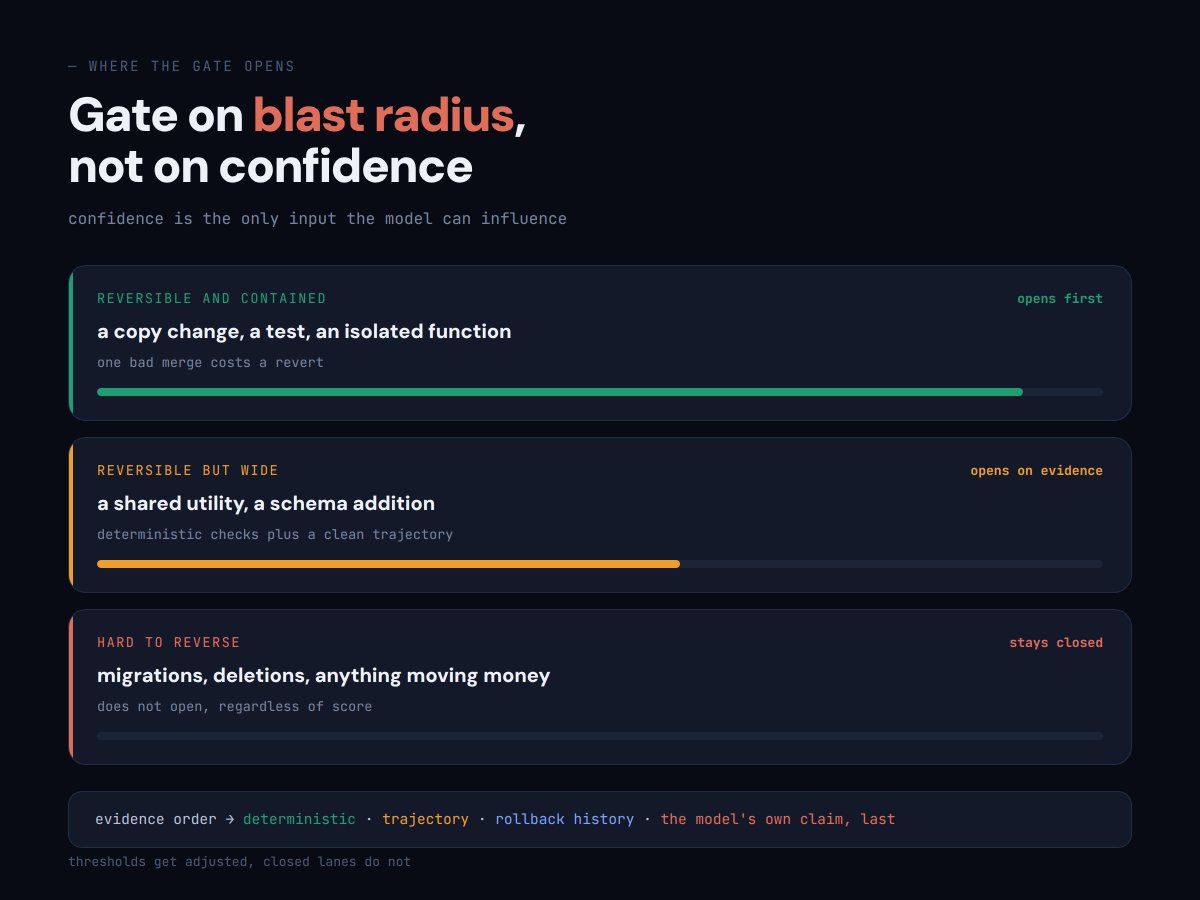
Cette troisième ligne n’est pas un seuil très haut. C’est une voie qui ne s’ouvre pas, et la distinction compte parce que les seuils, eux, se réajustent — pas les voies fermées.
À l’intérieur d’une voie ouverte, le gate lit les preuves dans cet ordre : résultats déterministes, puis trajectoire de cette exécution, puis l’historique de rollback des travaux de ce nœud, et enfin l’auto-évaluation du modèle.
Par où commencer sur votre propre travail
Prenez une chose que vous faites répétitivement. Dessinez le splitter, les voies, le merge, un gate, une arête de retour.
Construisez le gate en premier. Tout devient plus facile dès que quelque chose peut échouer bruyamment, et un graphe sans gate est juste une façon plus rapide de produire de la sortie non vérifiée.
Puis les voies. Puis l’arête d’apprentissage, en dernier, parce qu’on ne peut pas dériver des contraintes de résultats acceptés tant que rien n’accepte de résultats.
Mettez l’humain sur une étape, au point de conséquence maximale et de réversibilité minimale.
Approuvez le merge. Choisissez quels correctifs partent. Pas de revue de la sortie intermédiaire, pas de confirmation à chaque étape.
Un humain au milieu d’un graphe devient le nœud le plus lent du graphe, et le graphe tourne exactement aussi vite que quelqu’un qui lit des choses.
Hanako a transformé ces mécanismes en cours de vingt leçons (
agent-layers.vercel.app) et propose en DM la version condensée d’une page sur la couche graphe. Rien de ce qui précède n’est réservé : ce sont des disciplines, pas des fonctionnalités.
Trois lignes tiennent toute la discipline. Mesurez le chemin, pas seulement la réponse à laquelle il a atterri.
Un verdict qui ne change pas ce qui s’exécute ensuite est un rapport.
Et toute erreur que vous ne transformez pas en contrainte permanente, vous la rencontrerez à nouveau.
La plupart des gens continueront d’ajuster une boucle et d’appeler ça un système. Ceux qui dessineront le graphe autour, eux, lanceront une flotte — sans jamais comprendre pourquoi tout le monde trouve si dur de suivre.
Pour aller plus loin
- Le cours complet (5 couches, 20 leçons, templates et configs) :
agent-layers.vercel.app - Chaîne Telegram de l’autrice sur l’implémentation interne des agents : https://t.me/+75nMf005jRpjMDU1
- Voir aussi sur ce blog : Loop Engineering is dying. Graph Engineering is replacing it — la version théorique du même basculement (nœuds, arêtes, état, policy ; topologies ; patterns Anthropic). Le présent article couvre la mécanique opérationnelle : écrire le contrôle en premier, les deux chemins de retour, le renvoi d’unité et le gate par blast radius.