pg-jev : poser des questions en langage naturel à ses tables Postgres
pg-jev : poser des questions en langage naturel à ses tables Postgres
Source: Avi Chawla (@_avichawla) — post du 3 octobre 2026 · dépôt : realZachi/pg-jev
Un filtre de base de données demande une condition précise et connue à l’avance. Une infinité de questions métier n’en demande jamais :
- Cet article porte-t-il principalement sur l’ingénierie logicielle ?
- Quel sujet le décrit le mieux ?
- À quel point semble-t-il approfondi techniquement ?
Jusqu’ici, la réponse à ces trois questions passait par un chemin obligatoire : sortir les lignes de la base, les emmener dans du code applicatif, appeler un modèle, parser sa réponse, puis écrire le résultat en base. pg-jev propose de supprimer ce détour : c’est une extension PostgreSQL open source qui expose Jev — le modèle de décision de TypeSafe AI — sous forme de fonctions SQL.
CREATE EXTENSION jev CASCADE;

SELECT * FROM people WHERE jev(people, 'the name is European');
Pas de colonne vectorielle. Pas d’index d’embeddings. Juste une fonction booléenne à la place d’un prédicat, et le reste de la requête continue de s’écrire normalement.
Les deux autres articles de ce blog sur le sujet — la vulgarisation d’Akshay Pachaar et l’intégration côté ingénierie — expliquent le modèle. Celui-ci regarde ce que devient l’idée quand on la pousse dans une base de données : ce que ça coûte vraiment, comment l’extension est construite, et ce qu’elle ne peut pas faire.
Les quatre fonctions qui changent le rapport
| Fonction | Renvoie | Usage |
|---|---|---|
jev(row, condition [, threshold]) | boolean | Prédicat WHERE. Seuil : argument → jev.threshold → 0.5 |
jev_prob(row, condition) | float8 | Probabilité 0..1 que la ligne satisfasse la condition |
jev_score(row, question, levels text[]) | float8 | Position pondérée par les probabilités sur des niveaux ordonnés (0 .. n-1) |
jev_choice(row, question, options text[]) | text | L’option la plus probable pour cette ligne |
S’y ajoutent jev_score_norm() (normalisé 0..1), jev_confidence(), jev_eval() qui renvoie la réponse brute en JSONB, et deux utilitaires : jev_stats() — requêtes, tokens, coût estimé, cache, requêtes en vol — et jev_cache_clear().
Le point important n’est pas la liste : jev() est une fonction booléenne ordinaire. Elle se compose donc avec tout le reste de SQL.
-- jev_prob() dans un ORDER BY
SELECT subject, jev_prob(tickets, 'the customer is angry') AS p
FROM tickets ORDER BY p DESC LIMIT 20;

-- jev_choice() dans un GROUP BY
SELECT jev_choice(tickets, 'which team should handle this?',
                  ARRAY['billing', 'technical', 'security', 'sales']) AS team,
       count(*)
FROM tickets GROUP BY 1;

-- un prédicat sémantique combiné à un prédicat exact
SELECT * FROM people WHERE age > 40 AND jev(people, 'the name is European');
Filtrer, trier, grouper, combiner avec un prédicat déterministe : c’est exactement ce qu’on demande à une base de données, et c’est là que la plupart des solutions de recherche sémantique s’arrêtent. Ici, le classement et l’agrégation restent du SQL.
La démo
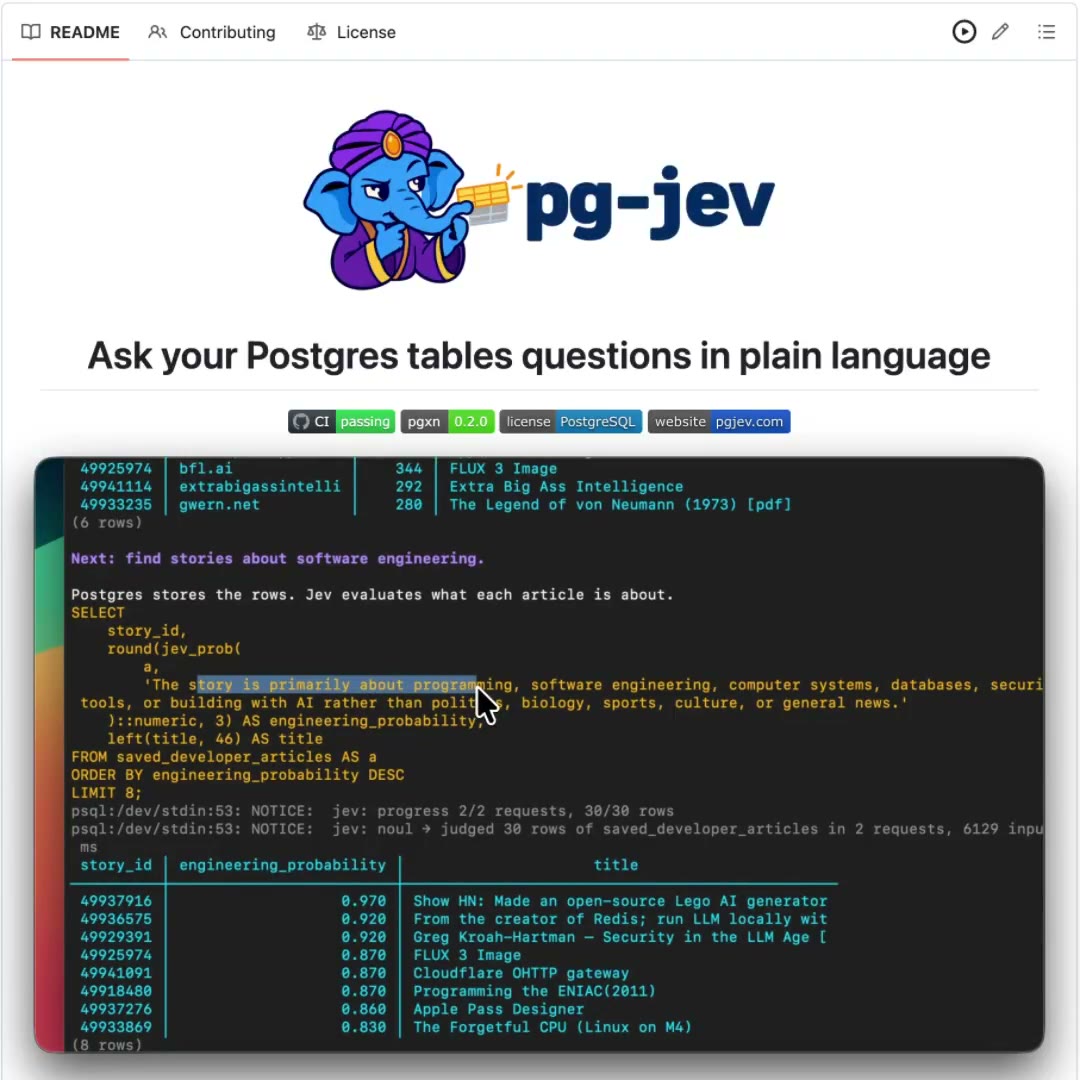
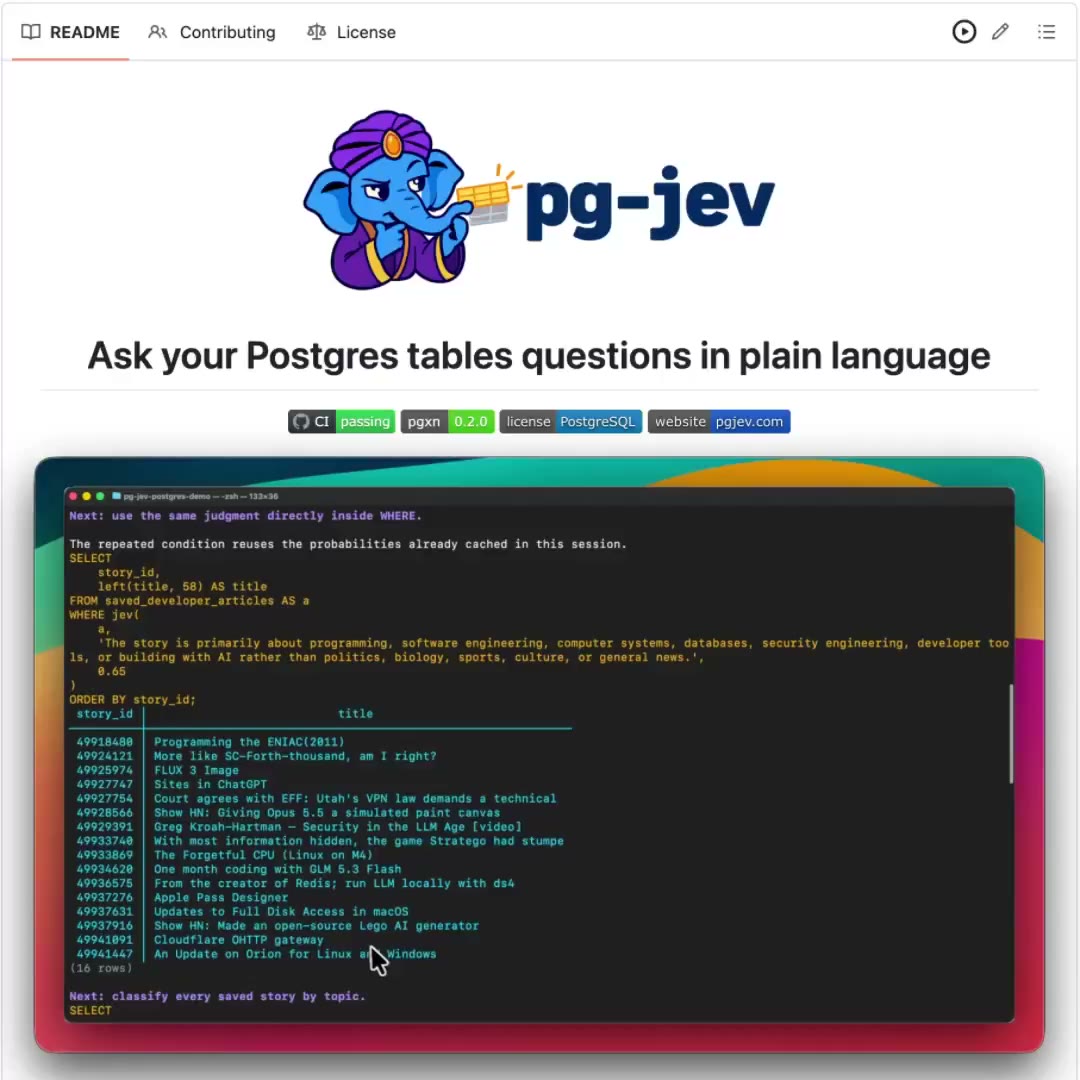
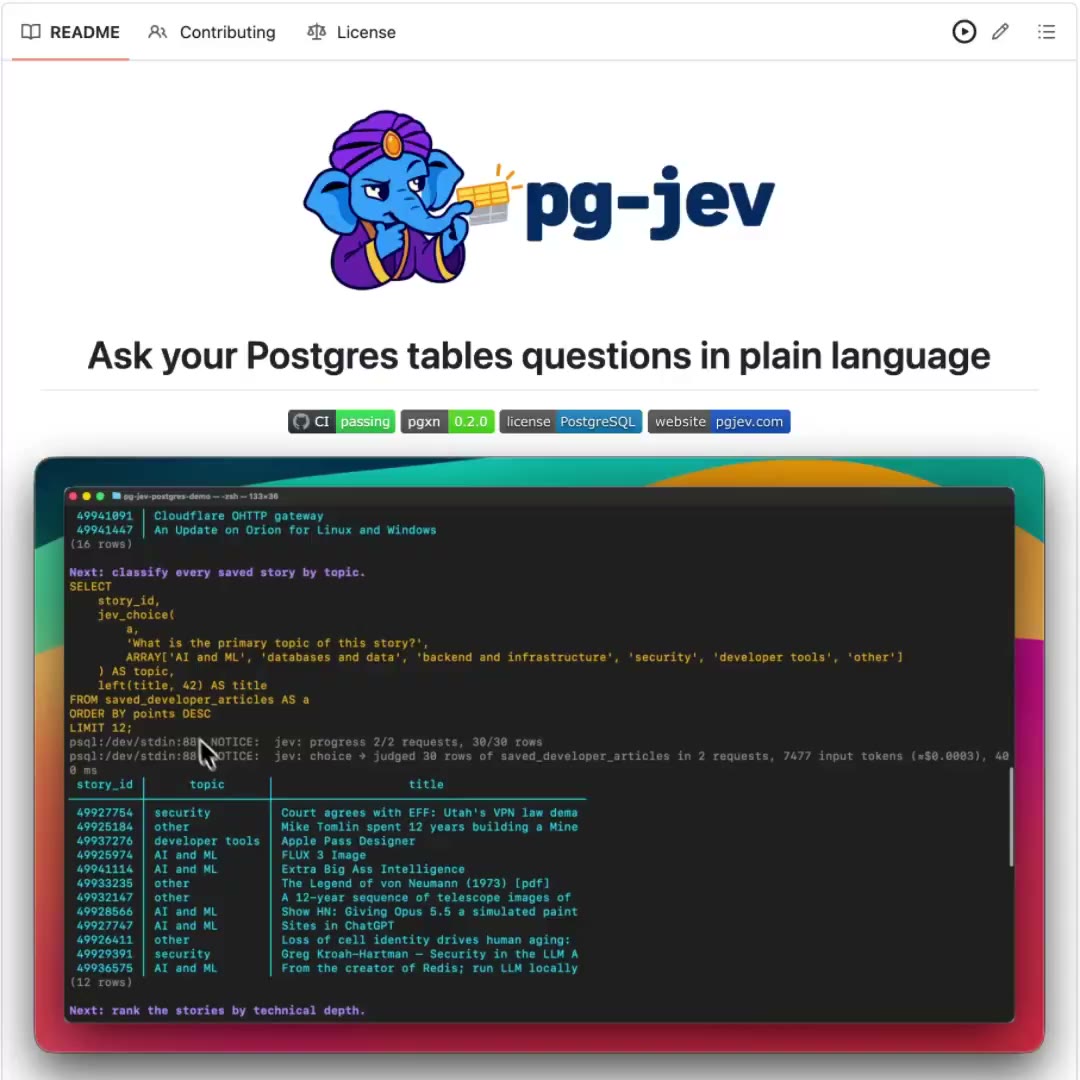
L’enregistrement de la démo (le lecteur vidéo est en bas de cet article) fait tourner la chose sur de vrais articles Hacker News stockés dans Postgres. Il montre d’abord les lignes brutes, puis demande à Jev de trouver les histoires d’ingénierie logicielle, de les classer par sujet, et de les classer par profondeur technique. La dernière requête sort les compteurs de la session : requêtes, tokens, coût, cache.
La première requête classe et trie par probabilité. Notez les messages NOTICE : l’extension compte ses propres appels à l’API en direct.
Puis la même décision, réécrite comme un prédicat dans le WHERE :
Et enfin une classification par sujet, groupée et triée par points :
Un détail vaut d’être souligné dans la deuxième requête : elle réutilise les probabilités déjà en cache dans la session. Rejouer la même condition, changer le seuil ou trier par probabilité ne coûte alors plus rien.
Comment c’est construit
Sous le capot, l’extension est en PL/Python et fait quatre choses.
1. Un read-ahead en streaming. jev(table, 'condition') reçoit la ligne comme valeur composite. Au premier appel pour une table + une condition, l’extension lance une lecture en avance qui parcourt la table dans l’ordre physique — parcours de plages de TID pour les tables, pages par OFFSET pour les vues. La mémoire reste constante quelle que soit la taille de la table.
2. Des lots. Les lignes sont empaquetées par jev.batch_size (20 par défaut) dans un même état partagé — {"condition": ..., "rows": [...]} — avec une question oui/non par ligne. Jev évalue toutes les questions d’un même état en parallèle, ce qui amortit le surcoût d’en-tête d’environ 270 tokens par requête : 435 tokens pour une ligne seule contre 175 par ligne en lots de 20.
3. De la concurrence, et l’arrêt précoce. Jusqu’à 2 × jev.concurrency requêtes sont en vol sur des connexions HTTPS persistantes, et chaque ligne est répondue dès que son lot revient. Un LIMIT arrête donc le read-ahead après la fenêtre en vol, et les lignes qu’un prédicat moins cher a déjà écartées sont sautées au lieu d’être jugées. C’est le levier de coût le plus important en pratique.
4. Un cache par session. Les réponses sont mises en cache par contenu de ligne, pour la durée du backend. Avec un pool de connexions, chaque session réchauffe son propre cache.
Pourquoi 20 lignes par requête
C’est le détail le plus intéressant du dépôt, parce que c’est le seul endroit où quelqu’un a mesuré l’échec au lieu de le proclamer.
Jev doit retrouver rows[i] par position dans le tableau, et cette recherche se dégrade dans les longs tableaux. Sur un ground truth construit à partir de colonnes structurées — poste, appartenance à l’UE, une phrase dans un champ libre, 400 lignes chacune :
| Lignes par requête | Exactitude |
|---|---|
| 1 à 20 | 100 % |
| 40 | 92 à 98 % |
| 80 | 77 à 94 % |
Des lignes plus larges (1 000 caractères) ne changeaient rien à 20. Nommer les lignes au lieu de les indexer n’a pas aidé non plus. Et des lots de 20 coûtent 4 % de tokens de plus que des lots de 40, pour la même vitesse — la latence d’une requête dépend à peine de sa taille.
La version 0.1.0 utilisait 40 par défaut ; c’est la version 0.2.0 du 18 septembre 2026 qui est descendue à 20.
Ce que ça coûte vraiment
Mesures publiées dans le README, sur une table de 2 000 lignes, depuis l’Europe (~190 ms d’aller-retour vers l’API) :
| v0.1.0 | v0.2.0 | |
|---|---|---|
| Première exécution | 8,5 s | 3,5 s |
| Tokens d’entrée | 338 k | 296 k |
LIMIT 3 sur une condition neuve | 8,4 s | 0,6 s |
| Nouvelle condition, connexions en pool déjà chaudes | — | ~2,3 s |
| Seconde exécution (cache) | — | ~50 ms |
| Coût de la première exécution | — | ~0,012 $ |
Le gain de la 0.2.0 vient de quatre ajustements : le streaming (avant, toute la table était lue d’un bloc, jusqu’à 5 000 lignes, avant la première réponse), les connexions HTTPS persistantes — une requête quiouvrait une nouvelle connexion TLS à chaque fois, 880 ms, est passée à 300 ms —, la taille de lot ramenée de 40 à 20, et la suppression des criteria génériques sur les questions Noul, qui consommaient 16 % de tous les tokens d’entrée sans changer une seule réponse.
La ligne des 2,3 s mérite qu’on s’y arrête. Une nouvelle condition dans une session qui a déjà des connexions en pool demande ~2,3 s, alors que la toute première l’a mesurée entre 0,9 et 1,9 s. La première requête sur une connexion neuve paie un handshake TLS, plus jusqu’à 1,5 s de mise en place côté serveur. D’où le réglage jev.keepalive (600 s par défaut) et des sondes TCP keepalive : une connexion silencieusement morte est détectée avant réutilisation.
À l’échelle, une fraction de centime pour deux mille lignes n’a rien de choquant. Ce qui peut l’être, c’est un SELECT sans LIMIT sur une table de cent mille lignes lancé par erreur dans un rapport quotidien. Les garde-fous existent :
SET jev.max_rows_per_statement = 5000;   -- avorte au-delà
SET jev.max_chars_per_statement = 2000000;
Installer
Prérequis : PostgreSQL 14 à 17 avec plpython3u, un compte superuser, et une clé API TypeSafe. Le CASCADE de CREATE EXTENSION installe plpython3u lui-même.
# Via PGXN
pip install pgxnclient
pgxn install jev
psql -c "CREATE EXTENSION jev CASCADE"

# Ou depuis les sources
git clone https://github.com/realZachi/pg-jev.git && cd pg-jev
make install
Il y a aussi une image Docker (docker build -t pg-jev .), la variable d’environnement TYPESAFE_API_KEY pour le processus serveur, ou un réglage par rôle :
SET jev.api_key = 'your-key';
ALTER ROLE analyst SET jev.api_key = 'your-key';   -- persistant, par rôle
Le dépôt embarque un skill d’agent installable en une ligne — npx skills add realZachi/pg-jev — qui fait le préflight (version de PostgreSQL, plpython3u, superuser), installe, place la clé et lance un test de fumée. La documentation de pgjev.com se lit aussi en Markdown : il suffit d’ajouter .md à n’importe quelle URL sous /docs.
Le projet tourne une suite de régression pg_regress contre une API simulée déterministe (test/mock_api.py) : les tests n’appellent jamais le service réel.
Écrire de bonnes conditions
Le README est inhabituellement honnête sur ce point, et ses quatre conseils sont ceux que je retiendrais :
- Énoncez la condition exacte.
'the customer threatens to leave, dispute a charge, or take legal action'bat'churn risk'. Le modèle répond littéralement à ce que vous avez écrit. - Gardez l’arithmétique, les dates et les correspondances exactes en SQL. Ne déléguez que le sens.
- Regardez la distribution avec
jev_prob()avant de choisir un seuil. Les cas ambigus atterrissent vraiment vers 0,5. - N’envoyez que les colonnes utiles. Créez une vue avec les colonnes nécessaires (et un pré-filtre éventuel), et appelez
jev(vue, ...)sur la vue : les vues sont lues en avance et regroupées comme les tables.
Les limites, sans les adoucir
C’est un full scan par conception. Chaque ligne que l’exécuteur examine part vers l’API. Les prédicats moins chers dans le même WHERE s’exécutent d’abord et leurs rejets sont sautés, un LIMIT arrête en avance, et jev.max_rows_per_statement plafonne la facture. Mais un ORDER BY jev_prob(...) sans LIMIT sur une grosse table ne s’arrêtera de lui-même.
Les données sortent de votre base. Le contenu des lignes est envoyé à une API tierce. À ne pas utiliser sur des données que vous n’êtes pas autorisé à partager.
plpython3u est un langage non fiable. Seul un superuser peut créer l’extension, et les fonctions s’exécutent avec les privilèges du système d’exploitation du serveur Postgres. C’est le vrai coût d’entrée, plus que la licence.
Les hébergeurs managés sont exclus. Supabase, Neon, RDS et consorts ne donnent ni superuser ni plpython3u. L’extension ne tourne pas là.
Les lignes d’une sous-requête ou d’un CTE ne sont pas lues en avance. Elles sont jugées une requête à la fois. Mettez jev() sur une table de base ou une vue.
Et le rappel qui vaut pour tout modèle de décision, déjà développé dans l’article sur l’intégration de Jev : une probabilité de 0,97 ne signifie pas 97 % de réponses justes. Le type de retour protège la forme, pas la justesse.
Ce que Jev fait vraiment sous le capot
Le post cite un second article d’Avi Chawla, « Build your own Jev (100% local) », qui reproduit le mécanisme d’inférence de Jev avec des modèles ouverts et SGLang. La lecture est instructive, et la partie la plus utile est celle qui explique pourquoi c’est plus rapide.
Quand un LLM génère, il produit à chaque position un vecteur de la taille du vocabulaire — des dizaines de milliers de valeurs pour Qwen. Ce sont des logits, pas encore des probabilités. Le serveur de génération applique ensuite ses règles de décodage, choisit un token, le rajoute au prompt, et recommence.
Pour une décision bornée, seul le premier vecteur compte. Si le prompt se termine par Label: et que les trois choix possibles sont étiquetés A, B et C dans le prompt, alors le chemin se réduit à quatre opérations : trouver les identifiants de token de A, B et C ; lire les trois logits à ces positions ; ignorer tous les autres ; appliquer un softmax sur ces trois valeurs seulement.
Le mot important est seulement. Ce n’est pas « A a 91 % de probabilité dans tout le vocabulaire », c’est « une fois que l’application a éliminé toutes les autres réponses, comment le modèle répartit sa préférence entre A, B et C ».
Trois détails que l’article traite très bien :
- Les étiquettes sont des lettres, pas les mots. « billing » peut être un token chez un tokenizer et cinq chez un autre ; « technical support » occupe sûrement plusieurs positions, auquel cas il faut scorer une séquence et la longueur devient un biais dans la comparaison. Les étiquettes A/B/C occupent chacune une seule entrée du vocabulaire à la même position de sortie, et le sens reste dans le prompt.
- Il faut vérifier la tokenisation. « A » et « A » (avec l’espace) ont des identifiants différents, et un template de chat peut insérer de l’espace avant la position de réponse. La solution : rendre le prompt avec le template du modèle, envoyer la continuation attendue à
/tokenize, et refuser toute étiquette qui produit plus d’un token. - Il faut une sortie de secours. Si la liste de choix n’est pas exhaustive, un softmax restreint mettra toute la masse sur les mauvais choix. Ajoutez
OTHERouESCALATE.
Sur son exemple concret, Qwen2.5-0.5B-Instruct renvoie des logits de 25,277620 / 24,498226 / 21,188837 avant softmax : billing gagne, mais à 0,678 seulement. Une politique exigeant 0,70 enverrait ce ticket en revue au lieu de le router automatiquement.
L’auteur est explicite sur les limites : il reproduit le chemin d’inférence, pas le système Jev complet. Pas les poids, pas le RLCD, pas la calibration. Rappelez-vous que 0,91 veut dire 91 % de la masse de probabilité attribuée à ces trois choix — pas 91 % de réponses correctes.
Mon avis
Le slogan marketing tient en une phrase : Postgres garde les données et contrôle la requête, Jev s’occupe de ce que SQL ne peut pas exprimer comme condition déterministe. Elle est exacte, et elle explique aussi la limite : dès que la décision sort du cadre d’une condition booléenne ou d’un classement, on retombe sur du code applicatif.
Ce que j’apprécie dans le dépôt, ce n’est pas l’astuce du marketing, c’est la page « Why 20 rows per request ». Quelqu’un a mesuré son propre échec (92 à 98 % à 40 lignes), publié le tableau, et abaissé son réglage par défaut au prix de 4 % de tokens en plus. C’est rare, et c’est le meilleur argument pour faire confiance au reste des chiffres.
Ce que j’en retiens comme règle d’usage : nissez votre WHERE. Un age > 60 AND jev(...) ne juge pas les lignes que le premier prédicat a déjà écartées. C’est le seul levier qui fasse vraiment changer l’échelle du coût d’un rapport — et c’est une ligne de SQL, pas une décision d’architecture.
Sources
- realZachi/pg-jev — dépôt, licence PostgreSQL, version 0.2.0
- pgjev.com — site et documentation (ajoutez
.mdà une URL/docspour une version Markdown) - Avi Chawla — « Build your own Jev (100% local) »
- TypeSafe AI — System One Models et Jev
- Jev clairement expliqué · Jev côté ingénierie
Vidéos de l'article
- ▶ Ouvrir la vidéo
/videos/pg-jev.mp4