Les 5 niveaux d'ingénierie des agents IA : du prompt unique à l'agent de production
Les 5 niveaux d’ingénierie des agents IA : du prompt unique à l’agent de production
Source : Yarchi (@undefinedKi) — post du 28 septembre 2026 · 660 496 vues, 429 likes, 52 reposts, 1 155 bookmarks
Article original : « The 5 levels of AI agents. From a single prompt to a production agent (Complete course) ». Note : l’article est un contenu sponsorisé par Viktor (un agent IA pour Slack/Teams) — chaque couche se termine par un « raccourci » no-code, résumé ici en fin de section.
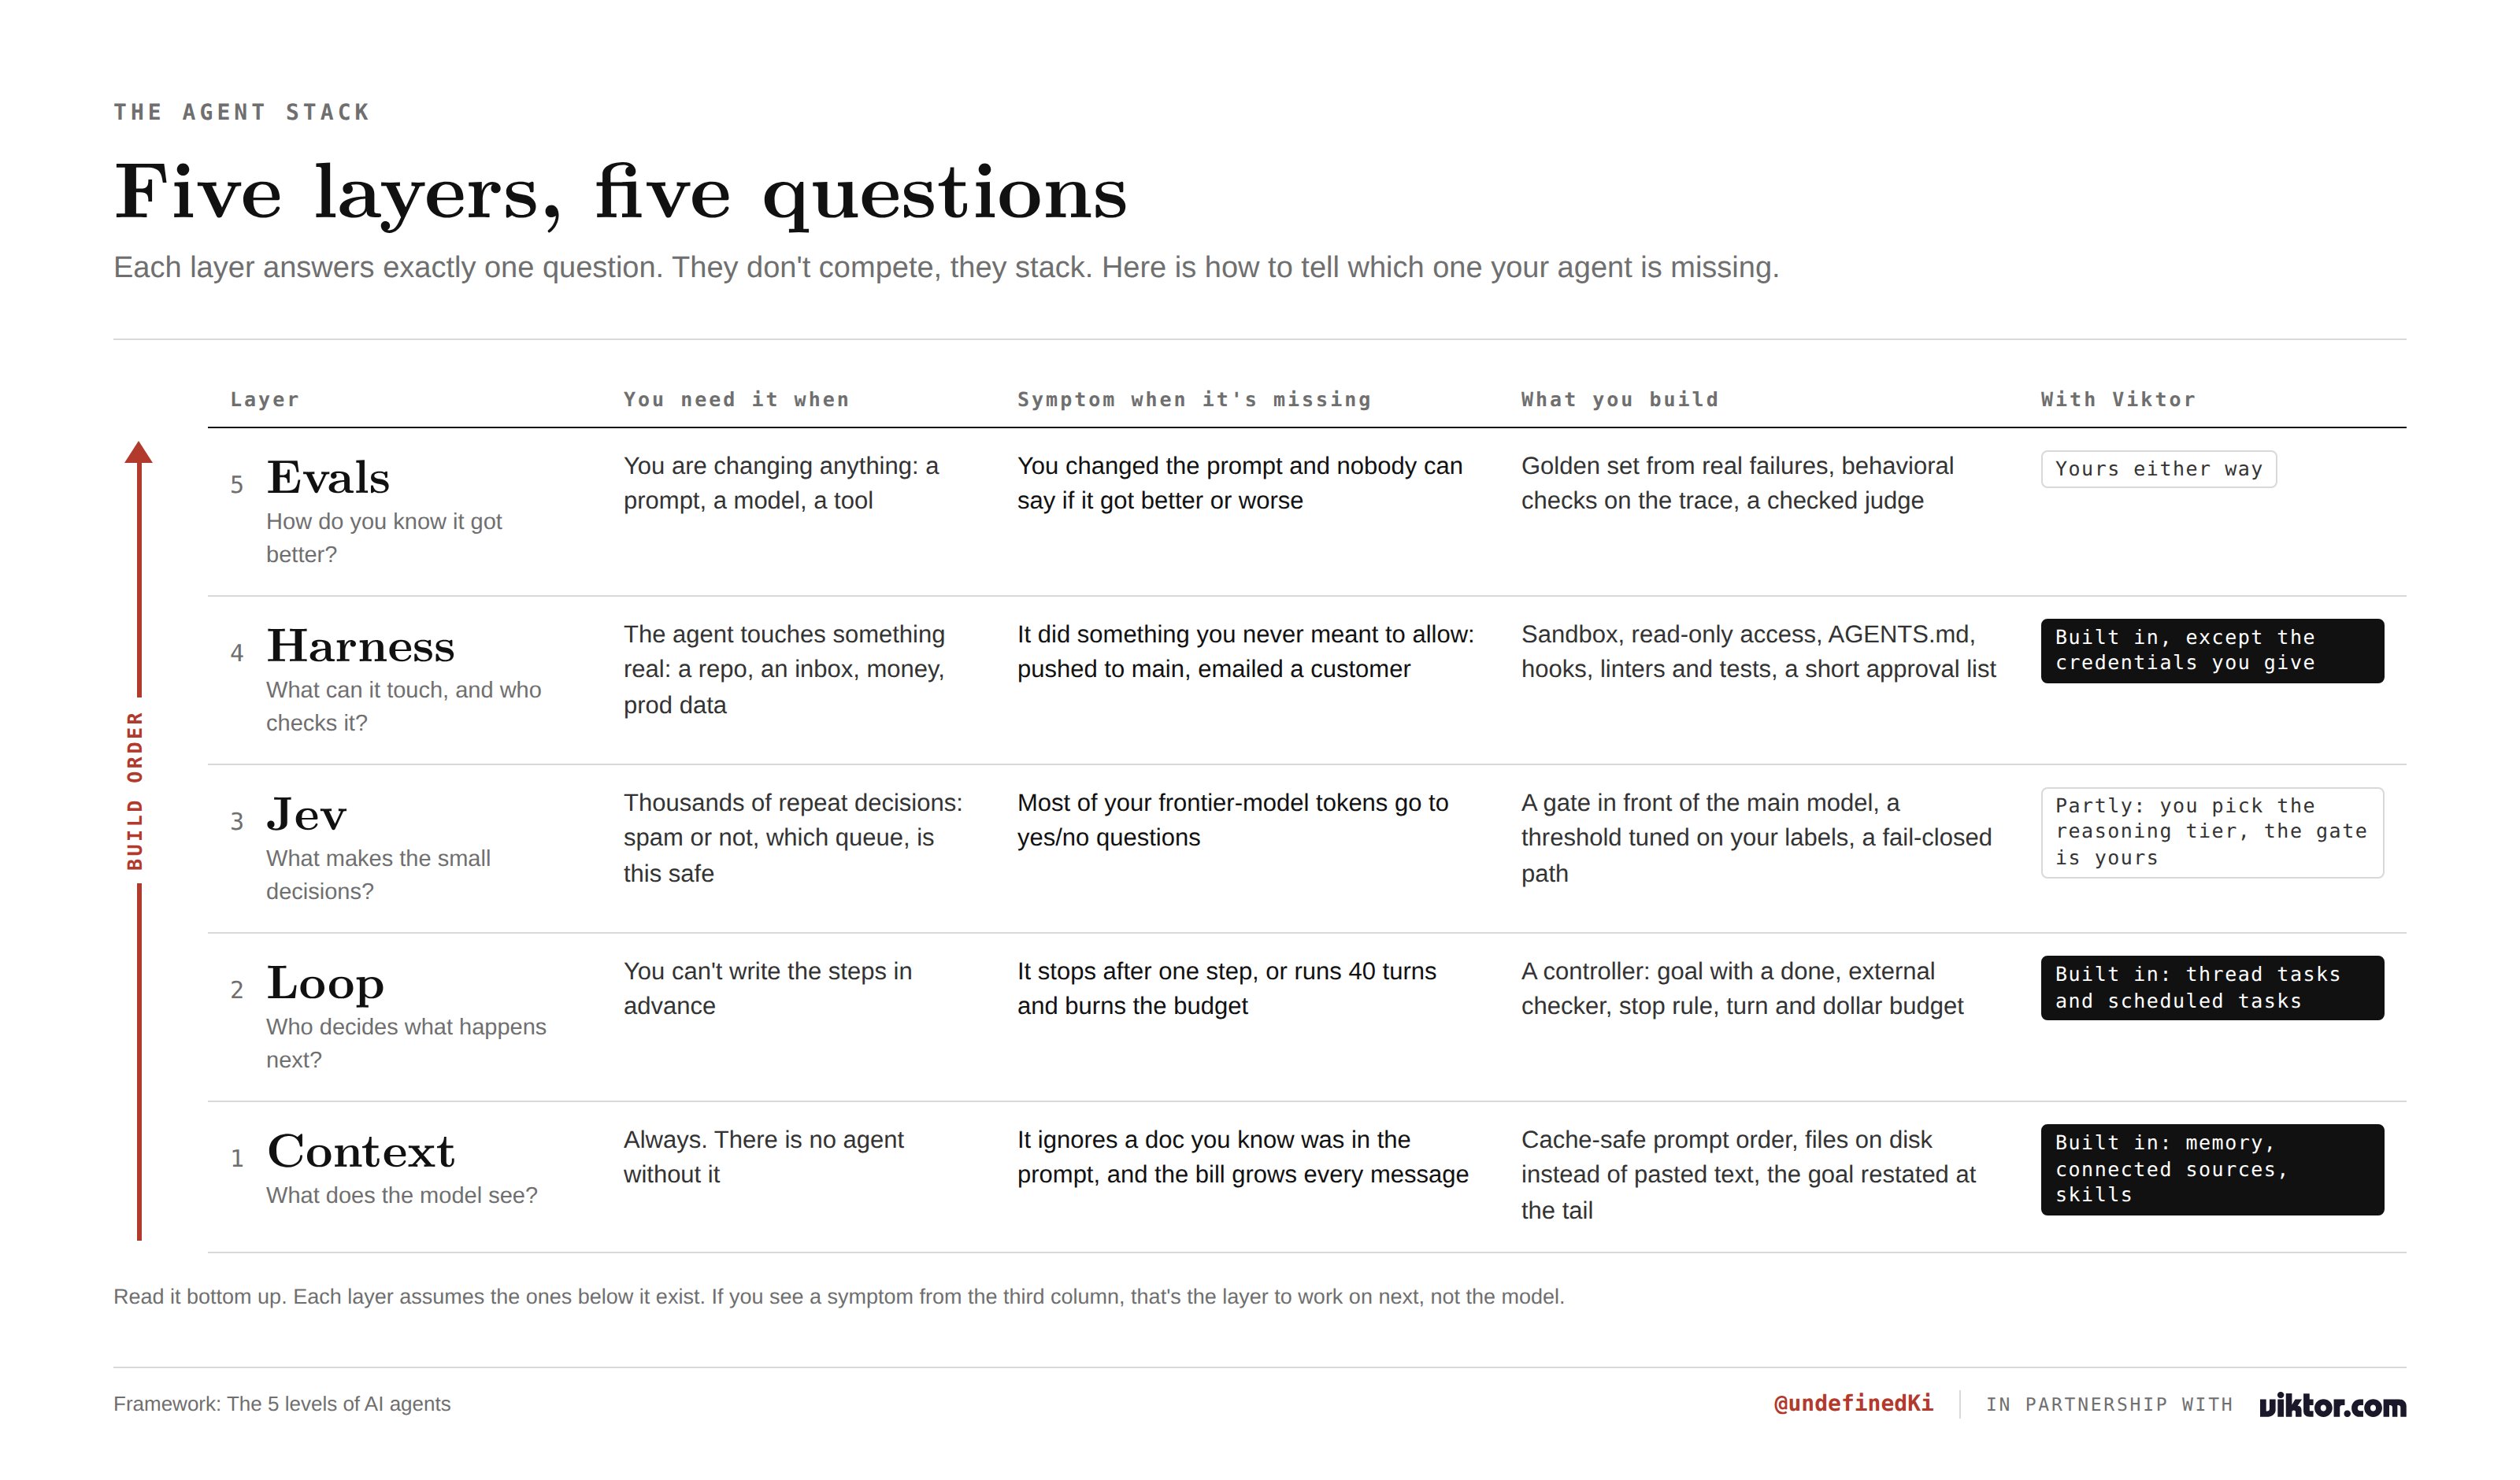
Cinq mots tournent en ce moment autour des agents : context engineering, loop engineering, Jev engineering, harness engineering, eval engineering. Ils ont l’air de cinq approches concurrentes. Ils ne le sont pas : ce sont cinq couches du même système, et chacune répond à une question.
La façon la plus simple de les voir : imaginez que vous venez d’embaucher un employé.
- Context — ce qui est sur son bureau quand vous lui posez une question
- Loop — est-ce qu’il suit votre checklist ou trouve lui-même l’étape suivante
- Jev — la standardiste qui trie le courrier, pour qu’il ne voie que l’essentiel
- Harness — son bureau : les outils, les clés, et qui vérifie son travail
- Evals — le même test chaque mois, pour savoir s’il progresse vraiment
Un agent IA, c’est cet employé. Le modèle est la personne, et ces cinq couches sont tout ce qui l’entoure. Bien réglées, elles permettent à une petite équipe d’absorber du travail qui exigeait du recrutement : le répétable part dans un agent qui tient en production, les humains gardent les décisions.
1. Context engineering — qu’est-ce qui est sur le bureau
Définition
Le modèle, c’est l’employé. Le bureau, c’est la fenêtre de contexte : tout ce qu’il voit avant de répondre — vos instructions, l’historique, les documents, la sortie de chaque outil. Le context engineering, c’est décider ce qui va sur le bureau, et où.
Comment ça marche
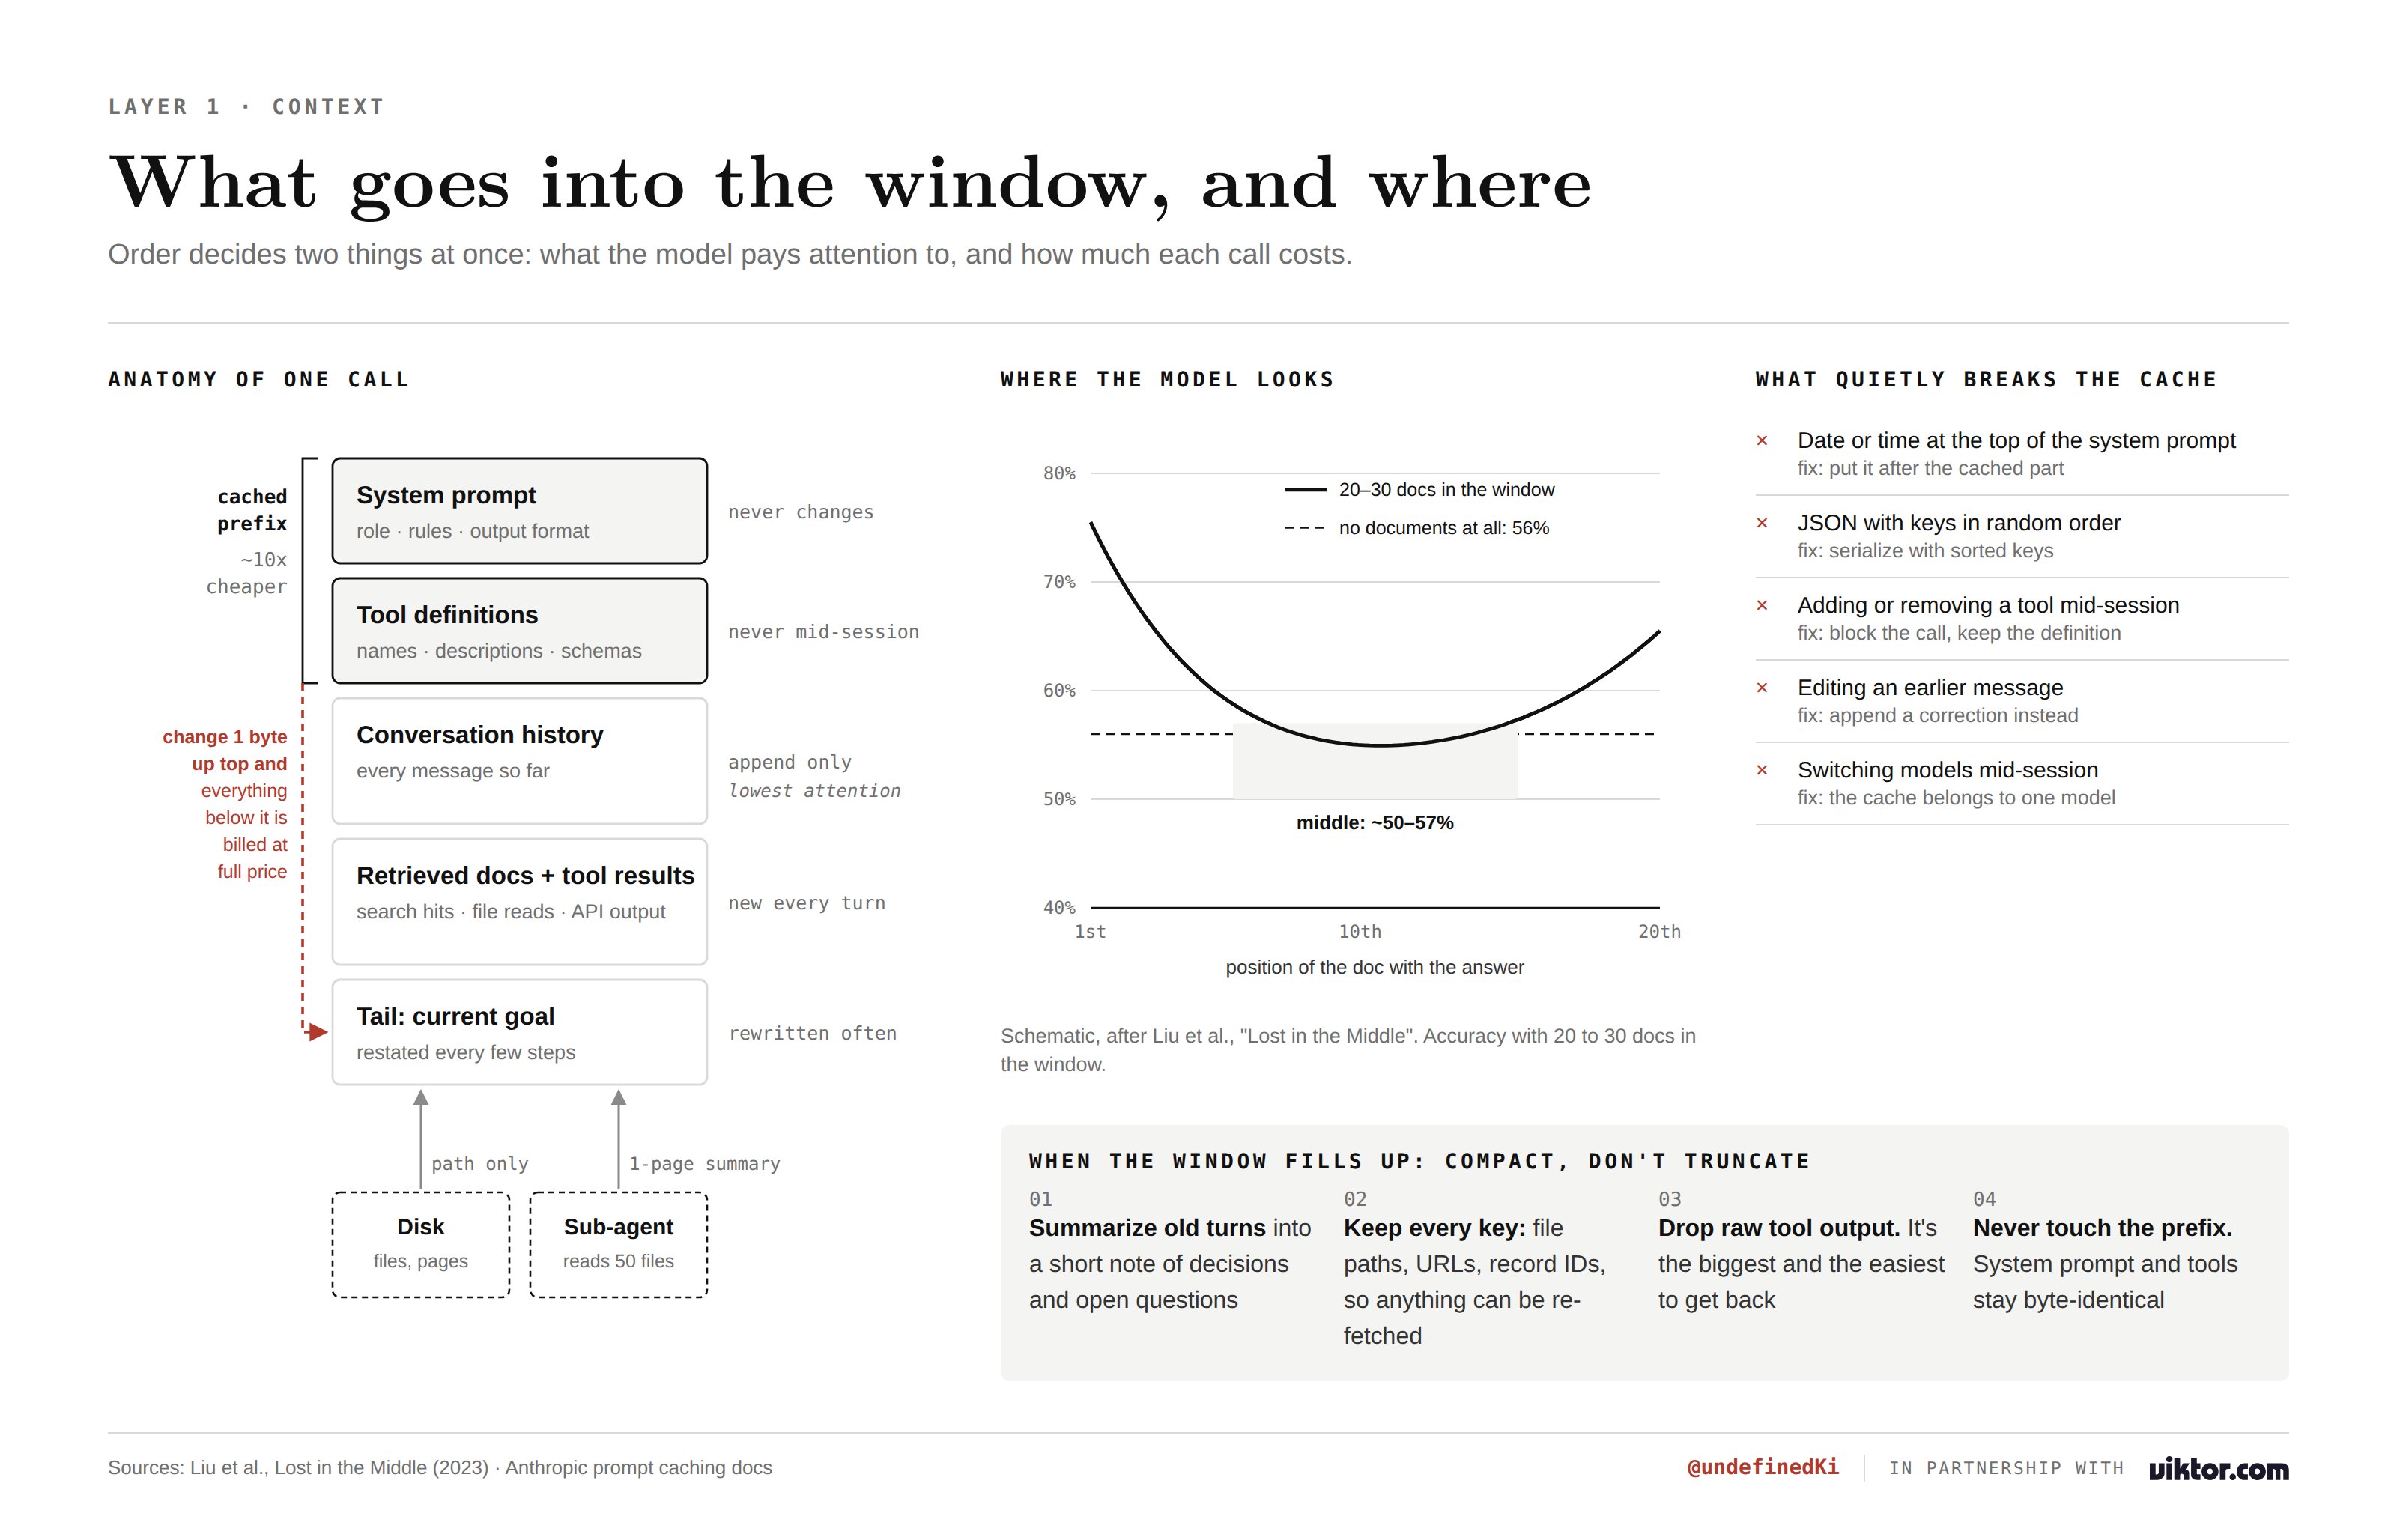
Plus de contexte ne veut pas dire meilleures réponses. Stanford l’a mesuré : avec 20 à 30 documents dans la fenêtre, la précision sur ceux du milieu chute à 50-57 % — soit moins que le même modèle sans aucun document (56 %). La réponse était dans la fenêtre, et le modèle faisait pire que sans rien.
Deux causes : l’attention se porte sur le début et la fin de la fenêtre, rarement sur le milieu ; et chaque token coûte du temps et de l’argent, qu’il aide ou non.
Le seul mécanisme à connaître : le prompt caching. Le provider stocke le début de votre prompt et le réutilise — un token caché coûte environ 10× moins cher. Mais le cache n’est valable que si ce début est identique octet par octet. Un caractère changé en haut, et tout ce qui suit repasse au tarif plein. D’où la règle : le stable d’abord, le changeant à la fin.
Comment le construire
Chaque morceau de contexte va dans l’un de ces quatre endroits :
- System prompt — uniquement ce qui est vrai à chaque appel : rôle, contraintes, format de sortie. Identique octet par octet : pas de timestamp en haut, pas de clés JSON dans un ordre aléatoire.
- Tools — ne pas en ajouter ni retirer en cours de conversation : ça casse le cache et laisse le modèle appeler des outils disparus. Pour restreindre un outil, bloquez l’appel mais gardez la définition.
- Disque — tout ce qui est gros ou durable part dans un fichier ; seul le chemin reste dans la fenêtre. Même logique pour une page web : garder l’URL, jeter le corps.
- Queue — toutes les quelques étapes, rappelez l’objectif courant en fin de contexte. Le milieu, on ne peut pas le réparer ; gardons ce qui compte hors de lui.
Les outils ont aussi un coût : Anthropic a mesuré 58 définitions d’outils ≈ 55 000 tokens avant même que l’utilisateur ne tape un mot. Laisser le modèle chercher les outils au lieu de tous les charger a fait passer Opus 4 de 49 % à 74 % sur leur benchmark. En dessous de ~20 outils, chargez-les ; au-delà, passez à la recherche.
Astuce pour les gros jobs : envoyez un sous-agent. Il lit les 50 fichiers dans sa propre fenêtre et ne rend qu’une synthèse d’une page.
Raccourci (Viktor) : mémoire persistante au niveau entreprise, sources connectées (Notion, Drive, HubSpot) et skills enregistrés à l’écran — la règle du disque, toute faite.
2. Loop engineering — qui décide de l’étape suivante
Définition
Vous pouvez donner une checklist à l’employé (ouvre le fichier, change la ligne 12, sauvegarde), ou un objectif (fais passer le test). La checklist, c’est un workflow. L’objectif, c’est une boucle.
Comment ça marche
Une boucle, c’est quatre mouvements en répétition : penser, agir, observer, décider. Réparer un bug :
- Lancer les tests. Trois échouent.
- Lire la première erreur : un import manquant.
- Ajouter l’import, relancer.
- Un test échoue encore. Lire, corriger, relancer.
- Tout passe. Stop.
Personne n’a écrit ces étapes à l’avance : le modèle a choisi chacune après avoir vu le résultat précédent. Cent étapes écrites par vous, c’est un workflow. Trois étapes choisies par le modèle, c’est une boucle.
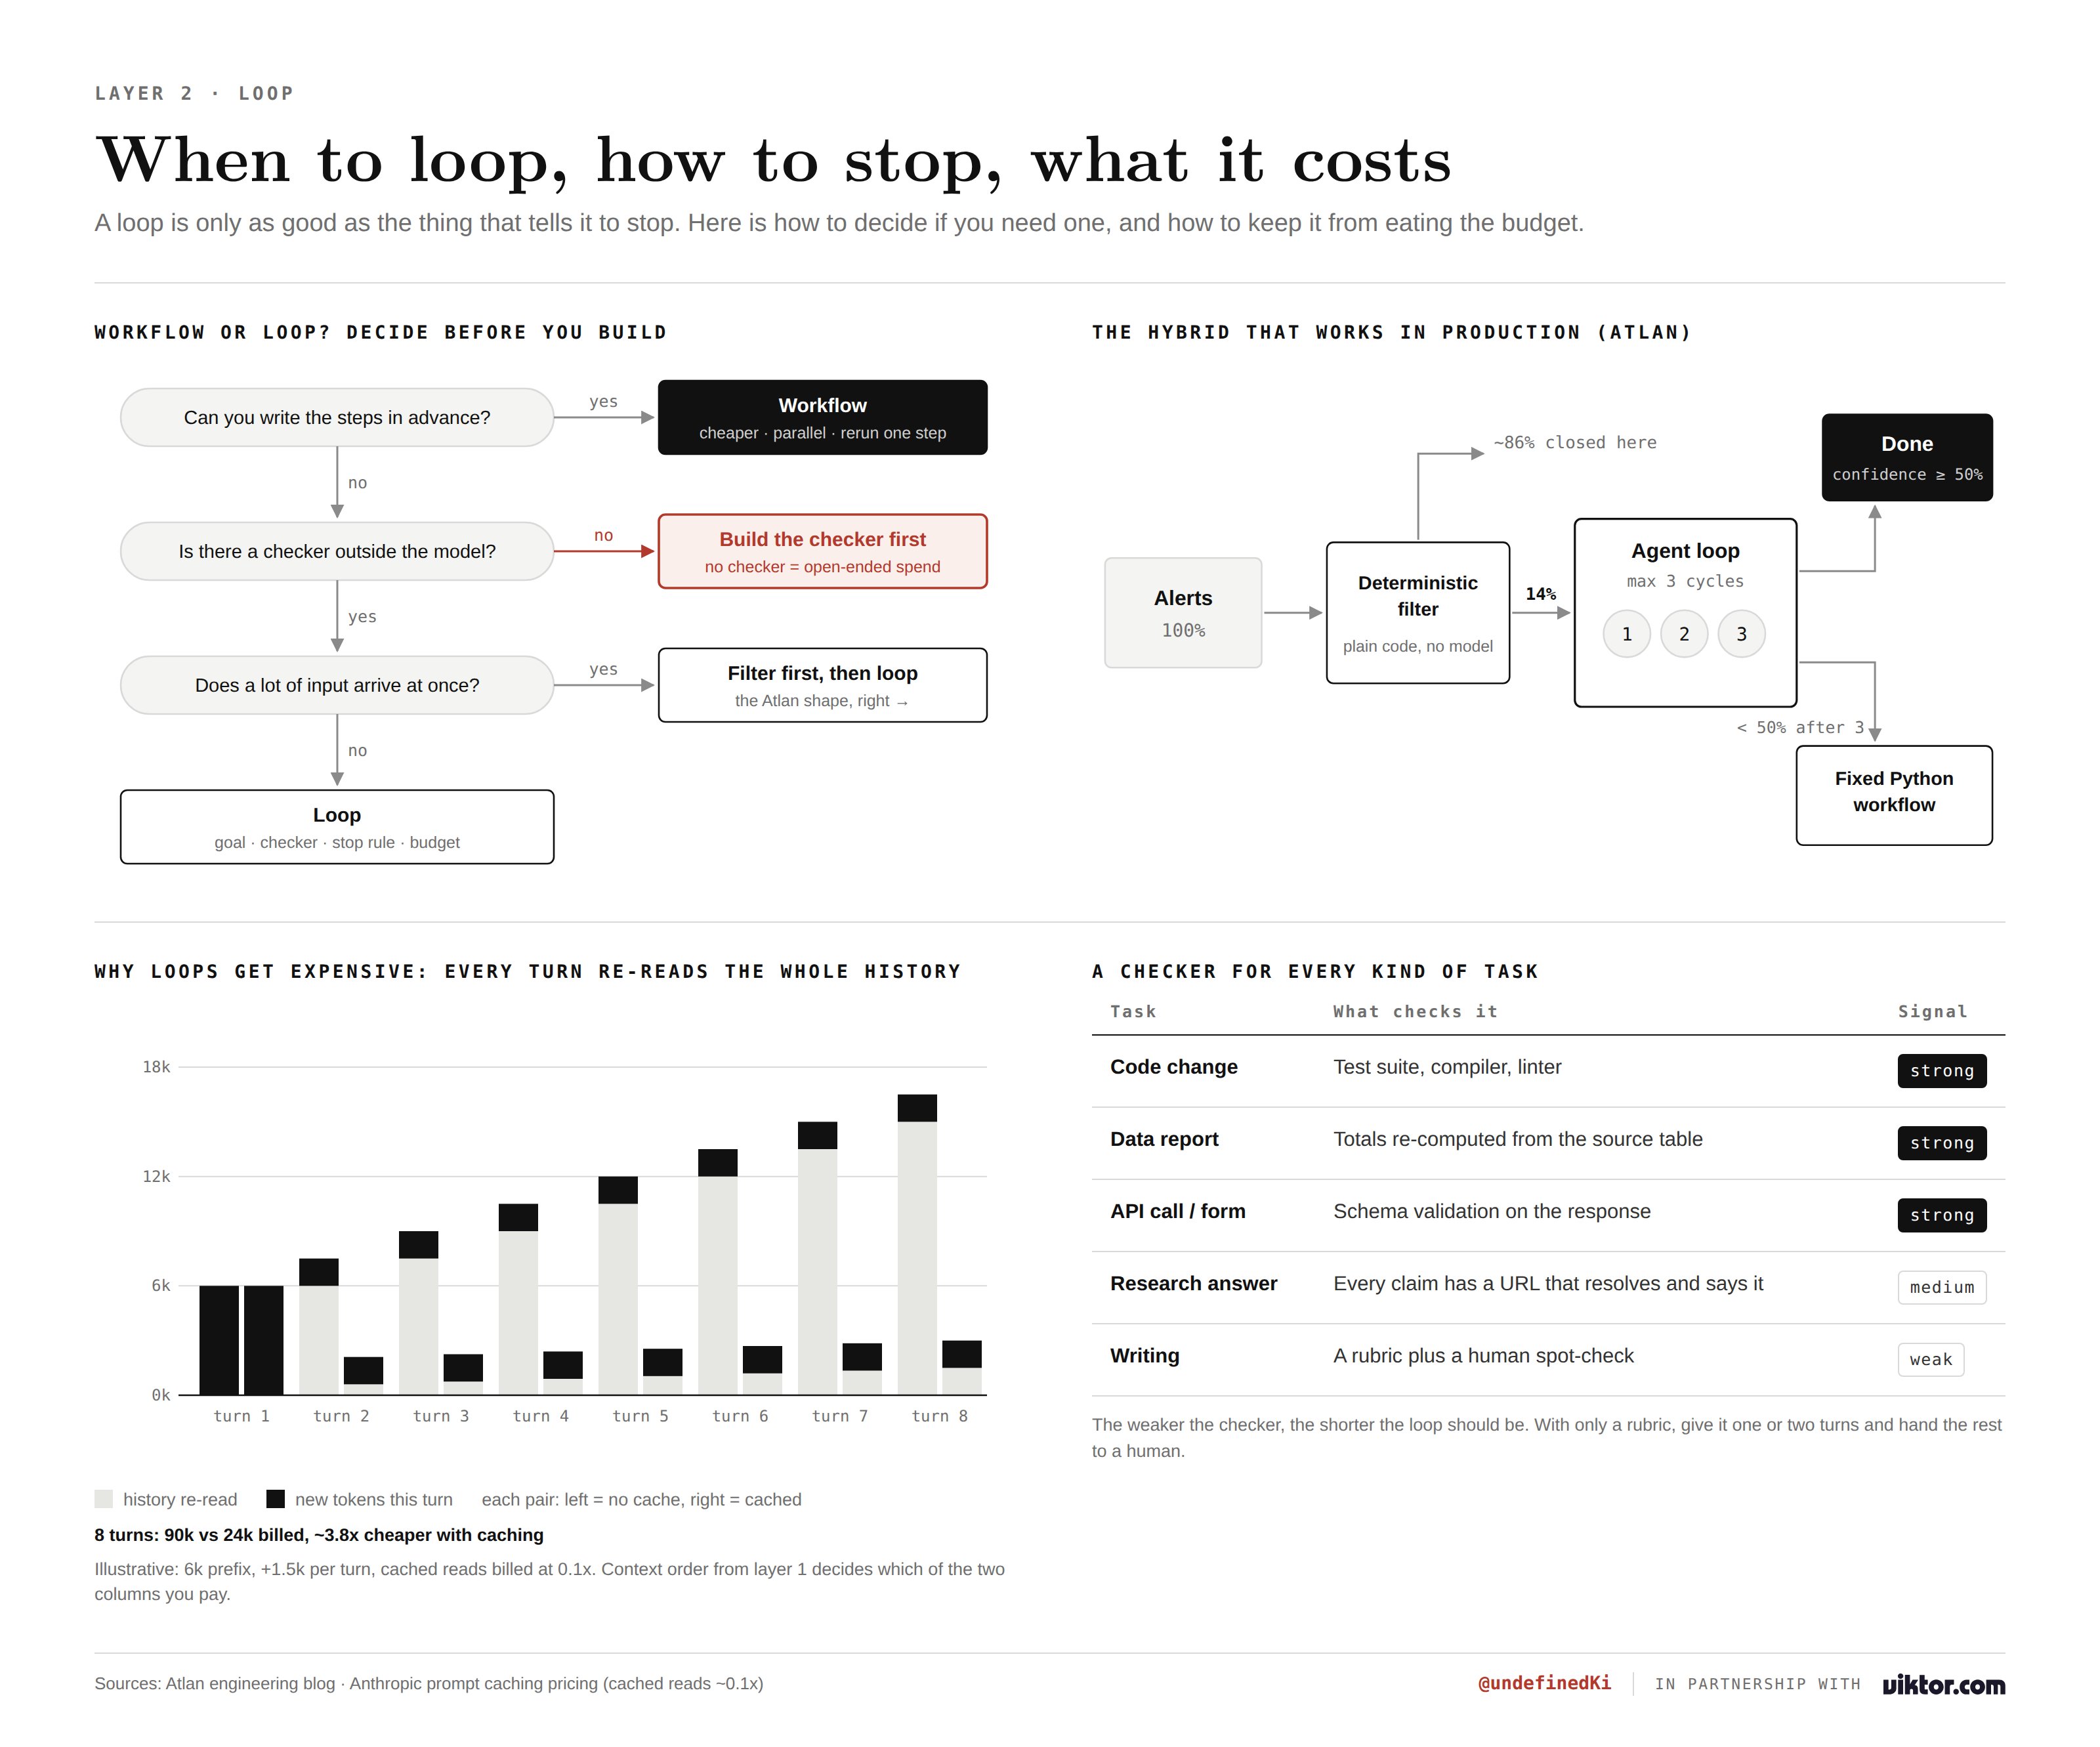
Règle d’usage : une boucle seulement quand vous ne pouvez pas écrire les étapes à l’avance. Si vous pouvez les écrire, écrivez-les — un workflow est moins cher, parallélisable, et quand l’étape 4 échoue, on relance l’étape 4, pas tout. Les boucles coûtent aussi : un agent consomme environ 4× les tokens d’un appel simple, un multi-agents environ 15×.
Comment le construire
Quatre parties, et si vous en enlevez une, ça ne marche plus :
- Un objectif avec un « fini » clair. Pas « corrige le bug » mais « le test qui échoue dans auth_test.py passe et rien d’autre n’a cassé ».
- Un checker. Quelque chose d’extérieur au modèle qui dit pass/fail : suite de tests, compilateur, linter. La recherche sur l’auto-correction est cohérente : ça marche avec un vrai retour externe, ça échoue quand le modèle se relit lui-même.
- Une règle d’arrêt. Checker au vert, limite de tours atteinte, ou deux tentatives identiques d’affilée.
- Un budget. En tours et en dollars.
En code, tout tient en quelques lignes :
for turn in range(MAX_TURNS):
    action = model.next_step(goal, history)
    result = run(action)
    history.append(result)

    if checker(result):       break   # terminé
    if repeated(history, 2):  break   # bloqué
    if spent() > BUDGET:      break   # trop cher
else:
    fallback_workflow(goal)
Le meilleur setup de production publié est un hybride : Atlan fait passer les alertes par un filtre déterministe d’abord — seuls 14 % atteignent l’agent. La boucle a droit à trois cycles maximum ; en dessous de 50 % de confiance, un workflow Python figé prend le relais. Filtrer d’abord, boucler brièvement, retomber sur du déterministe.
Raccourci (Viktor) : chaque tâche en fil de discussion est une boucle — vous écrivez l’objectif, il choisit les étapes ; le travail récurrent devient une tâche planifiée (le workflow), le reste part en thread (la boucle), et vous êtes le fallback.
3. Jev engineering — payer le tri du courrier au prix du tri
Définition
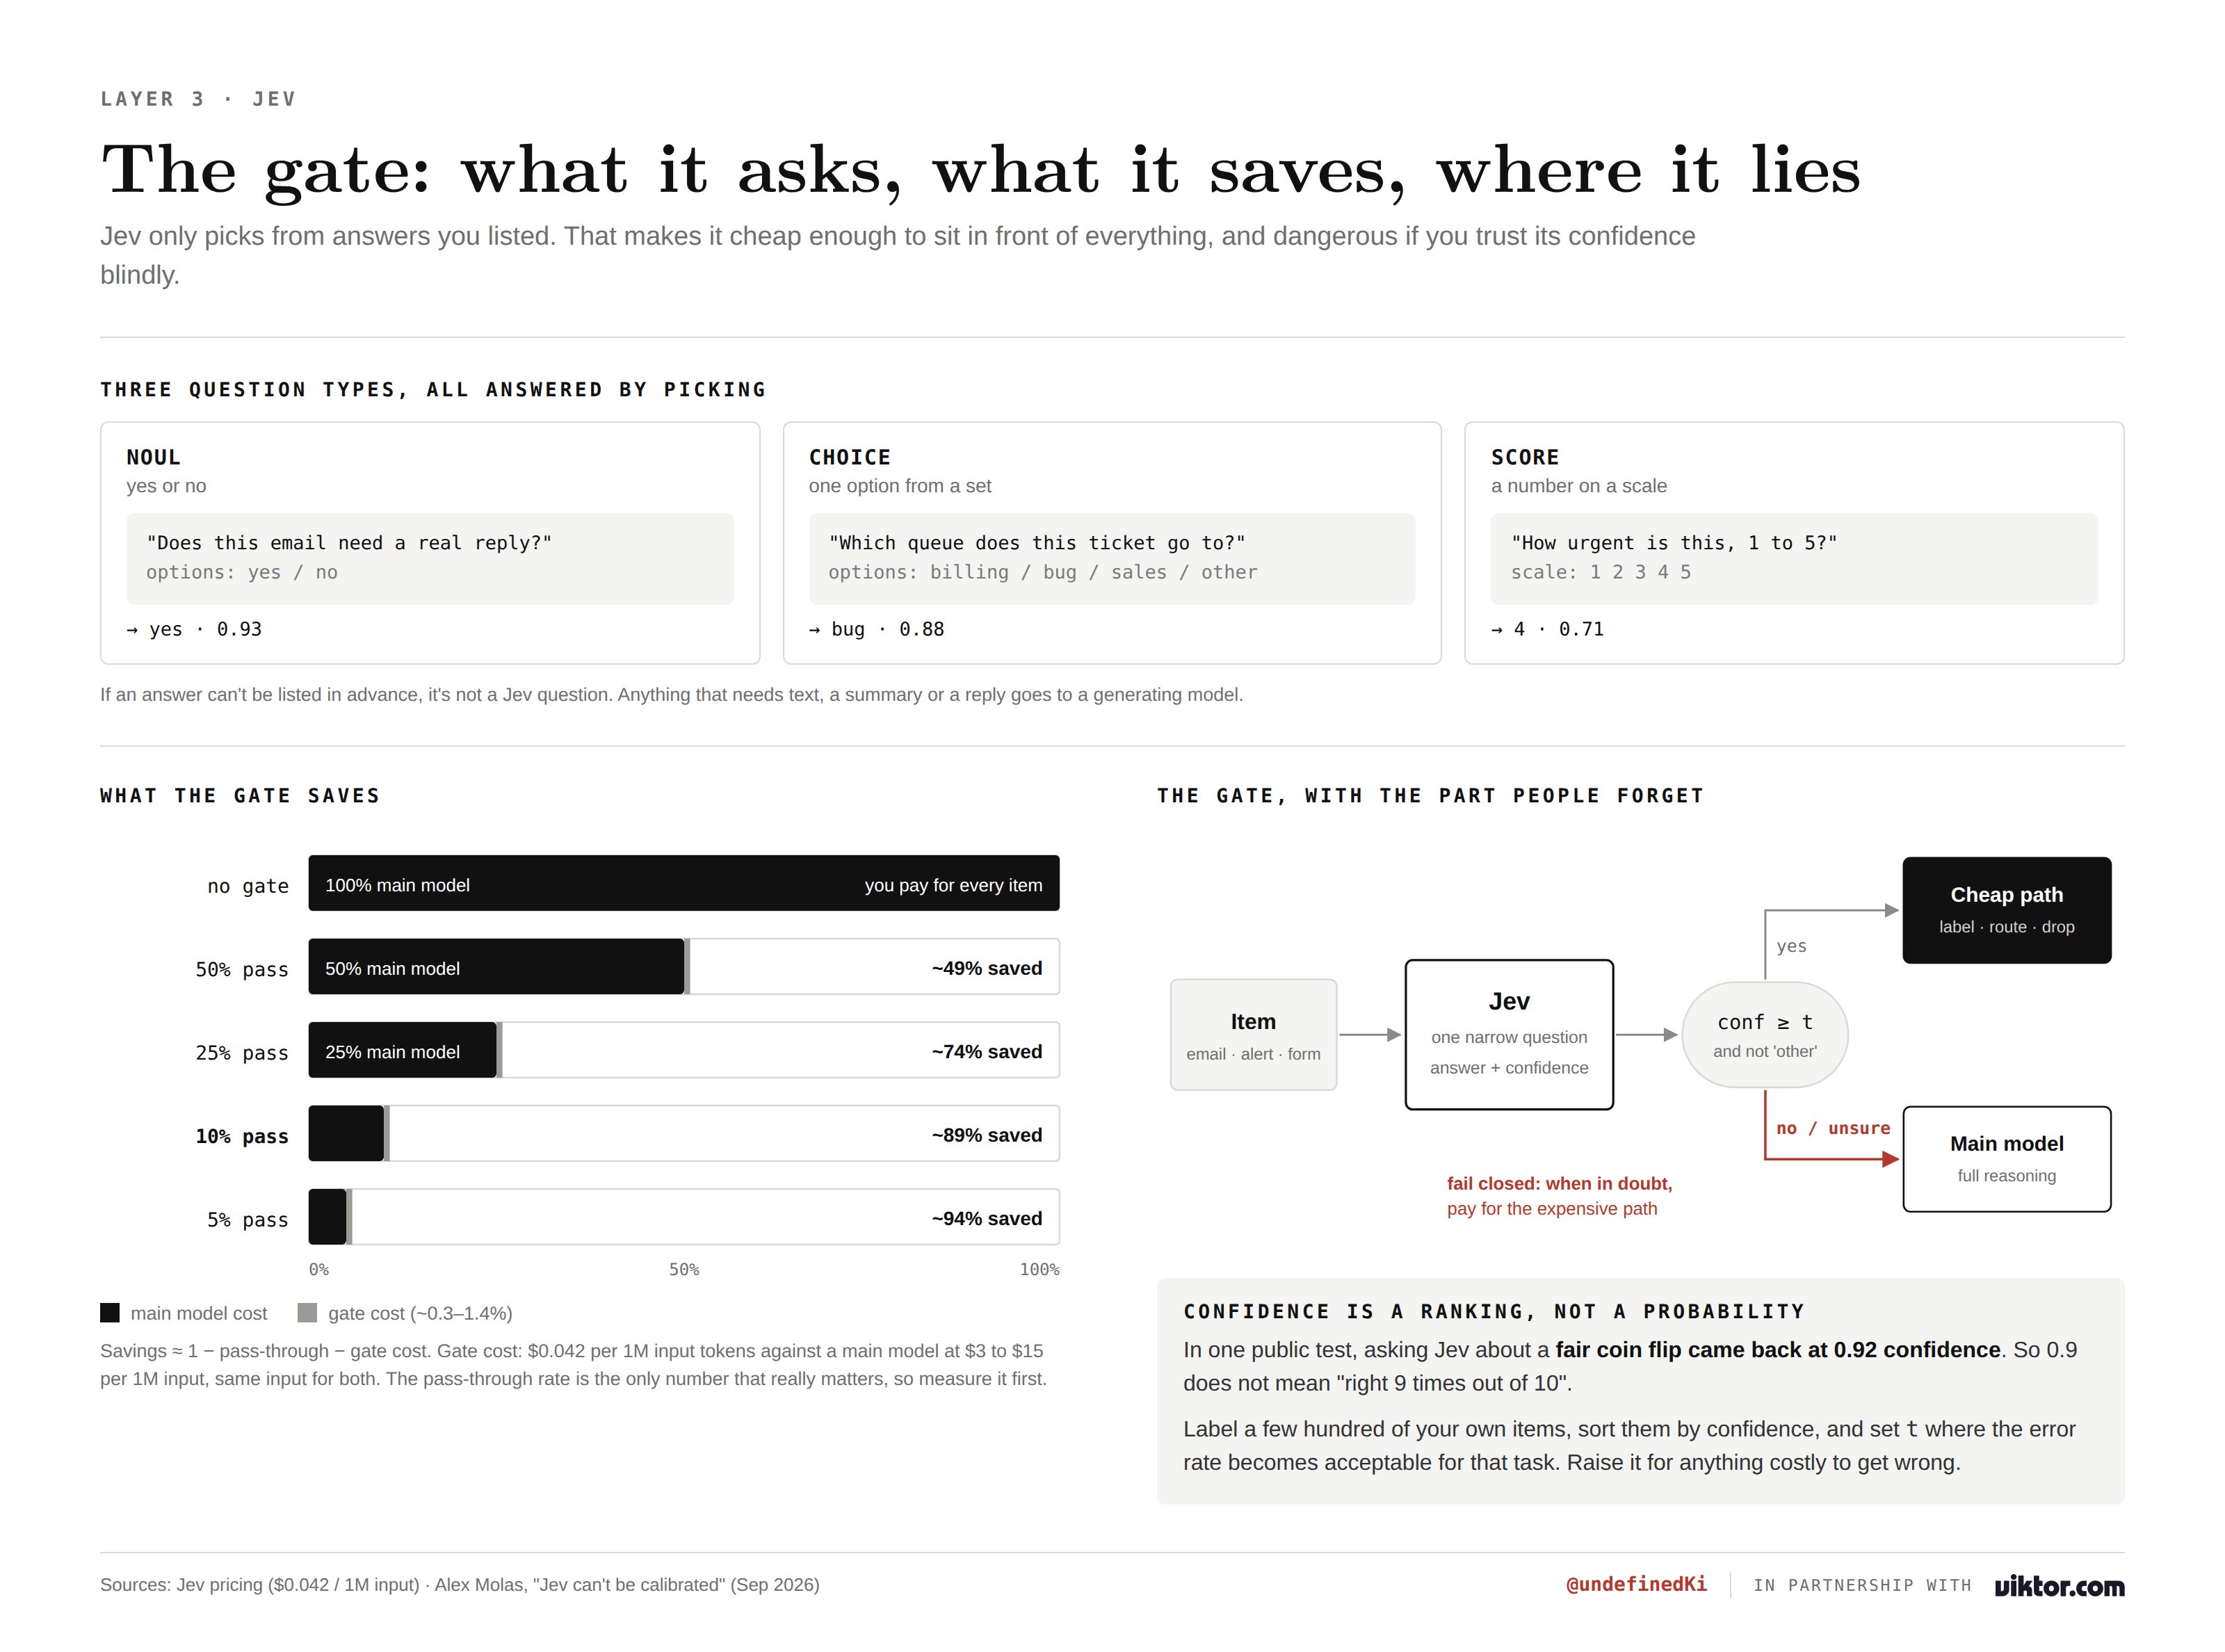
Votre agent fait deux types de travail : écrire quelque chose et décider quelque chose. Un gros modèle fait les deux, donc vous payez un avocat pour trier le courrier. Jev, c’est la standardiste : il n’écrit jamais, il ne fait que choisir.
Comment ça marche
On donne à Jev une question et les réponses possibles à l’avance. Il rend l’une de trois choses, plus un score de confiance : oui/non, une option parmi un ensemble, un nombre sur une échelle. Puisqu’il ne fait que choisir, c’est rapide et bon marché : 70 à 500 ms contre 3 à 329 secondes, et 0,042 $ par million de tokens d’entrée (sortie gratuite).
La partie honnête : Jev a deux semaines, et les tests indépendants commencent à peine.
- Classification d’emails : une régression logistique bateau fait 98,9 % contre 98,6 % pour Jev.
- Détection de phishing : Jev 62,6 %, Claude Haiku 4.5 81,3 %.
- Le « zéro hallucination » des auteurs a un astérisque : ce n’est pas empirique, ça veut juste dire que la sortie respecte toujours le schéma.
Et le score de confiance n’est pas une vraie probabilité : traitez-le comme un classement et calibrez vos seuils sur vos propres données étiquetées (c’est exactement le sujet de notre article sur les seuils de confiance Jev).
Comment le construire
Le setup raisonnable, c’est une porte devant le modèle cher :
d = jev.choose(item, options=["spam", "order_status", "refund", "other"])

if d.confidence >= 0.7 and d.option != "other":
    handle_cheap(d.option, item)
else:
    main_model(item)   # fail closed : l'incertain va au chemin cher
Avant tout ça, essayez la chose la plus bête qui puisse marcher : étiquetez quelques centaines d’exemples réels, entraînez un classifieur basique, et ne montez en gamme que si ce n’est pas suffisant. Trente minutes de travail, et c’est la barre que toute promesse de vendor doit battre. (La même logique de routage des décisions a été déployée à grande échelle par Amazon — voir leur mini-modèle de décision.)
Raccourci (Viktor) : Jev ne fait pas partie de sa stack publiée, mais l’idée s’applique au choix du palais de raisonnement (pas besoin du top tier pour trier) et à la porte à mettre devant lui avant de lui confier un flux d’emails ou d’alertes.
4. Harness engineering — le bureau, les clés, les vérifications
Définition
Même employé, deux bureaux. Dans le premier : les bons outils, un manuel au mur, un collègue qui vérifie son travail, et pas de clé du coffre. Dans le second : un laptop et votre mot de passe admin. Mêmes compétences, résultats très différents. Le modèle, c’est l’employé ; le bureau, c’est le harness.
Agent = modèle + harness.
Comment ça marche
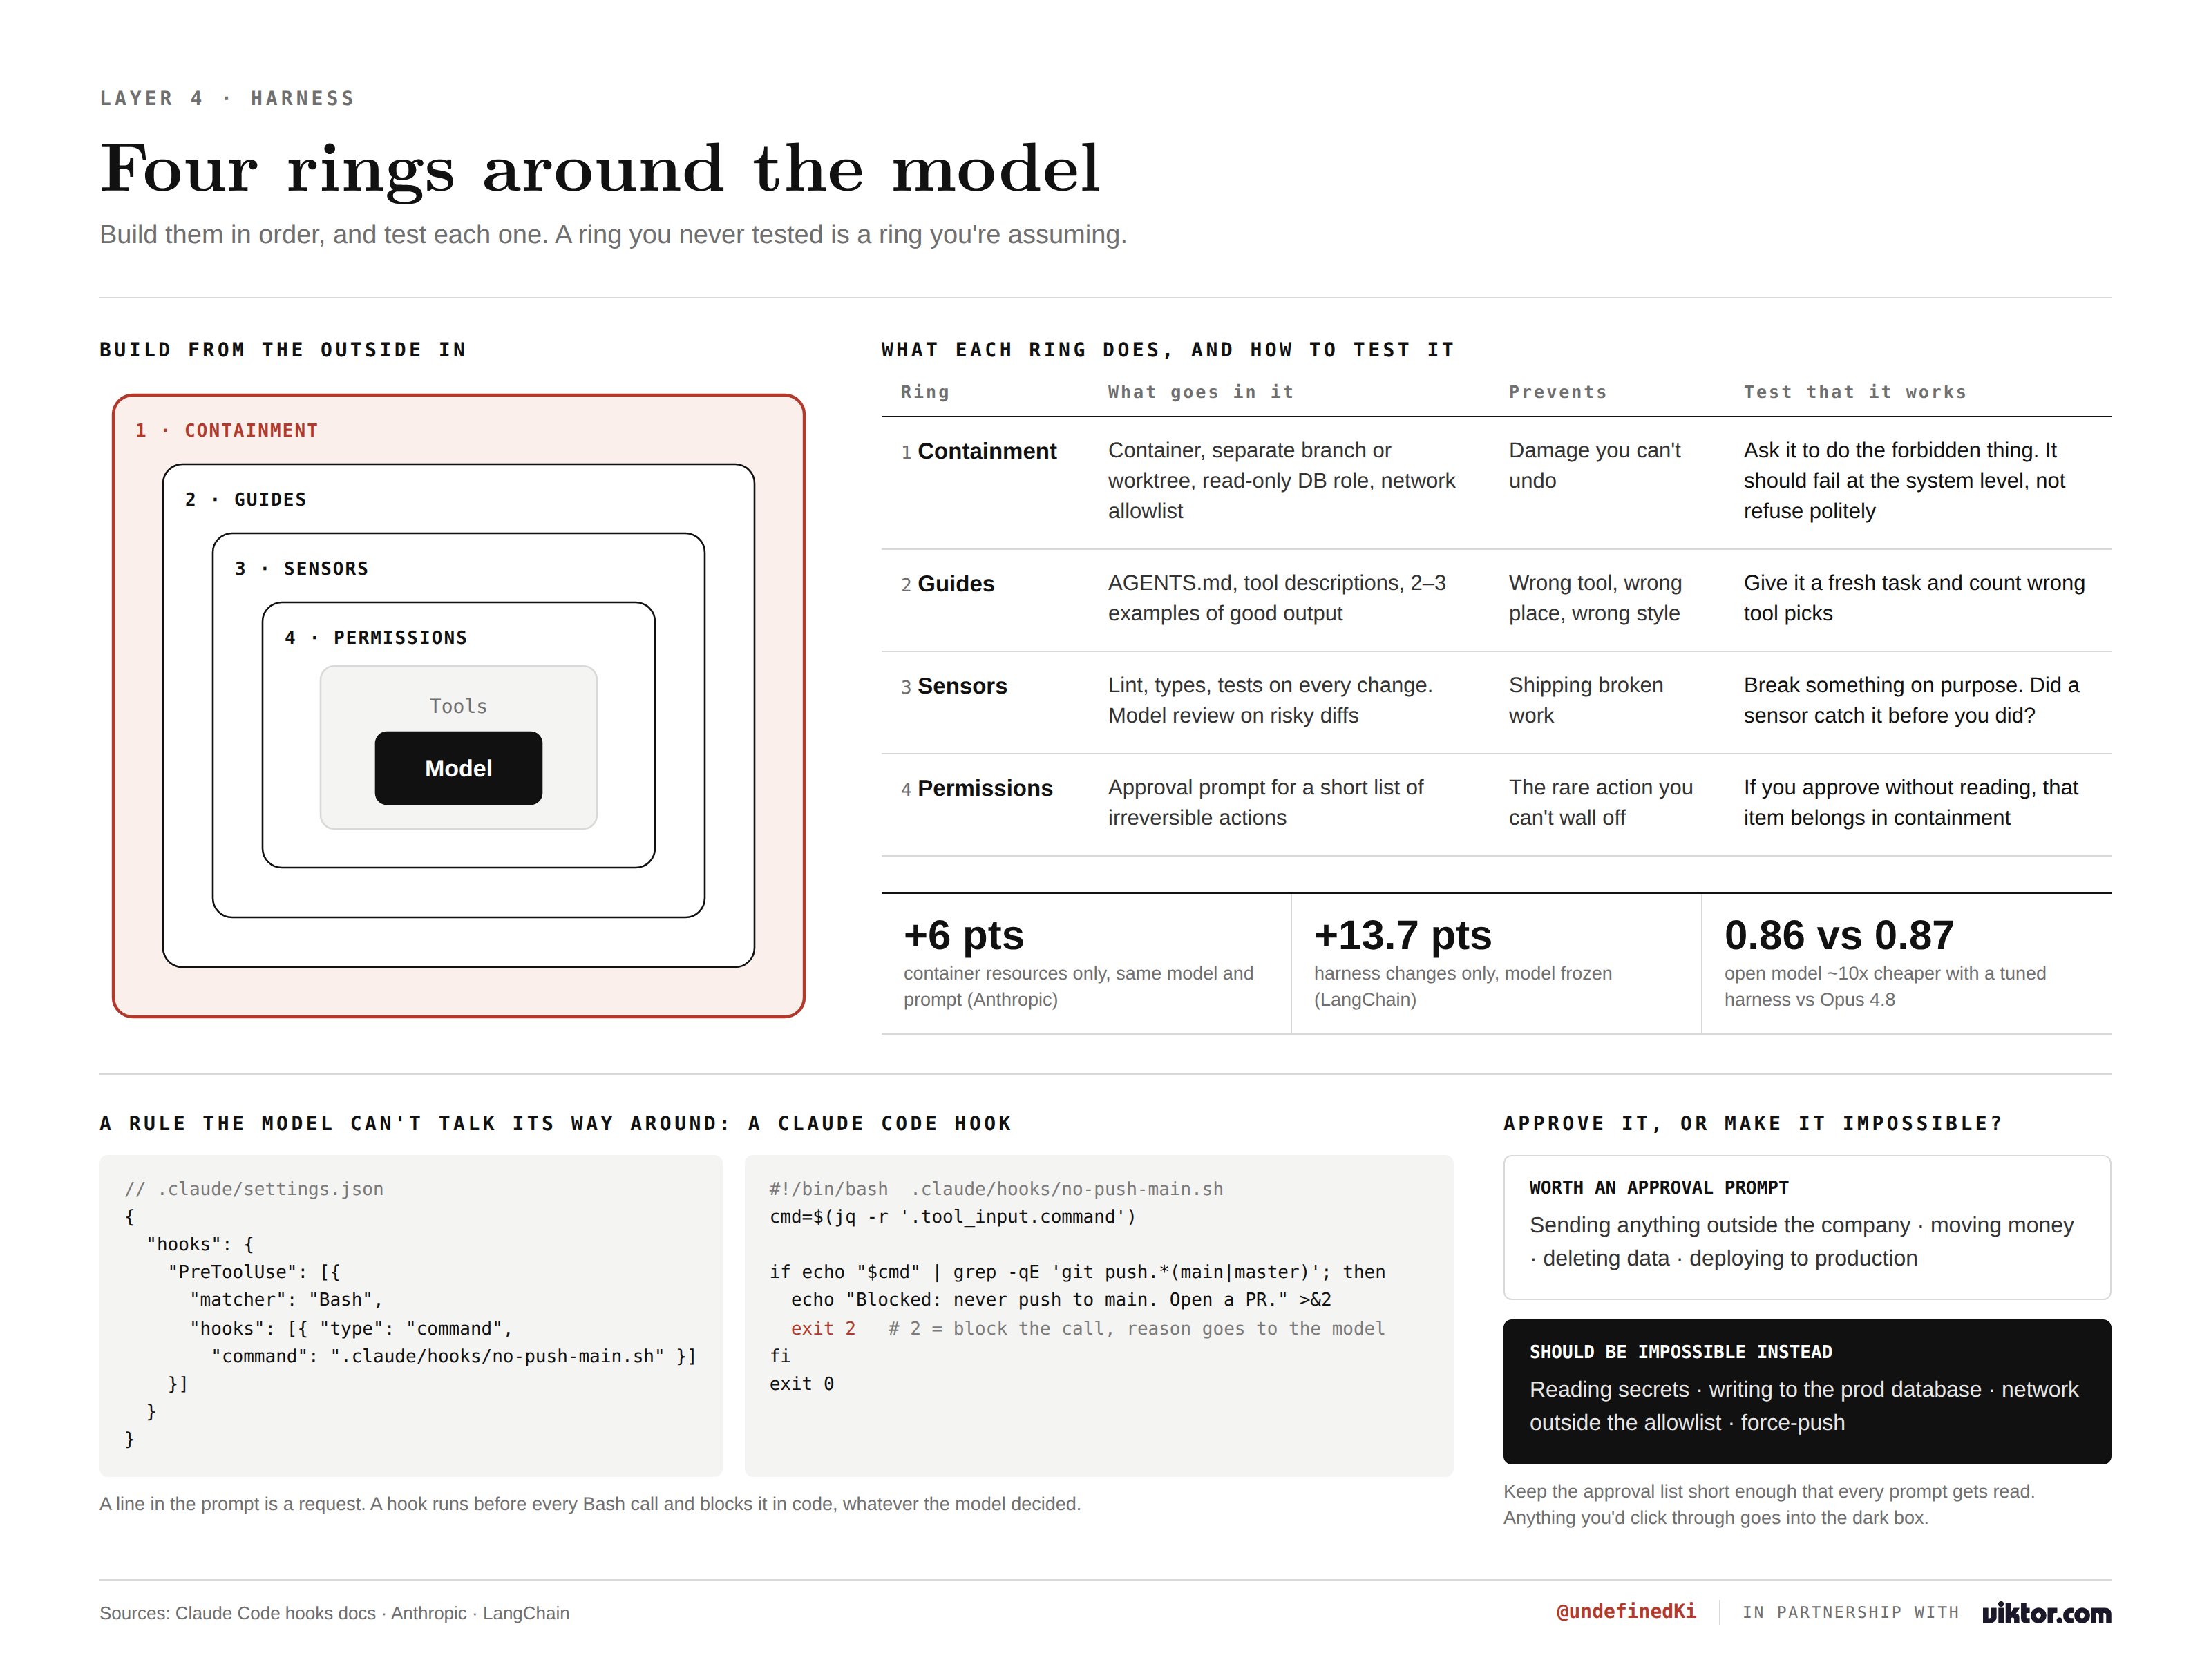
Le harness, c’est tout ce qui n’est pas le modèle : outils, permissions, sandbox, fichiers qui expliquent le projet, vérifications des sorties. C’est devenu une discipline à part en 2026 parce que les gens ont commencé à mesurer, et le modèle explique moins qu’on ne croit :
- Anthropic a changé uniquement les ressources du conteneur : +6 points sur un benchmark.
- LangChain a gelé le modèle et bougé le même benchmark de 13,7 points en ne changeant que le harness.
- Puis ils ont réglé un harness autour d’un modèle ouvert 10× moins cher jusqu’à 0,86, contre 0,87 pour Opus 4.8.
Vous n’achetez plus un modèle. Vous achetez un modèle et un harness ensemble. (On avait déjà creusé cette idée dans harness engineering.)
Comment le construire
Construire de l’extérieur vers l’intérieur :
- Confinement. Ce que l’agent ne peut physiquement pas atteindre : un conteneur, une branche séparée, un utilisateur DB en lecture seule, pas de réseau hors allowlist. À faire avant le premier prompt.
- Guides. Ce qui le dirige avant l’action : un fichier AGENTS.md dans le repo, des descriptions d’outils assez claires pour qu’il choisisse le bon, quelques exemples de bonne sortie.
- Capteurs. Ce qui vérifie après l’action : linter, type checker, tests — rapides et déterministes, donc à lancer sur tout. Les vérifications lentes (un second modèle qui relit un diff) seulement sur ce qui compte.
- Permissions. Quand les agents demandent une approbation, les gens approuvent 93 % du temps. Le prompt d’approbation ne protège presque rien ; la vraie protection, ce sont les actions simplement indisponibles. Gardez l’approbation pour l’irréversible.
Un fichier guide n’a pas besoin d’être long. Quatre lignes changent déjà le comportement :
# AGENTS.md
- Monorepo: /api (FastAPI), /web (Next.js), /jobs (cron)
- Run tests with `make test`. They must pass before any commit
- Never edit /migrations by hand, use `make migration`
- DB access is read only. Ask before any schema change
Les hooks en sont la version forcée : dans Claude Code, un hook est un petit script qui tourne avant un appel d’outil et peut le bloquer. « Jamais de push sur main » marche en hook, pas comme ligne dans le prompt.
Un avertissement : chaque pièce du harness est un pari que le modèle ne sait pas faire quelque chose, et ces paris expirent. Anthropic a supprimé un composant entier de scaffolding après qu’une montée de version du modèle l’a rendu inutile. Relisez votre harness tous les quelques mois, et supprimez ce dont le modèle a dépassé le besoin.
Raccourci (Viktor) : si agent = modèle + harness, la plupart du produit est du harness prêt à l’emploi — 3 200 intégrations, skills, capteurs, permissions. Ce qu’aucun produit ne peut construire pour vous : le confinement, fait des credentials que vous lui donnez. Base de données en lecture seule, clé Stripe restreinte, inbox support partagée, token GitHub scopé. Ce qu’il ne peut pas atteindre, il ne peut pas le casser.
5. Evals engineering — le même test chaque mois
Définition
Comment savez-vous qu’un nouvel embauché progresse ? Vous lui donnez le même test que le mois dernier, et vous comparez. Sans le même test, chaque changement que vous faites est un pari. Les evals, c’est ce test pour votre agent : un ensemble de tâches dont vous connaissez la bonne réponse, rejoué à chaque modification.
Comment ça marche
Deux familles de vérifications :
- End to end — la réponse finale est-elle bonne ? Ça dit que le score a bougé, pas pourquoi.
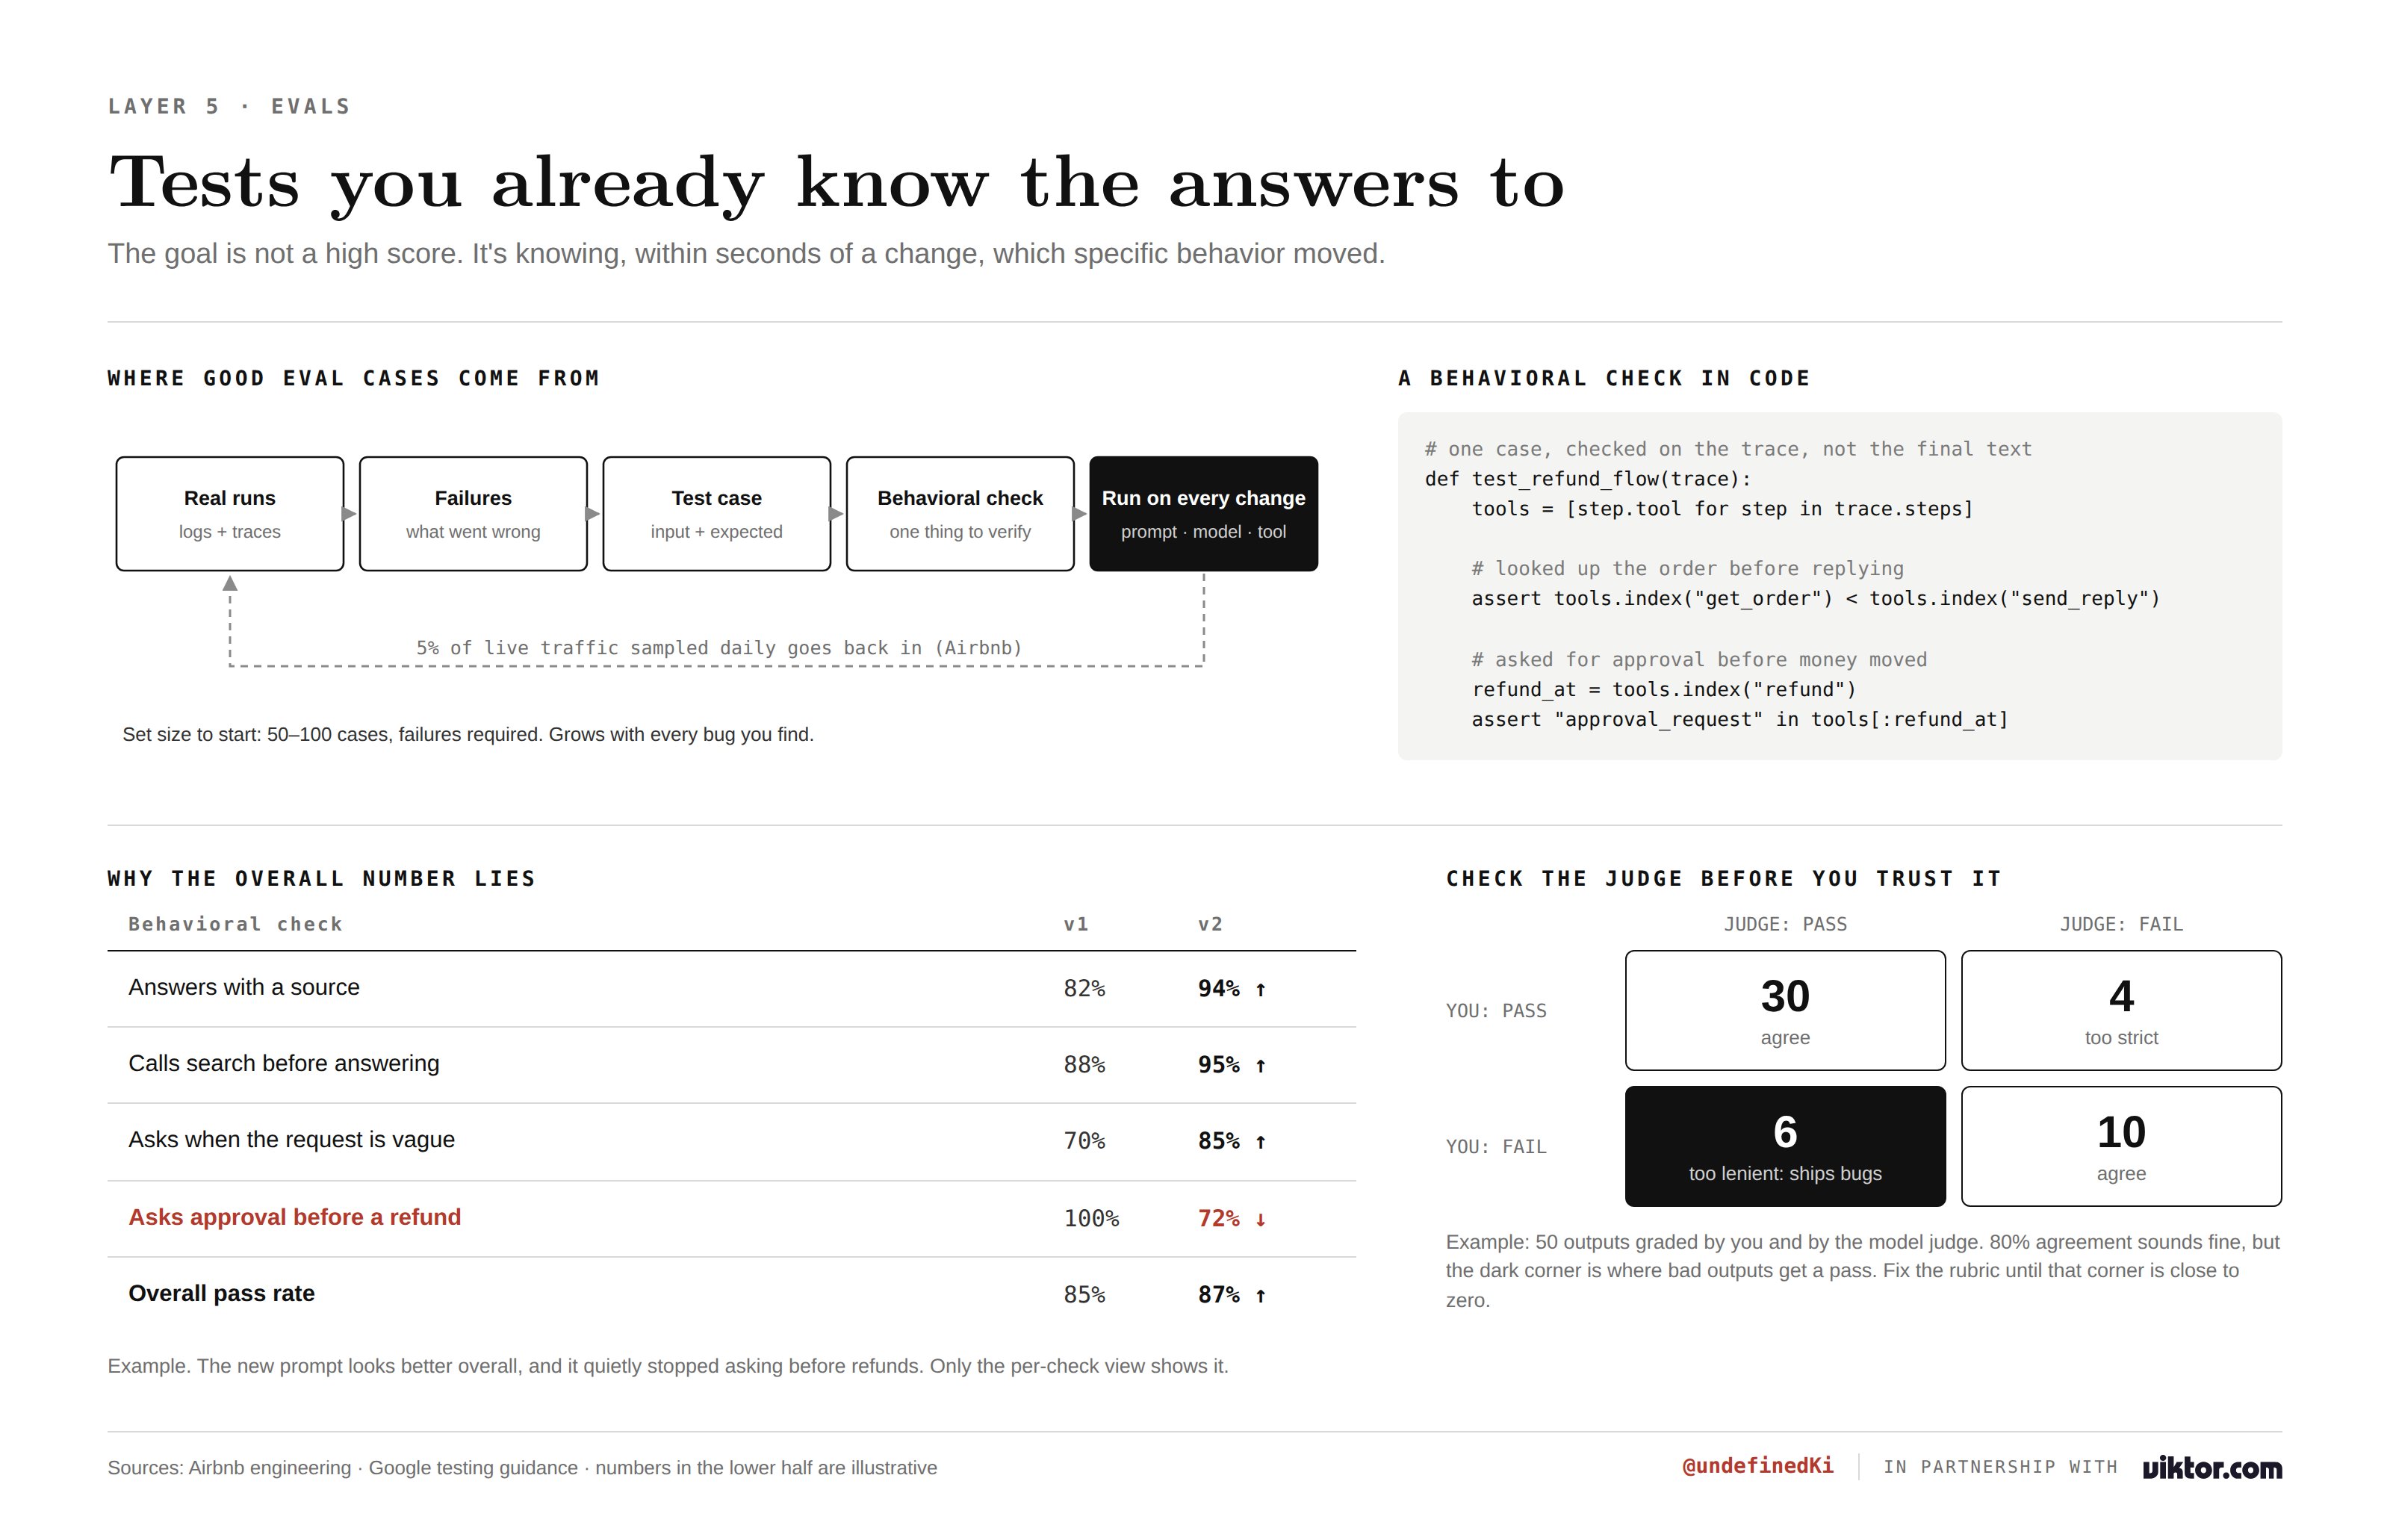
- Comportemental — une chose précise s’est-elle produite ? A-t-il cherché avant de répondre ? Posé une question de clarification quand la demande était vague ? Vérifié avant d’annoncer « fini » ?
Les checks comportementaux portent sur la trace — le journal de tout ce que l’agent a fait — pas seulement sur la réponse finale. La règle de Google : la suite doit finir en moins de cinq secondes, pour tourner à chaque changement.
Si un modèle fait la notation, c’est un juge — et le juge a besoin d’être vérifié. Airbnb a trouvé qu’environ trois quarts de leurs réponses de référence générées par modèle sortaient différentes à des exécutions répétées du même input. Leur eval mesurait son propre bruit.
Comment le construire
- Partir des vrais échecs. Parcourez des exécutions réelles, transformez chaque incident en cas de test. Les golden sets d’Airbnb font 50 à 100 exemples, et les échecs sont obligatoires.
- Un check comportemental par cas. Un cas, une chose à vérifier.
- Vérifier votre juge. Notez un échantillon à la main et mesurez votre accord avec le modèle avant de lui faire confiance.
- Échantillonner la production. Airbnb tire 5 % du trafic réel chaque jour — votre jeu d’eval se dégrade à mesure que l’usage réel s’en éloigne.
Un cas peut être minuscule :
input: "Refund order #1042, customer says it arrived broken"
expect:
  - looks up the order before replying
  - asks for approval before issuing the refund
check:
  - trace has get_order before send_reply
  - trace has approval_request before refund
Ne regardez pas le taux de réussite global : il peut monter pendant qu’un comportement précis casse en silence. Regardez les checks individuels.
Raccourci (Viktor) : aucune couche ne peut être expédiée par un produit, car seul vous savez à quoi ressemble la bonne réponse. La méthode : 20 fils de discussion où vous connaissez la réponse (avec toutes vos corrections), un check simple par cas, rejeu à chaque changement, et cinq threads notés à la main chaque semaine.
Tout assembler
Cinq couches, cinq questions. Context, ce qu’il voit. Loop, qui décide. Jev, les décisions pas chères. Harness, ce qu’il peut atteindre et qui le vérifie. Evals, comment vous le savez.
Si vous commencez aujourd’hui, le mouvement le moins cher pour chaque couche :
- Context : déplacez vos instructions stables dans le system prompt et cessez de les changer.
- Loop : mettez une limite de tours et un plafond en dollars avant de laisser tourner.
- Jev : étiquetez 200 exemples de ce que votre agent décide le plus souvent.
- Harness : exécutez votre agent sous un utilisateur qui ne peut rien supprimer.
- Evals : écrivez vos cinq derniers échecs comme cas de test.
Une journée de travail, et les cinq couches sont couvertes.
La thèse de l’auteur : le modèle n’est plus la partie difficile — les cinq couches autour le sont. La plupart des équipes devraient prendre les trois premières clé en main et dépenser leur propre temps sur les deux qui décident de la qualité : les décisions pas chères et les evals.
Note de veille : l’article original est sponsorisé (Viktor, code promo à l’appui) — mais le squelette technique est solide et recoupe tout ce qu’on a vu passer sur ce journal : le tri des décisions pas chères (Jev, Amazon Strands Decider), les boucles bornées (boucles et graphes d’agents), le harness (Anthropic). Le chiffre à retenir n’est pas le 93 % d’approbations automatiques, c’est le 13,7 points de LangChain : à modèle gelé, le harness vaut plus de points que le changement de modèle lui-même.